ISEF 白皮书 · 2027 赛季准备版
第七章 从历届数据认识 ISEF
浏览本章 14 个小节
- 7.1 这批数据能回答什么
- 7.2 十三年的记录,为什么不能连成一条简单的获奖率曲线
- 7.3 先分清学科大奖与专项奖
- 7.4 22 个学科的规模与变化
- 7.5 方法变化:计算越来越常见,工程迭代并没有消失
- 7.6 技术趋势告诉我们应该学什么,而不是应该买什么
- 7.7 摘要越来越常写指标,但数字不等于验证充分
- 7.8 36 个主题簇:用来找邻居,不是新的官方分类
- 7.9 世界地图:先看到选拔系统,再看获奖比例
- 7.10 中国相关记录:年际变化比一个平均数更值得注意
- 7.11 美国各州和附属赛事:一张地图里有多个层级
- 7.12 获奖关联为什么不能当作选题公式
- 7.13 题目相似、持续研究与创新性
- 7.14 把数据读成自己的下一步
7.1 这批数据能回答什么
当学生问“哪个方向更容易做出好项目”时,历届作品很有帮助。它们告诉我们已经有人研究过什么,常用什么方法,以及同一个问题可以怎样被拆分。但若把问题换成“我报哪个类别最容易获奖”,同一批数据就很容易被误用。
本章依据我们整理的 Society for Science 官方摘要档案,共 17,565 个唯一项目记录,覆盖 2014—2026 年。其中 2022—2026 年有 6,755 个项目,适合观察近期学科与地区构成。数据快照来自 2026 年 8 月的档案整理,本书在 2026 年 9 月复核来源、分类和统计口径。官方摘要数据库
我们拿到的是公开项目档案,其中没有全部地方赛报名者和未晋级项目,也没有评委原始评分或完整研究日志。因此,这些记录能说明决赛项目的构成;至于一名普通学生怎样晋级、评委为何给出某个分数,需要另外的资料。
一个团队项目只算一个项目。学生人次是另一个单位:同一个人跨年参赛可能重复出现,一队也可能有多名成员。一个项目获得多个奖,仍然只在“获奖项目数”中计一次。阅读数据时,先弄清这些单位,比记住某个百分比更重要。
本章附有可下载的汇总表:年度数据、学科数据、国家地区数据。表中的数值由同一份规范化记录生成,不是从不同报告手工拼接。
7.2 十三年的记录,为什么不能连成一条简单的获奖率曲线
| 年份 | 项目档案 | 学科大奖项目 | 说明 |
|---|---|---|---|
| 2014 | 1394 | 335 | 公开档案中可识别的学科大奖 |
| 2015 | 1347 | 276 | 公开档案中可识别的学科大奖 |
| 2016 | 1371 | 293 | 公开档案中可识别的学科大奖 |
| 2017 | 1403 | 369 | 公开档案中可识别的学科大奖 |
| 2018 | 1390 | 341 | 公开档案中可识别的学科大奖 |
| 2019 | 1426 | 351 | 公开档案中可识别的学科大奖 |
| 2020 | 1027 | NA | 比赛取消;保留档案记录 |
| 2021 | 1452 | 373 | 公开档案中可识别的学科大奖 |
| 2022 | 1400 | 372 | 公开档案中可识别的学科大奖 |
| 2023 | 1316 | 364 | 公开档案中可识别的学科大奖 |
| 2024 | 1345 | 365 | 公开档案中可识别的学科大奖 |
| 2025 | 1328 | 367 | 大奖以官方名单补充;专项奖缺失 |
| 2026 | 1366 | 366 | 公开档案中可识别的学科大奖 |
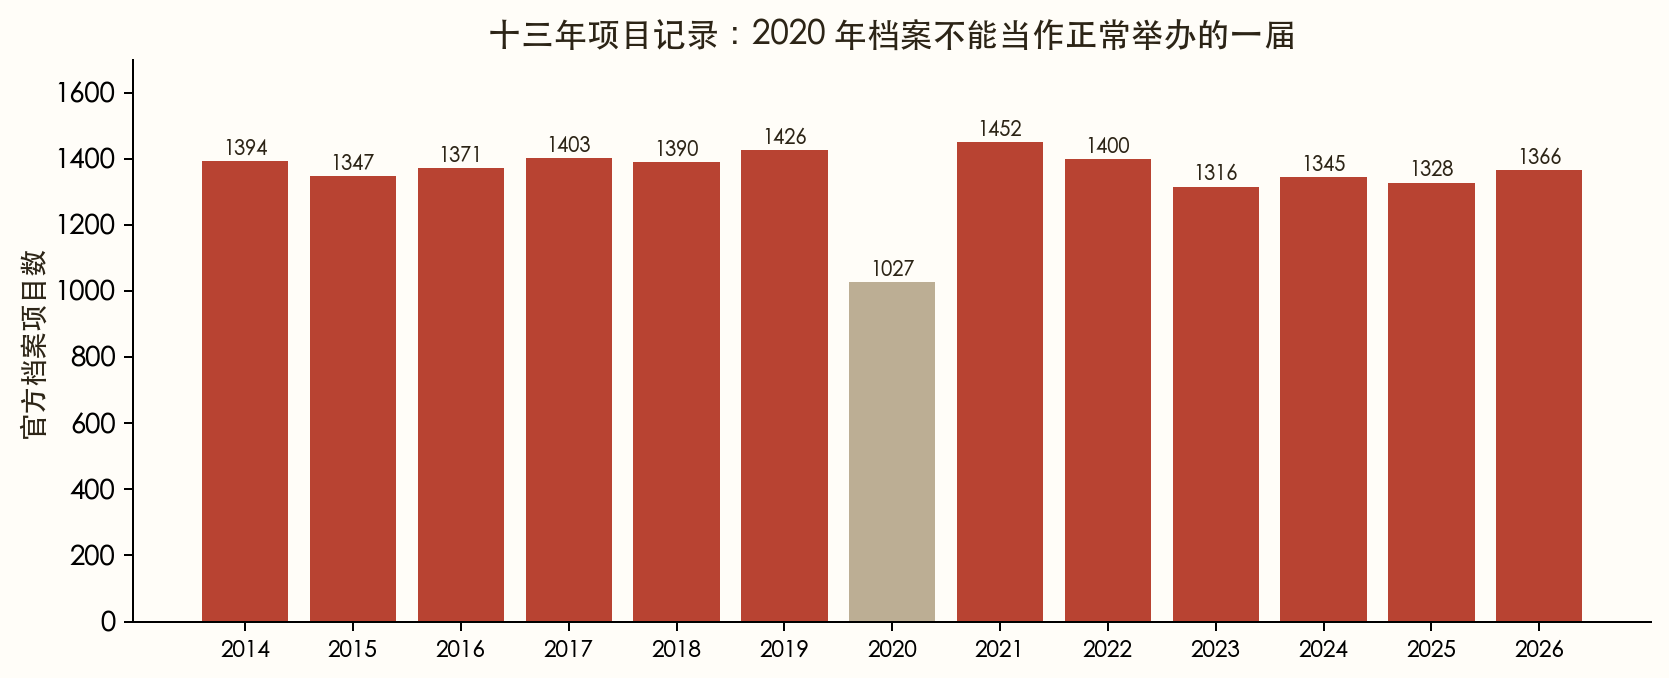
图中的数量是档案记录,不是每届新闻报道中的学生人数。2020 年比赛取消,但数据库仍保留相关项目记录,所以本书保留这一年的研究文本,同时将获奖分析标为不适用。把这一年写成“获奖率为零”,会错误地暗示项目经过正常评审却无人得奖。2020 年取消比赛的官方说明
2025 年是另一种情况。官方摘要库中的奖项字段不足以直接恢复当年完整结果,我们使用已匹配的官方公布名单补充学科大奖。专项奖的来源缺口仍在,因此不能把 2025 年专项奖空值写成确实没有获奖,也不宜用“任何奖项”的比例与其他年份直接比较。
早年专项奖记录较少,也可能部分反映来源覆盖差异。若看到某几年“任何奖项”突然增加,先检查采集与分类方式,再讨论比赛变化。本书因此把时间趋势主要放在项目规模和文本内容上,避免用一条混合奖项曲线讲述未经证实的竞争故事。
自己的数据表出现空白时,也应注明是没有发生、没有测量,还是测量失败。三个空白的含义不同,后续分析也不同。
7.3 先分清学科大奖与专项奖
学科大奖与机构颁发的专项奖承担不同的评价任务。本书统计“学科大奖项目”时,识别官方类别评审的一至四等奖及历史类别最佳奖记录,并使用 2025 年官方名单补充;同一项目不因获得多个层级的奖而重复计数。这个口径不把机构奖项中的 “First Award” 自动归为学科一等奖。
复核旧报告时,我们发现过一个会改变结论的分类错误。部分旧地区分析使用奖项名称中的词语搜索,误把类似“某机构:First Award”算入学科大奖。我们逐条对照后发现,2022—2026 年有 179 个项目在这种旧分类下被计入,却没有被规范化的学科大奖规则识别。因此,本章与那些旧报告的比例可能不同,不应继续混用。
另一个区别是 2025 年:旧地区报告为了回避奖项缺失,剔除了整年;本章的五年学科大奖表采用补充后的记录,将其纳入分母。分类规则与时间窗都改变了,只对比两个百分比的高低会让人误解为比赛结果发生变化。分类差异核对表
按这里的规则,2022—2026 年观察到 1,834 个学科大奖项目,占 6,755 个档案项目约 27.2%。这是这批决赛记录中的观察比例。这个分母不包含所有地方赛报名者,因此不能用来预测一名新学生从报名到获奖的机会。
7.4 22 个学科的规模与变化
| 代码 | 学科 | 2022 | 2023 | 2024 | 2025 | 2026 | 合计 |
|---|---|---|---|---|---|---|---|
| ANIM | 动物科学 | 75 | 55 | 51 | 53 | 54 | 288 |
| BCHM | 生物化学 | 41 | 37 | 38 | 37 | 44 | 197 |
| BEHA | 行为与社会科学 | 72 | 58 | 58 | 73 | 57 | 318 |
| BMED | 生物医学与健康科学 | 84 | 65 | 91 | 87 | 69 | 396 |
| CBIO | 计算生物学与生物信息学 | 75 | 67 | 57 | 77 | 92 | 368 |
| CELL | 细胞与分子生物学 | 41 | 57 | 47 | 50 | 43 | 238 |
| CHEM | 化学 | 73 | 65 | 70 | 46 | 67 | 321 |
| EAEV | 地球与环境科学 | 90 | 82 | 99 | 69 | 69 | 409 |
| EBED | 嵌入式系统 | 41 | 43 | 41 | 43 | 49 | 217 |
| EGSD | 能源:可持续材料与设计 | 52 | 60 | 50 | 48 | 51 | 261 |
| ENBM | 生物医学工程 | 81 | 83 | 82 | 82 | 98 | 426 |
| ENEV | 环境工程 | 98 | 86 | 81 | 78 | 88 | 431 |
| ETSD | 工程技术:静力学与动力学 | 82 | 69 | 75 | 56 | 55 | 337 |
| MATH | 数学 | 39 | 42 | 37 | 41 | 39 | 198 |
| MATS | 材料科学 | 55 | 56 | 54 | 67 | 82 | 314 |
| MCRO | 微生物学 | 63 | 65 | 41 | 58 | 44 | 271 |
| PHYS | 物理与天文学 | 74 | 66 | 69 | 75 | 81 | 365 |
| PLNT | 植物科学 | 54 | 57 | 66 | 55 | 50 | 282 |
| ROBO | 机器人与智能机器 | 85 | 76 | 82 | 69 | 61 | 373 |
| SFTD | 软件设计 | 59 | 47 | 54 | 58 | 61 | 279 |
| TECA | 技术增强艺术 | — | — | 21 | 20 | 20 | 61 |
| TMED | 转化医学 | 66 | 80 | 81 | 86 | 92 | 405 |
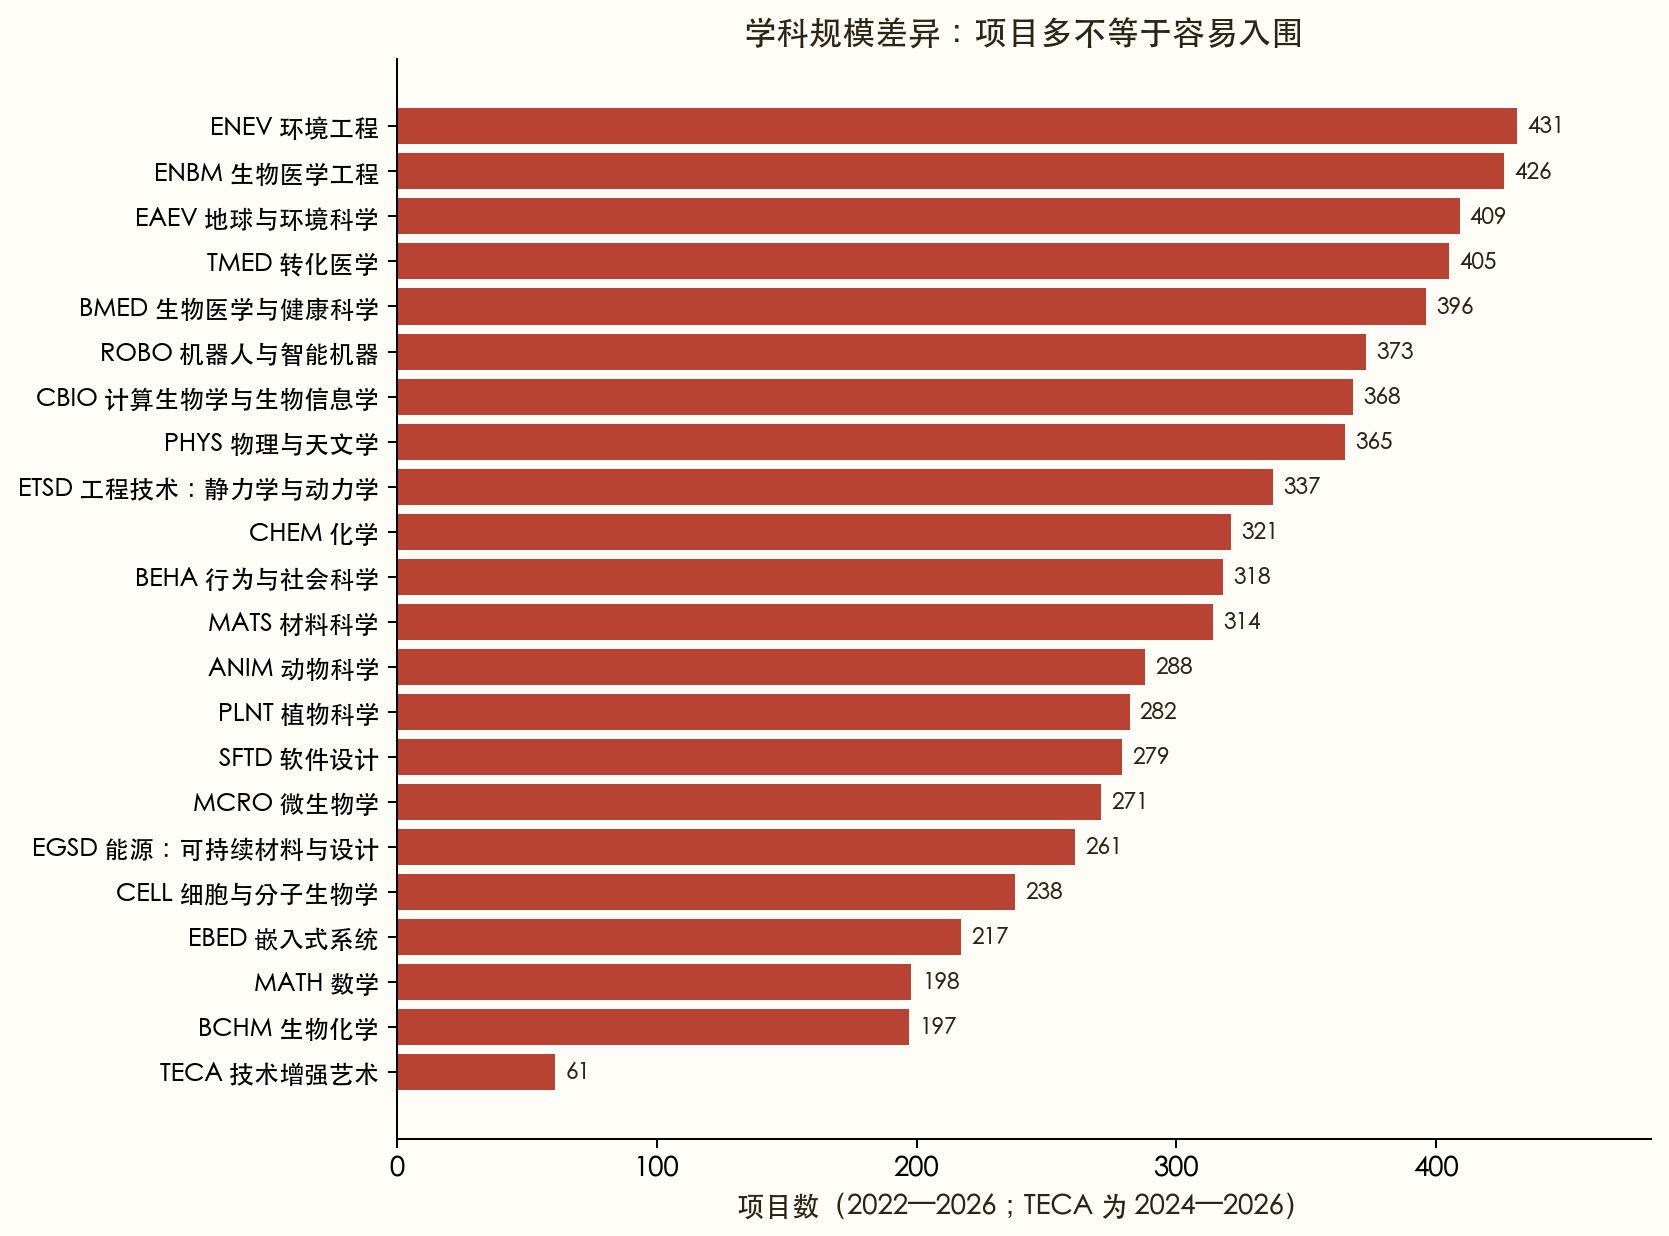
近五年中,环境工程有 431 个项目,生物医学工程有 426 个,地球与环境科学有 409 个,转化医学有 405 个。它们为读者提供了丰富的案例池,但项目多并不自动意味着更容易入围。地方选拔、学校资源、研究兴趣和类别设置都可能影响数量。
计算生物学与生物信息学从 2022 年的 75 个项目到 2026 年的 92 个,材料科学从 55 个到 82 个,生物医学工程从 81 个到 98 个。这些是首尾年份的观察,不代表每年持续增长。例如 CBIO 中间出现过下降,所以不宜把五个年份压缩成一句“赛道一路上升”。
TECA 自 2024 年作为独立类别出现,在本数据窗口中共 61 个项目。它不能与其他类别的完整五年总数直接竞争名次;前两年的横线表示当时没有这个独立类别,并非艺术与技术结合的研究不存在。
读者可能会注意到,规范分类后的近五年学科大奖比例大多接近。仅凭几个百分点的差异挑选类别,没有足够依据。更合理的用途是按研究问题寻找最近的作品,再判断哪些验证你有条件完成。第二章已将这些类别与具体子类别、真实案例对应起来。
同一研究还可能在不同年份、不同赛事中登记到不同的大类。旧代码 SOFT 与新代码 SFTD 在本章合并,2014—2016 年的历史标签则结合展位代码规范化。若研究跨度很长,应先做分类核对,不能直接把数据库今天显示的标签当成当年完整的分类制度。
7.5 方法变化:计算越来越常见,工程迭代并没有消失
我们此前对标题与摘要进行了方法关键词识别。下面比较 2014—2019 年的 8,331 个项目和 2024—2026 年的 4,039 个项目。每个项目可以命中多个方法,因此比例相加可能超过 100%;两个时间窗按各自项目数计算比例,没有把六年的数量直接与三年数量相比。
| 摘要文字信号 | 2014—2019 | 2024—2026 | 变化/百分点 |
|---|---|---|---|
| 原型与工程迭代 | 25.81% | 25.72% | -0.08 |
| 材料合成与表征 | 15.11% | 17.26% | +2.14 |
| 人体参与者研究 | 12.39% | 16.27% | +3.88 |
| 机器学习/人工智能 | 6.07% | 20.30% | +14.23 |
| 计算建模与仿真 | 6.04% | 11.93% | +5.90 |
| 湿实验与分子生物学 | 7.87% | 7.70% | -0.17 |
| 受控实验 | 4.73% | 5.20% | +0.47 |
| 数学理论与证明 | 4.43% | 4.53% | +0.10 |
| 观察性/历史数据研究 | 3.54% | 5.32% | +1.78 |
| 现场/环境采样 | 4.00% | 3.94% | -0.06 |
| 问卷与行为实验 | 3.49% | 3.69% | +0.20 |
| 公开数据/数据挖掘 | 0.40% | 0.89% | +0.50 |
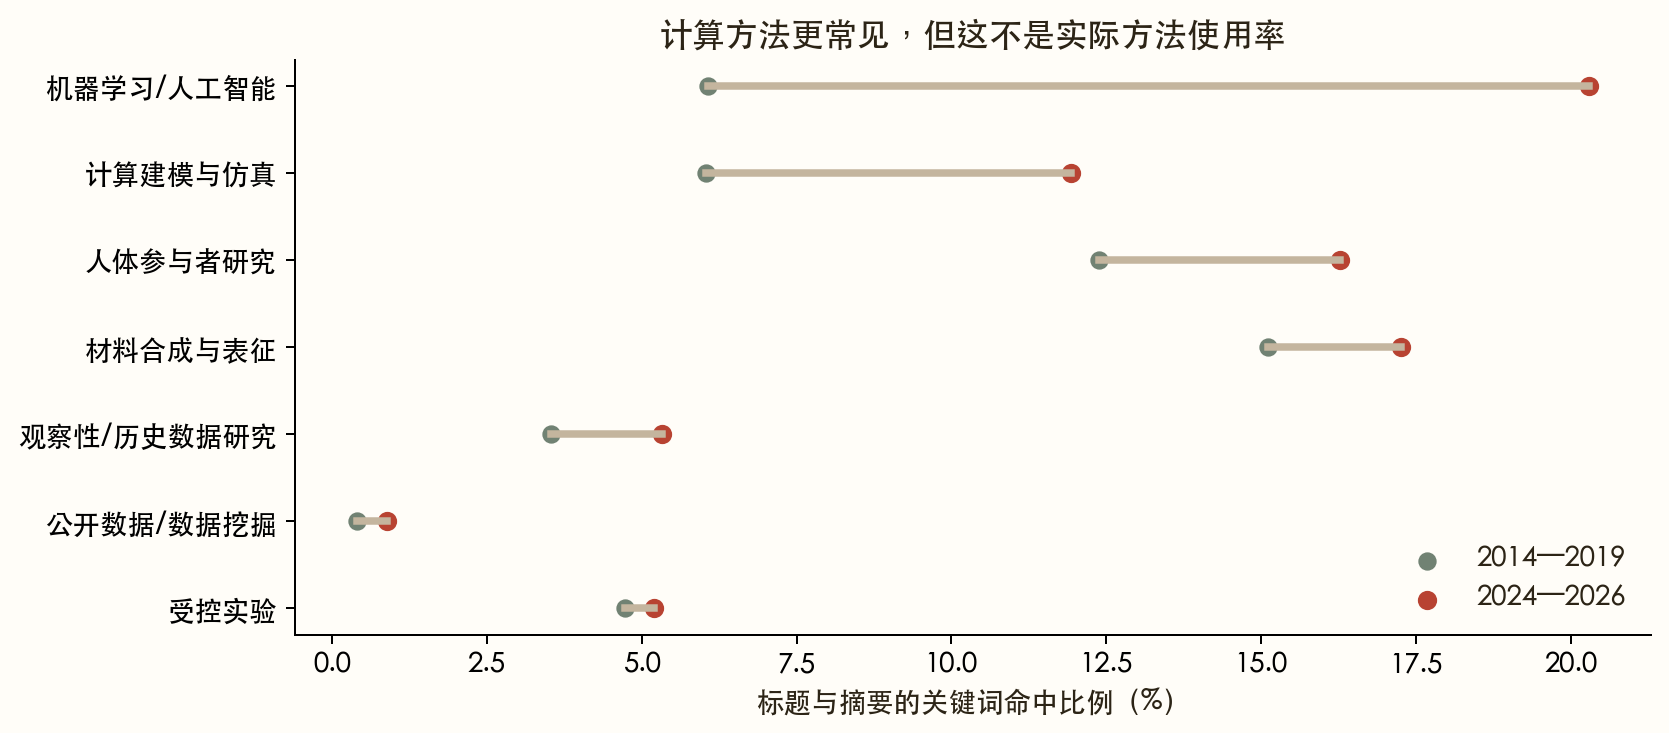
最明显的变化是机器学习/人工智能相关措辞,从约 6.1% 增至 20.3%;计算建模与仿真从约 6.0% 增至 11.9%。这说明相关方法在摘要中更常见,也意味着仅凭“采用 AI”很难解释一个题目的独特之处。
与此同时,原型与工程迭代的命中比例约为 25.8% 和 25.7%,基本接近。这些记录里既有更多计算工具,也仍有大量围绕实物测量和反复改进展开的工作。不能据此宣布所有传统实验都被替代。
这些数字是文本识别结果,不是逐篇专家审核后的真实方法使用率。比如使用公开数据的项目未必在摘要里写出“公开数据”,因此 0.89% 不能被解读为只有这么少的学生使用开放资源。相反,某个词可能只出现在背景介绍里,也可能被误识别成实际方法。
如果你的项目采用机器学习,先回答它解决了哪个已有方法处理不好的问题。若只是把一个小表格送进复杂模型,应先比较简单基线;若简单方法同样有效,承认它通常比继续堆模型更有价值。
如果你更擅长动手,可以从测量可靠性、性能取舍和失效条件入手。第二章的回收线材设备、模块机器人和再生吸水片材,都说明一个工程项目的研究内容可以来自具体、可重复的比较。
7.6 技术趋势告诉我们应该学什么,而不是应该买什么
技术识别中,计算机视觉相关文字在基准期约占 1.55%,近期约占 7.08%;测序与组学从约 1.12% 到 3.64%;遥感与 GIS 从约 0.38% 到 1.39%。于是,读生物或环境项目时,也常常需要理解图像、数据和模型。下载技术信号汇总表
对学生,这些数据最值得转化成学习任务。例如计算机视觉需要懂得标注、误差和测试划分;组学分析需要处理批次和样本来源;遥感分析需要理解空间分辨率、云和地面参照。学会使用工具并不等于掌握这些判断。
旧技术表里还有 Transformer/LLM 一项,但不能直接拿来画“大模型进入 ISEF”的历史曲线。早年 transformer 可能指电力变压器,宽泛关键词还可能产生其他误命中。未经逐项语义核查,本书不将这一项解释为大语言模型项目数量。
同样,某种昂贵技术与获奖出现关联,不能证明购买该设备就会增加获奖机会。决定是否使用一项技术之前,先写出你需要测的量。现有办法差在哪里,新技术能否解决,得到结果后自己是否解释得清楚?没有这些条件,设备越复杂,学生与研究之间的距离可能越大。
7.7 摘要越来越常写指标,但数字不等于验证充分
| 摘要文字信号 | 2014—2019 | 2024—2026 | 变化/百分点 |
|---|---|---|---|
| 对照/比较基线 | 17.39% | 22.23% | +4.84 |
| 显著性/p 值 | 7.93% | 12.82% | +4.89 |
| 分类性能指标 | 4.85% | 13.57% | +8.72 |
| 明确样本量 | 3.48% | 6.24% | +2.76 |
| 重复实验/多次试验 | 1.96% | 3.12% | +1.16 |
| 回归误差指标 | 0.29% | 1.39% | +1.10 |
| 随机化 | 0.54% | 0.67% | +0.13 |
| 留出集/交叉验证 | 0.28% | 1.04% | +0.76 |
| 置信区间/不确定性 | 0.40% | 0.52% | +0.12 |
| 盲法 | 0.10% | 0.17% | +0.08 |
| 外部/独立验证 | 0.00% | 0.30% | +0.30 |
分类指标、对照基线和样本量等措辞在近期摘要中更常见。这有助于读者找到结果的依据,也反映出计算和数据类项目在表达方式上的影响。但本表不能当作逐项研究质量评分。
例如,“外部/独立验证”近期命中约 0.30%,并不说明其他 99.70% 的项目都没有做过外部验证。摘要篇幅有限,表达方式多样,关键词检索也可能漏掉换一种说法的项目。同理,写了 p 值不保证设计合理,写了交叉验证也不保证没有数据泄漏。
对于自己的项目,可以把这些文字线索转成真正的检查问题:基线是否公平?样本到底是人、图像、细胞还是实验批次?测试数据是否在调参时被反复查看?多个指标中,哪一个在实验前就确定为主要终点?
一个常见例子是同一人的视频被切成许多片段。若随机将片段分到训练和测试中,模型可能在两边都见过这个人,结果很高却不代表能处理新参与者。需要按独立对象划分数据,而不是只在程序里调用一个“随机分割”函数。
另一个例子是材料实验。来自同一批制备的十块试样,可以反映该批次内部差异,却不能完整说明换一批原料后是否重复。研究记录应保留层级关系,避免把重复测量全部当成独立样本。
7.8 36 个主题簇:用来找邻居,不是新的官方分类
在此前的分析中,我们把标题和摘要转为词语特征,再用非负矩阵分解(NMF)整理成 36 个主题簇。可以把它理解成一种按词语共现习惯整理书架的方法:经常一起出现的词,形成一个便于查阅的区域。
它与官方类别不同。一个“蛋白、结合与药物”的簇可能同时包含 BCHM、CBIO 和 TMED;一个机器人相关簇也可能跨越 EBED、ROBO 和 ETSD。模型为每个项目选择权重最高的簇作为主要位置,并不表示项目只有一个研究主题。
| 主题簇的便于阅读的名称 | 2014—2019 | 2024—2026 |
|---|---|---|
| 检测、早期诊断与患者 | 2.65% | 5.60% |
| 机器学习与模型准确率 | 2.05% | 4.73% |
| 神经网络与图像 | 1.26% | 3.71% |
| 机器人与实时系统 | 2.17% | 4.46% |
| 蛋白、结合与药物 | 1.49% | 3.71% |
| 脑、脑电与认知 | 2.78% | 4.43% |
| 物种、种群与环境 | 4.14% | 5.32% |
| 阿尔茨海默病相关 | 1.25% | 2.15% |
| 塑料、废弃物与可降解材料 | 2.35% | 3.22% |
表中选取的是相对基准期增加较明显的主题,不是按研究质量或获奖前景排序。中文名称是对关键词的便于阅读的概括,也不是官方认可的新学科。例如“检测、早期诊断与患者”既可能包含影像算法,也可能包含实验检测方法,需要继续查看原始项目。
这一整理方式特别适合跨学科选题。你如果只在 ENBM 中查智能鞋垫,可能漏掉 BEHA 中的步态研究或 ROBO 中的运动识别。按主题先找一批相关作品,再按问题、方法和验证方式细分,比只按报名大类搜索更充分。
主题模型也会受词表和参数影响。我们使用 36 个成分、固定随机种子和最多 18,000 个词语特征生成已有分析;换成另一种设置,部分项目的位置可能改变。因此,不应将簇边界理解为研究领域的天然边界。
7.9 世界地图:先看到选拔系统,再看获奖比例
2022—2026 年的 6,755 个项目来自 77 个附属赛事所在国家或地区。美国记录为 4,558 个,约占 67.5%;中国大陆、香港、澳门与台湾合计 254 个,约占 3.8%。这里的地点字段是赛事所在地,不是学生国籍,也不必然等于长期居住地。
下面列出部分地区,统一使用五年窗口和修正后的学科大奖口径。区间采用 Wilson 方法,显示小样本比例的不稳定程度;它不是未来获奖概率的预测区间,也不能消除选拔与来源偏差。
| 赛事所在地 | 项目数 | 学科大奖项目 | 观察比例 | 95% 区间 |
|---|---|---|---|---|
| 中国大陆 | 142 | 50 | 35.2% | 27.8%—43.4% |
| 中国台湾 | 60 | 22 | 36.7% | 25.6%—49.3% |
| 中国香港 | 23 | 6 | 26.1% | 12.5%—46.5% |
| 中国澳门 | 29 | 7 | 24.1% | 12.2%—42.1% |
| 美国 | 4558 | 1275 | 28.0% | 26.7%—29.3% |
| 泰国 | 73 | 38 | 52.1% | 40.8%—63.1% |
| 加拿大 | 70 | 35 | 50.0% | 38.6%—61.4% |
| 沙特阿拉伯 | 185 | 82 | 44.3% | 37.4%—51.5% |
| 新加坡 | 30 | 20 | 66.7% | 48.8%—80.8% |
| 韩国 | 130 | 26 | 20.0% | 14.0%—27.7% |
| 日本 | 76 | 19 | 25.0% | 16.6%—35.8% |
| 印度 | 99 | 32 | 32.3% | 23.9%—42.0% |
| 巴西 | 89 | 15 | 16.9% | 10.5%—26.0% |
| 波多黎各 | 159 | 8 | 5.0% | 2.6%—9.6% |
| 埃及 | 74 | 17 | 23.0% | 14.9%—33.7% |
新加坡这批记录中有 20/30 个项目获学科大奖,观察比例约 66.7%,但区间很宽,约为 48.8%—80.8%。不能据此说当地普通学生有三分之二的机会在 ISEF 获奖。我们看到的是已经经过当地选拔的少量项目,不是所有有科研兴趣的学生。
美国记录的分母大得多,国家地区间的参赛结构也不同。项目构成、选拔层级、指导资源和年份组合都可能影响比例。没有申请者基础资料,无法分离这些因素,更不能把表格当成科研教育质量的排行榜。
专项奖还可能有独立的评价目标和资格条件,需要逐个奖项查官方说明。名称出现 University、NASA 或 Scholarship 等词语,不能据此断言国际学生没有资格。旧报告中的关键词标记只够支持进一步检查,本书不把它当成资格事实。
7.10 中国相关记录:年际变化比一个平均数更值得注意
| 赛事所在地 | 2022 | 2023 | 2024 | 2025 | 2026 | 合计 |
|---|---|---|---|---|---|---|
| 中国大陆 | 44 | 31 | 35 | 5 | 27 | 142 |
| 中国台湾 | 12 | 12 | 12 | 12 | 12 | 60 |
| 中国香港 | 5 | 5 | 4 | 4 | 5 | 23 |
| 中国澳门 | 6 | 6 | 6 | 5 | 6 | 29 |
中国大陆的档案数从 2022 年的 44 个,到 2025 年的 5 个,再到 2026 年的 27 个,变化很大。单靠档案不能确定原因是提名安排、参与渠道、政策、记录覆盖还是其他因素。我们只报告观察,不用“科研水平上升或下降”解释这些数字。
五年合计的大陆记录有 50/142 个被识别为学科大奖项目,约 35.2%。这个比例与过去某些地区报告不同,原因包括专项奖误分类的修正和 2025 年分母的处理。读者如果同时查阅网站旧图表,应优先确认口径,不应选择其中更好看的数字用于宣传。
对家庭更有帮助的是把地区记录转成具体行动:你的学籍与所在地对应哪一个选拔路径?学校是否掌握当年通知?项目需要何时完成预审?既有案例不能替代资格确认,往届某校有项目也不表示今年自动存在同样通道。
我们此前也整理过学校与城市分布,但不在此发布“学校培养能力排名”。学校名称可能存在不同写法,部分记录不完整,一所学校的少量获奖更不能证明每位学生能获得同样支持。若要了解一所学校的研究条件,应查看导师、设施、时间安排与学生实际分工。
7.11 美国各州和附属赛事:一张地图里有多个层级
此前的美国赛区研究从 2023 年官方项目资料中整理出 283 个美国附属赛事条目及合计 898 个历史名额,中位数为每个赛事两个。这个结果描述的是当年的目录与名额,不是 2027 年可直接使用的报名表。官方附属赛事目录是核对当前路径的起点。附属赛事说明
有的州有多个地区赛事,再与州级赛事形成衔接;有的地方路径不同。赛事代码中的数字曾被用于辅助判断层级,但代码推断不能代替官方赛事规则。不要看到某州项目多,就认为只要搬到那里便更容易参赛。
在既有五年项目统计中,佛罗里达、纽约、得克萨斯和加利福尼亚等州贡献了较多记录。它们同时拥有不同规模的学生群体和赛事网络。没有地方报名人数、晋级路线与名额制度的统一资料,不能把项目数量换算为当地学生的晋级优势。
对于在美国就读的学生,最有用的一张表应列出自己可参加的赛事、覆盖学校或区域、资格条件、截止日期,以及是否要求先通过另一级比赛。这张个人路线表,比一张各州获奖排名更能帮助安排本学年的工作。第四章介绍了核对路径的方法。
7.12 获奖关联为什么不能当作选题公式
此前分析计算过“按年份与学科调整后的获奖关联”。做法是先看一个方法相关的项目出现在什么年份和学科,再依据各组的基础比例估计一个预期获奖数,最后与实际观察数相比。这样可以减少不同年份、类别混在一起造成的一部分影响。
即使经过调整,这仍然不是实验。更成熟的项目可能既有条件使用某种技术,也更容易获奖;导师资源、研究时长和学生基础可能同时影响两者。没有这些资料,无法把技术本身的作用单独分出来。
因此,本书不列“使用某方法可提高多少获奖率”的操作指南。那些关联更适合用来提出后续阅读问题:为什么这类项目容易展示出清楚的比较?是否因为它们有更明确的基线或终点?继续读原始作品,往往比停在一个比值上有收获。
对自己的选题,可以换成三个实际问题:我能否得到足够可靠的数据?我是否理解主要方法?在已有条件下,能否完成一个别人可以检查的比较?这些问题没有历史获奖率那么醒目,却直接影响你能否完成研究。
7.13 题目相似、持续研究与创新性
在已有标题相似度分析中,16,171 个可比较项目里,若使用 0.62 的相似度阈值,会得到 918 个待检查记录;阈值提高到 0.90,剩 151 个。阈值改变,名单就明显变化。这说明相似度更适合做阅读索引,而不是直接贴上“重复”标签。
相似标题可能来自同一问题的新方法、持续研究的下一阶段,也可能只是共享常见术语。标题完全不同的两个项目反而可能采用相同方案。没有阅读全文、比较方法和验证内容,不应指控抄袭,也不能据低相似度宣布原创。
智能鞋垫方向的既有检索找到 16 个直接标题近邻,覆盖七届;更宽的步态、跌倒与相关健康主题有 234 个。ACL 方向有四个直接标题近邻,宽主题为五十个。直接近邻与宽主题不能相加,它们对应不同范围,且可能互相包含。
这些数字的用途是决定下一步阅读。鞋垫方向显然不能只靠“加上传感器”说明新意;ACL 近邻较少,也不代表相关学术论文或临床产品很少。第八章将用这两个方向展示如何比较先例并缩小题目。
7.14 把数据读成自己的下一步
如果你还没有题目,先从第二章找两个真正有兴趣的学科,读各自的案例,再用本章了解相关方法是否常见。常见不意味着不能做,它意味着需要更清楚地说明自己改变了什么条件、解决了哪个限制。
如果你已经有题目,检索时不要只搜题目里的中文名称。把研究对象、测量手段、应用场景分别换成英文近义词,再查看不同类别的作品。记录最相近的几项工作,用同一组问题比较它们:输入是什么,输出是什么,基线是什么,测试在哪里进行。
如果你已经得到结果,数据分析最重要的用途是帮助限定结论。你的测试人群、样本批次或环境能覆盖多大范围?当条件改变时,方法可能在哪里失效?能把这些问题讲清楚,比引用某个学科的历史获奖比例更能让读者信任你的工作。