写在前面
准备 ISEF 时,许多家庭最先问的是:什么题目容易获奖,要不要找大学实验室,做多久才来得及?这些问题都很实际,但在选题之前,还有几件事需要弄清楚:学生能从哪一场附属赛事进入选拔,准备研究的问题是否真的有待回答,现有条件能不能支持必要的实验,以及学生是否愿意在结果不如预期时继续做下去。
本书从原 Notion 的六章目录扩展为八章。除了比赛、材料、晋级和支持资源,第二章逐一解释 22 个学科与 156 个子类别,并增加每个学科的真实案例。第七章把历届数据整理成可以查阅的图表,第八章用已有的方向研究演示怎样缩小题目。全书有 29 个主要案例解读。第五章另把其中八个整理成四区教学图,帮助读者逐项检查证据;这些重绘图与官方版式的关系都注明出处。各章可以单独阅读。
如果你是第一次接触科研的学生,建议先读第一章、第二章开头和第六章。已经有项目的同学,可以从第三章开始,检查现有证据能否支持自己的结论。家长尤其值得读第四章和第六章:选拔资格、研究条件和可持续的时间安排,通常比题目听起来有多先进更早影响项目能否走下去。
本书的规则说明依据 Society for Science 已发布的 2026—2027 国际规则,获奖案例覆盖最近五届已结束的赛事,即 2022—2026 年。官方学科网页仍标注 2026 年,因此本书同时核对了 2027 年摘要表中的 22 个类别。旧目录中的“系统软件”更新为当前名称“软件设计(Software Design)”。数字材料部分会区分 2026 年已发布的要求与仍需等待 2027 年参赛通知的内容。
阅读时请留意两种不同的文字。涉及资格、审批、材料限制的规定,正文附有官方出处;涉及怎样选题、安排时间、解释图表的内容,是本书的教学建议。章节中的练习题和假设数字只用于说明研究方法,不是已完成的实验,也不是往届获奖项目。第二章与第五章的真实案例逐项标明年份与来源。案例中的方法讨论是本书解读,未在摘要中给出的实验细节不会补造;与子类别的联系也不冒充作者的官方报名记录。
竞赛规则会更新,附属赛事也可能设置额外要求。实际报名时,应把本书与当赛季规则、所在附属赛事通知放在一起阅读。尤其是研究开始前的审批,不能等论文写好后再补。对规则有疑问,可以把具体研究计划交给赛事的科学审查委员会,而不要仅凭某个题目所属的学科判断。
学生不必一开始就像专业研究者一样熟练。也许你只是发现传感器一到雨天就不准,想知道原因。查资料,排除接线问题,再设计一次能区分不同原因的测量,研究就从这里开始了。题目可以小一些,只要你确实想把它弄清楚。
阅读目录
- 认识 ISEF:比赛如何运作,评委在看什么
- 22 个学科与选题:把兴趣变成可研究的问题
- 科研项目材料与展示:从研究记录到现场答辩
- 各区域晋级机制:找到自己的报名与选拔路径
- 真实案例与四象限读图:从公开摘要走到证据分析
- 参赛支持与资源:时间、导师、家庭与常见问题
- 从历届数据认识 ISEF:17,565 个项目的规模、方法与地区结构
- 把方向变成可以完成的研究:近邻作品、验证条件与选题推演
本书的基础来源
第一章 认识 ISEF
1.1 一场以学生研究为中心的比赛
ISEF 的全称是 International Science and Engineering Fair,中文通常译为国际科学与工程大奖赛。它由 Society for Science 主办,目前使用冠名名称 Regeneron ISEF。比赛始于 1950 年,参赛作品来自不同国家和地区的附属科学展。2026 年总决赛在美国凤凰城举行,官方公布的参赛规模超过 1,700 名学生,来自 64 个国家、地区和属地。赛事介绍与 2026 年回顾
在考场型竞赛中,题目、时间和评分答案通常预先确定。ISEF 把更大一部分判断交给学生:研究什么,为什么值得研究,采用什么方法,如何面对含混的结果。学生带着自己的项目参加展示和面谈,评委据此判断研究的质量,以及学生对工作的理解。
按照教程搭出一个太阳能装置,是很好的学习起点。接下来,你可能发现遮住不同位置时,输出的变化并不相同。为什么?怎样排除接线或测量误差?如果你开始为这些疑问设计比较、寻找解释,就从制作练习走进了研究。
家长不必把获奖履历当作学生未来发展的唯一出口。研究经历可以帮助学生理解自己的兴趣,也能为之后的学习提供具体材料,但奖项与大学录取之间不存在可直接换算的关系。本书不提供获奖概率或录取承诺。
1.2 谁能参加,项目可以做多长时间
2027 规则要求,学生须由 ISEF 附属赛事选拔,处于九至十二年级或同等教育阶段,并且在该届 ISEF 前的 5 月 1 日当天或之前尚未满 20 岁。每名学生只能提交一个项目;团队最多三人。项目的研究工作最多覆盖连续 12 个月,2027 届不能计入 2026 年 1 月以前开展的研究。参赛资格与研究期限
这里有两个容易混淆的概念。第一,学习相关知识可以持续很久,参赛评审所覆盖的研究工作却有时间边界。第二,长期做同一方向不意味着每年原样提交。延续项目应说明本年度新增的研究问题、变量或方法;重复原来的问题和方法、仅增加样本量,不构成规则所要求的实质扩展。长期观察研究有专门条件,需要单独阅读。2027 规则中的延续项目说明
例如,第一年研究某种结构的静态承重,第二年转向反复加载后的疲劳表现,可能形成清楚的研究递进。若第二年只是用相同方式多测了几块同样的材料,就需要重新判断是否足够。学生应保留前一年度记录,让评委看得出本届工作的起止和贡献。
总决赛资格还有本地层面的限制。满足 ISEF 的年级、年龄要求,并不自动意味着符合任意附属赛事的报名条件。学校所在地、就读身份、团队组成、推荐渠道,都可能影响报名资格。第四章会解释如何核实。
1.3 科学项目与工程项目,两种不同的研究重心
科学项目主要回答“为什么会这样”或“在什么条件下成立”。工程项目主要解决“在这些限制下,怎样设计一个更合适的方案”。两者都要提供证据,区别在于问题和证据的组织方式。
假设你关注校园积水。比较地表材料与径流变化的关系,重点在于解释现象;设计一个低成本排水结构,重点则在于满足流量、占地、维护和安全等要求。同一背景可以产生不同类型的研究。给作品贴上“科学”或“工程”的标签之前,先看自己究竟想证明哪一件事。
官方对科学与工程项目采用相同的分值框架,但各项具体含义有所区别。Grand Award 评审标准
| 评审部分 | 分值 | 科学项目的重点 | 工程项目的重点 |
|---|---|---|---|
| 研究问题 | 10 | 问题是否明确、可检验 | 需求、成功标准与限制是否明确 |
| 设计与方法 | 15 | 变量、对照、数据收集是否合适 | 是否比较过备选方案并形成设计 |
| 执行 | 20 | 数据、分析与解释能否支持结论 | 原型是否完成,并经多种条件测试 |
| 创造性与潜在影响 | 20 | 研究中是否有新的判断或贡献 | 方案是否体现创造性和实际价值 |
| 展示 | 35 | 展板 10 分,面谈 25 分 | 展板 10 分,面谈 25 分 |
面谈占 25 分,并不意味着可以用演讲弥补研究缺口。它让评委有机会判断学生是否真正理解了前面的工作。为什么选择这个对照?某次实验为什么被排除?换一种解释,数据是否仍然说得通?这些问题很难靠背诵一份漂亮讲稿解决。
平时可以做一个小练习:给最重要的一张图写两段说明。第一段讲图中显示了什么;第二段讲这张图还不能证明什么。如果第二段写不出来,往往说明你还没有充分理解自己的结论边界。
1.4 如何理解原创性
中学生研究很少从完全陌生的理论出发。沿用成熟方法、使用公开数据、阅读并复现已有工作,都可以是研究的一部分。问题在于学生是否提出了可以辨认的新问题,并完成了支持这一问题的工作。
有时,贡献恰恰是发现一种方法在某种环境下不可靠。如果此前没有人认真检查过这种条件,而你能解释失效从何而来,这就是一个值得讨论的发现。改进装置、给出反例或明确一个结论的适用范围,也都可能产生新的知识。
相反,把普通分类模型换成更新的模型,把项目名称加上“智能”“量子”或“精准”,并不能说明贡献。你需要指出现有工作到底缺了什么,新实验又补上了哪一部分。若去掉标题中的技术名词后,研究问题也消失了,题目大概还需要缩小。
学生在专业实验室开展工作时,应能清楚分开实验室的大课题和自己完成的部分。导师给了什么问题、设备或代码,学生做了什么设计、测量和分析,都应真实记录。获得帮助并不丢人;把帮助隐去,反而会使评委无法判断作品。
1.5 奖项、排名与“获奖率”
ISEF 的学科大奖、顶级奖项和专项奖有不同的设置。学科大奖在各类别中评出;部分顶级奖项再从优秀项目中选出;专项奖由相关组织根据自身标准颁发。读获奖名单时,应同时看奖项名称、年份和项目,而不要把所有奖项都简化成同一个层级。官方奖项说明
获奖人数也不等于获奖项目数。团队有多名成员,同一项目可能获得多个奖项。用“获奖记录条数”除以“参赛人数”,得到的比例没有清楚含义。即使分母和分子统计正确,总决赛中的获奖比例也只描述已经通过选拔的项目,不能代表刚开始准备的学生的获奖机会。
本书选取获奖案例,是为了学习研究中的判断,不是用它们推导某个学科更容易得奖。一个类别里的竞争状况、评委专长和项目数量都会变化;读懂问题,比寻找所谓冷门赛道更有用。
1.6 ISEF 与其他活动如何选择
对同时考虑丘成桐中学科学奖的家庭,最直观的差别在于材料和参赛机制。丘奖的报名与研究报告要求应按其当年度规则准备;ISEF 则需要先经过附属赛事选拔,并围绕项目展示与面谈接受评审。两边的研究经历可以相互启发,但不能把一套材料和审批要求直接移用到另一边。丘奖参赛规则、ISEF 参赛常见问题
| 活动类型 | 学生主要做什么 | 选择前应问自己什么 |
|---|---|---|
| ISEF 类研究竞赛 | 完成一项研究,经选拔后展示与答辩 | 是否有明确路径、研究条件和持续投入的时间? |
| 以研究报告为核心的竞赛 | 把原创研究写成完整论证,并按规则参评 | 是否愿意花时间打磨证明、实验解释和写作? |
| 学科知识竞赛 | 在统一条件下解题 | 当前更希望加深学科基础,还是探索开放问题? |
| 课程研究或独立项目 | 按课程或自设目标完成研究 | 如果暂时没有合适的竞赛路径,是否仍愿意把问题研究清楚? |
学生可以先完成一项适合自己的小研究,再决定进入哪一种比赛。反过来,若确定以 ISEF 为目标,就应尽早了解附属赛事和审批要求,避免研究做完才发现时间或手续不符合要求。
1.7 第一次讨论项目时,带什么来
第一次与老师讨论时,一页纸就够。写下你观察到的现象、已经读过的一两份可靠资料、想问的问题、可能取得的数据,以及最担心的困难。标题暂时朴素一些没关系。
比起“我想做人工智能医疗”,更便于讨论的表达是:“我发现一个公开影像数据集,想知道模型跨医院使用时是否仍能保持表现。我还不清楚这些数据能否按医院拆分,也没有确认使用许可。”后一种表达已经指出研究问题和实际障碍,老师可以据此判断下一步。
在查明数据权限、研究条件和前置审批之前,先做阅读、方法学习和方案讨论。项目真正开始后,你会不断修改最初的设想;保留这些变化,日后写研究过程时会很有帮助。
第二章 22 个学科与选题
选学科之前,先把问题说清楚
一个项目可能同时用到计算机、化学和生物知识。报名类别应对应研究的主要贡献,以及最适合评价这项贡献的专业背景。官方也提醒,附属赛事和 ISEF 总决赛的类别不一定相同,学生可以根据项目内容重新判断。学科选择说明
例如,用神经网络分析基因表达,若重点在于发现可解释的生物学关系,计算生物学与生物信息学可能更合适;若重点是提出一种对多种任务都有效的新计算方法,则需要认真比较软件设计等类别。应用场景只是线索,不能单独决定类别。
本章按 2027 摘要表的 22 个类别排列。每节给出学科的研究重心、需要补足的基础、可以讨论的选题例子和验证难点。这里的例题是教学构想,不是推荐照做的实验方案,也没有经过具体场所的安全审查。涉及人、动物、生物材料或危险装置时,第三章的审批要求应先落实。2027 类别表
从“大方向”缩小到一个问题
“人工智能保护环境”是兴趣方向。“用图像识别河流垃圾”已经有了任务,但还没有说明研究贡献。如果继续追问:“阴影和水面反光会怎样影响识别,某种训练方法能否降低这些误判?”就开始出现可比较的变量和可检查的结果。
选题时,可以先写五句话:我想解释或改善什么;已有方法做到哪里;我准备比较什么;什么结果会推翻我的设想;我能取得哪些数据。最后一句如果还没有着落,就先解决数据与条件问题。
“热门”并不等于“值得追”。本章讨论的是有学习价值的方向,不是按参赛热度排出的榜单。看起来普通的题目,只要研究边界清楚,也可能比追逐新名词更适合学生。
本章按“学科概览—子类别辨析—真实案例”的顺序展开。子类别共有 156 项,包括每类的 Other。每一项都配有研究范围的解释;除 Other 外,还给出一个教学问题和验证时容易忽略的细节。这些问题用来帮助理解,不表示已经完成文献查新,也不表示可以跳过研究审批直接实施。
子类别名称与代码以主办方各学科页面为依据,参考我们在 2026 年 9 月整理的官方资料。官网汇总页仍标示 2026 类别说明,不能把网页上的所有细分名称当作已单独发布的 2027 子类别文件。主类别与 2027 类别表核对;报名时以实际赛季表格和赛事说明为准。行为与社会科学的单独页面明确列出社会心理学,补足了汇总页列表的遗漏。
历史数据中的软件类常记作 SOFT,当前官方代码为 SFTD,本书将两者合并统计。每节的项目数来自 2022—2026 官方档案,表示决赛记录规模,不是报名人数,也不是未来名额。TECA 仅有 2024—2026 三届记录。完整统计口径见第七章。
下面 22 个案例均依据主办方公开摘要。大类登记与项目 ID 来自原记录;它们与具体子类别的联系,是本书的教学解读,不能当作作者当年的子类别报名信息。原摘要里的结论由作者报告,本书的评价问题也不等于评委意见。每个案例都附原始链接,方便继续阅读。
2.1 动物科学 Animal Sciences(ANIM)
动物科学关注动物的行为、生理、生态关系和福利。喜欢观察生物的学生往往容易进入这个领域,但观察的耐心与记录的一致性,比一开始拥有多复杂的设备更重要。需要学习的基础包括行为分类、抽样方法,以及如何分辨个体差异与环境影响。
一个可以讨论的问题是:在不干预动物生活的前提下,校园鸟类在不同人流时段的觅食行为是否变化?研究者需要固定观察区域、时长和行为定义,同时记录天气与时段。若早晨人少、下午人多,行为差异也可能与时间有关,不能直接归因于人流。
另一类方向是分析公开动物影像,比较某种行为识别方法在遮挡条件下的表现。它能把数据分析与动物行为问题结合起来,但需要确认影像的使用许可,并检查标注是否可靠。
动物研究的难点常在“样本究竟是什么”。同一只鸟出现二十次,不等于二十个独立个体。涉及脊椎动物的操作性研究有专门要求;即使计划为自然观察,也应按官方豁免条件核对,不能仅凭“不接触动物”自行决定。脊椎动物规则
2022—2026 年官方档案共收录本类 288 个项目,各年依次为 75、55、51、53、54 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
动物行为 · Animal Behavior(BEH)
关注动物怎样行动、交流和作出选择。一个教学问题是:遮蔽物的位置改变后,昆虫在各区域停留的时间是否变化?行为要事先定义,观察者最好不知道处理组,不能把“看起来更活跃”当作测量。
细胞研究 · Cellular Studies(CEL)
把观察尺度缩小到动物细胞的形态与活动。例如比较已有显微图像中两组细胞的形态分布。图像数量不等于动物数量;来自同一只动物的多个视野不能被当作多个独立个体。
发育 · Development(DEV)
研究从胚胎到成体的变化。可以围绕合法、适宜模型生物的发育时间提出问题,区分“发育更快”和“最终体型更大”。不同起始阶段混在一起,会把年龄差异误认为处理效果。
生态学与农业 · Ecology and Agriculture(ECO)
把动物放回它与环境、农业活动的关系中。例如通过规范观察研究绿地结构与访花昆虫组成的关系。地点、季节和观察时长都可能影响结果,不能只比较两个随意拍摄的样点。
遗传学 · Genetics(GEN)
关注遗传差异如何关联动物性状。使用公开序列比较种群间的变异,是一种计算入口;重点在采样代表性、序列质量与群体结构,不能看到某个变异就宣布找到性状的原因。
营养与生长 · Nutrition and Growth(NTR)
研究营养条件与生长的联系。例如在获准的研究条件下比较营养组成,而非只比较食物品牌。摄食量、能量摄入和生长阶段需要区分,否则无法判断起作用的是哪种因素。
生理学 · Physiology(PHY)
研究动物怎样维持身体功能,尺度可以是器官,也可以是整个个体。公开呼吸或活动记录中的昼夜变化可以成为问题;生理解释需要相应指标支持,不能从活动减少直接推出健康恶化。
系统学与演化 · Systematics and Evolution(SYS)
比较物种关系、分类特征与演化历史。例如检验形态特征和公开 DNA 序列得到的分组是否一致。相似外形可能独立演化,序列树也受选用基因和模型影响,两种证据不应被简单等同。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对动物科学项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:蜜蜂健康,为什么要同时看细胞与蜂群
2026 年项目 ANIM005 比较二氧化碳处理与几种常规杀螨剂对蜜蜂和蜂群的影响。摘要介绍了工蜂寿命、中肠组织、免疫细胞、雄蜂生殖相关测量,以及覆盖 60 个蜂群、持续十周的田间试验。卷积神经网络用于辅助量化肠组织厚度和螨虫数量。官方项目摘要:27856
这项工作可以帮助读者理解 ANIM 内部的尺度区别:中肠组织连接细胞研究,个体寿命和生殖连接生理学,蜂群产出和螨虫控制则接近生态学与农业。计算机视觉在这里是测量工具,研究的主要问题仍是动物健康。这些联系帮助读者理解研究尺度;作者实际选择了哪个子类别,公开记录没有说明。
作者在摘要中报告,二氧化碳处理在抑制螨虫的同时较好地保持了所测蜜蜂健康指标。这里不能只看“杀螨效果”:一种处理即使减少了害虫,也可能给宿主带来其他损失。把收益和代价放进同一设计,问题才完整。
读者还应追问:60 个蜂群怎样分组?原有螨虫负担和蜂群强弱是否可比?同一蜂群里的许多蜜蜂如何进入统计?图像算法有没有人工核验?摘要没有展开这些信息,所以本书不据此判断其控制已经充分,也不把作者的“安全、可扩展”表述推广到所有使用条件。
学生若没有养蜂场和合适指导,仍能学习这种多尺度思路。例如在许可范围内观察访花昆虫时,同时记录到访次数、停留时间和花朵数量,便能区分“昆虫更多”与“单朵花吸引力更强”。研究规模可以小,但测量要服务于同一个问题。
2.2 行为与社会科学 Behavioral and Social Sciences(BEHA)
这个类别研究人的行为、认知及社会现象。它看似不需要昂贵设备,实际很考验研究设计:问题如何提问,参与者为什么愿意加入,测量结果是否反映了你想研究的现象。
例如,“界面里的信息呈现顺序是否影响人们判断不确定性”,就比“青少年如何看待人工智能”更容易形成明确比较。前者可以围绕具体任务设计不同版本,在获批后安排参与者;后者若只发一份自编问卷,往往只能得到难以解释的态度汇总。
学生应补足基础统计、测量信度、混杂因素和研究伦理知识。研究中尽量减少诱导性措辞,提前决定主要指标。若测量多个结果,再挑一个显著结果报告,就会夸大证据。
学校、社交平台或家长群带来的便利样本,未必代表更广的人群。结论应说清“在本研究参与者中观察到什么”。问卷、访谈、在线任务以及许多用户测试都可能属于人体参与者研究,研究审批不能留到发问卷之后。人体参与者规则
2022—2026 年官方档案共收录本类 318 个项目,各年依次为 72、58、58、73、57 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
行为神经科学 · Behavioral Neuroscience(NEU)
寻找神经系统与行为的联系。例如分析公开脑电数据中注意任务的信号差异。若同一人的片段同时出现在训练与测试中,模型可能识别的是人,而非注意状态。
发展 · Development(DEV)
研究行为和心理过程随年龄或生命阶段的变化。例如比较不同年龄组采用某种记忆策略的差异。横断面年龄差异不等于同一个人的成长轨迹,教育经历也可能解释结果。
认知心理学 · Cognitive Psychology(COG)
关注记忆、推理、注意和决策过程。例如信息呈现顺序是否改变判断?应把刺激材料、练习效应和反应时间的处理办法提前写清楚,避免把疲劳或题目难度当作认知机制。
社会心理学 · Social Psychology(PHY)
研究他人、群体和社会情境怎样影响个体判断。例如建议来自同伴还是自动系统,是否改变采纳比例?社会心理学在官方页使用 PHY 代码;它在这里不表示生理学。
社会学与人类学 · Sociology and Anthropology(SOC)
把研究单位扩展到群体、制度和文化。例如利用公开调查研究通勤条件与社区参与的关系。不同地区的收入、人口结构与政策可能同时变化,观察到相关关系不能直接确定因果。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对行为与社会科学项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:AI 建议的语气,会改变人的选择吗
2026 年项目 BEHA024 研究 AI 如何表达建议与人类决策之间的关系。第一项研究纳入 1,538 名参与者,在五类道德困境中改变建议的语气、确定程度与论证结构,并设置没有建议的基线;第二项研究纳入 1,025 名参与者,加入与 AI 交谈的情境。官方项目摘要:28211
这里可以看到认知心理学与社会心理学的交界:前者关心人怎样权衡和推理,后者关心外部建议如何改变判断。研究的自变量不是“有没有先进 AI”,而是读者实际接触到的表达方式。相比笼统询问“你信任 AI 吗”,改变一句建议的表达方式,更容易形成条件清楚的比较。
摘要报告,第一项研究中 63% 的参与者遵从 AI 建议,交谈情境中的比例为 72%;较不确定、呈现双方观点的表达,其选择分布更接近无建议基线。这些数字对应各自实验条件,不能被写成“所有人有七成会服从 AI”。此外,更接近基线说明选择受建议影响较小,并不自动证明决定更正确或更符合道德。
评价这类研究,要看参与者怎样分组、不同文本是否同时改变了长度或可读性、道德困境是否具有代表性,以及自报责任感是否足以反映实际行为。多种实验条件也意味着多个比较,分析计划应避免只保留最显著的一项。
学生能借鉴的是把抽象兴趣变为可控制的因素。若研究课堂反馈语言,可以先只改变“给出答案”还是“解释理由”,保持题目与其他文本尽量一致。涉及人的实验需先完成适用的审批与同意程序,不能写好问卷便直接发给同学。
2.3 生物化学 Biochemistry(BCHM)
生物化学把问题放在分子和反应层面:一种酶为什么改变活性,分子相互作用如何受到环境影响,某条代谢过程如何被调节。阅读时需要同时理解化学平衡、反应速率和生物背景。
以教学构想为例,某种稳定处理能否减缓一种安全、来源明确的商用酶在特定储存条件下的活性下降?真正需要比较的是处理前后的活性曲线,并排除测量体系本身受到干扰的可能。只比较一次颜色深浅,证据往往不够。
有计算基础的学生也可以从公开结构或反应数据入手,研究某类模型在特定分子范围中的误差。计算预测可以帮助提出解释,但对接分数、模型置信度与实验活性并不是同一个量。论文里应该明确哪些是预测,哪些来自实际测量。
选题时就与导师核实试剂和测量条件。尤其要问清楚:支持主要结论的那一次验证,现有设备究竟能不能做?如果做不了,早些调整问题,会比几个月后面对一堆无法检验的预测从容得多。
2022—2026 年官方档案共收录本类 197 个项目,各年依次为 41、37、38、37、44 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
分析生物化学 · Analytical Biochemistry(ANB)
核心是怎样可靠地测量生物分子。例如比较两种蛋白质定量方法在有干扰物时的误差。标准曲线、检测下限与样本基质的影响,比仪器名称更能说明测量是否可信。
普通生物化学 · General Biochemistry(GNR)
研究生物体内的化学反应和分子相互作用。酶反应速率怎样随条件变化,是常见入口。应比较起始速率并控制底物量;一次反应终点的颜色深浅往往不足以解释动力学。
医药生物化学 · Medicinal Biochemistry(MED)
把分子机制与药物作用联系起来。例如用公开资料分析某类分子结构与已测活性的关系。计算结果只能帮助提出候选机制,不能把分子对接分数直接写成疗效,更不能据此推荐用药。
结构生物化学 · Structural Biochemistry(STR)
研究分子的三维结构与功能怎样关联。可比较蛋白变体在已知结构中的位置及相互作用变化。结构预测的置信度、柔性区域与实验条件会影响解释,一张漂亮的三维图不是验证。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对生物化学项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:果蝇中的药物响应,哪些结论可以跨越物种
2026 年项目 BCHM031 用果蝇模型比较司美格鲁肽与一种相关化合物的响应。摘要以高糖饮食建立研究条件,观察幼虫翅盘的荧光、面积以及脂肪体脂滴等指标,并报告两种处理在这些指标上的相似与差异。官方项目摘要:28617
原英文标题使用了带引号的 “Fake” 一词。本书不据此把所有复配制剂归为同一类,也不转述摘要背景段中的药品安全结论。读案例时,应先辨认实验中比较的具体物质、浓度与模型,而不是让一个有冲击力的标题代替化学信息。
化合物怎样改变生物过程,是医药生物化学关心的问题;翅盘图像和脂滴测量,则需要可靠的分析方法。对初学者来说,最有用的问题是:为什么选这些指标?它们各自代表什么,又不能代表什么?例如某个荧光信号变化,只有在检测方法与相应通路的关系得到支持时,才能解释为通路活动变化。
作者报告了模型中的处理差异;从这里走到人类疗效或不良反应,还需要跨物种机制、暴露水平以及独立研究等证据。果蝇身体结构中的变化,不能直接等同于人在用药后会出现的疾病。认识这一距离,并不会削弱研究的价值,反而使结论更准确。
如果学生从事公开药理数据分析,可以先比较同一化合物在不同测定体系中的一致性。不要一开始就问“哪种药最好”,先问“在什么模型和指标下,两种结果可以比较”。这样的收缩会让后续分析踏实得多。
2.4 生物医学与健康科学 Biomedical and Health Sciences(BMED)
本类别围绕健康、疾病及相关生物过程展开。中学生常被疾病检测、公共健康差异和风险预测吸引。适合开始的方式,是先理解一个明确的测量或分析问题,而不是把目标写成“治愈某种疾病”。
例如,利用具有合法研究用途的公开健康数据,检查一项风险模型在不同年龄段的校准是否一致。校准关注预测风险与实际发生比例是否相称,与把病例排在前面的能力有所区别。学生应学会解释指标的含义,并考虑缺失值、群体构成和时间差异。
医学预测尤其容易出现数据泄漏。同一患者不同时间的记录如果分到训练集与测试集,模型可能间接见过测试对象。按记录随机划分未必足够,应根据实际任务决定按患者、机构或时间划分。
公开数据上的表现只支持相应的数据研究结论。未经临床验证的模型不能被称为可用的诊断工具,更不能据此向真实患者提供诊断建议。涉及非公开病历、可识别个人信息或新招募参与者时,应先由有关审查机构确认条件。
2022—2026 年官方档案共收录本类 396 个项目,各年依次为 84、65、91、87、69 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
细胞、器官与系统生理学 · Cell, Organ, and Systems Physiology(PHY)
关心人体细胞、器官和系统怎样正常运作。例如分析公开运动数据中恢复时间的差异。研究要说清测的是哪个生理过程,以及仪器读数与该过程之间有什么联系。
疾病遗传学与分子生物学 · Genetics and Molecular Biology of Disease(GEN)
研究遗传和分子变化怎样参与疾病。例如比较已有数据中某基因的表达与病程指标。样本来源、治疗情况和批次效应需要检查;疾病组与健康组有差异,并不自动证明该基因导致疾病。
免疫学 · Immunology(IMM)
关注免疫系统在健康和疾病中的作用。例如用公开免疫细胞数据研究某类细胞比例随疾病阶段的变化。比例上升可能来自其他细胞减少,需要考虑绝对数量与组成数据的区别。
营养与天然产物 · Nutrition and Natural Products(NTR)
研究营养及天然来源物质与健康过程的关系。一个可讨论的问题是某种成分与已有代谢指标之间的联系。“天然”不能代替剂量、纯度和安全性证据,不能组织未经批准的自行服用实验。
病理生理学 · Pathophysiology(PAT)
研究正常功能如何变成疾病状态。例如分析某个疾病模型中氧化应激指标与功能损伤的先后关系。应区分伴随现象、可能机制和已验证的致病环节,避免只凭一组相关图作机制结论。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对生物医学与健康科学项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:一个微针贴片,为什么还要研究细胞通路
2023 年项目 BMED011(DiaMiR)把 microRNA 递送与微针贴片结合,研究与二型糖尿病相关的过程。摘要介绍了贴片的成像观察,在肝、脂肪和骨骼肌相关细胞模型中的测量,以及糖尿病小鼠试验。作者报告了细胞葡萄糖输出或摄取的变化,并报告单次贴片处理后小鼠血糖下降持续三至四天。官方项目摘要:23368
看到微针贴片,人们很容易先想到器械。可是这个项目花了很大力气研究疾病相关过程。若只关心针的结构、递送效率和机械性能,容易想到 ENBM;如果重点是 microRNA 怎样影响相关信号与代谢过程,就需要 BMED 的知识。本案例的实际大类登记为 BMED,提醒我们不要仅凭作品照片选类别。
读者可以把证据分开读。成像说明贴片及载入状态的一些特征;细胞实验讨论生物响应;动物实验观察整体结果。这几层证据互相补充,却不能互相替代。细胞中出现变化并不保证递送后仍然有效,动物血糖下降也不单独解释是哪一条通路造成的。
摘要还报告在所测小鼠中未观察到毒性或炎症。本书只保留这一范围,不将它改写为对人安全。完整评价还需要样本量、剂量、对照、观察时间和统计处理等细节,摘要并未全部提供。
对缺少实验条件的学生,更可行的学习任务是画清一项转化研究的证据顺序:材料或装置是否可用,作用对象是否受到影响,整体功能是否改变,还有哪些风险未被检验。这样的阅读能力会帮助你判断自己的项目目前能够回答哪一层问题。
2.5 生物医学工程 Biomedical Engineering(ENBM)
生物医学工程重视面向健康需求的装置、材料和系统。一个可操作的入口,是改善某项测量或辅助装置的具体限制,例如噪声、佩戴位置偏差、结构耐久性或维护难度。
假设你希望做低成本康复训练角度测量装置。先回答参考角度从哪里来,再比较装置在不同角度、速度和安装偏差下的误差。早期可以用机械测试台检验传感器与算法;涉及人员佩戴和试用时,再按人体参与者规则判断并审批。
“能够显示一个数字”只是装置开始工作的证据。还需要说明数字的准确度、延迟和失效条件。如果装置在理想位置下很准,但稍微移动就失准,这个限制本身值得研究。
装置为什么要做成这样,要回到使用需求来解释。你也许为了减轻重量牺牲了一点精度,或者为了方便维护换了传感器,这些取舍都值得写出来。测试处于台架、模拟环境还是获批的人体研究阶段,也应交代清楚。
2022—2026 年官方档案共收录本类 426 个项目,各年依次为 81、83、82、82、98 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
生物材料与再生医学 · Biomaterials and Regenerative Medicine(BMR)
关注材料与生物组织的相互作用及修复用途。例如比较可用材料的力学性质与吸水变化。仅有强度或细胞存活数据,还不能证明体内长期兼容性和再生效果。
生物力学 · Biomechanics(BIE)
用力学解释生物体运动、受力和功能。例如低成本测量能否重建某种步态参数。关键在与可信参照比较,不能把姿态角度直接等同于疾病诊断或损伤风险。
生物医学器械 · Biomedical Devices(BDV)
设计服务于医疗测量、操作或辅助的器械。例如台架模型上两种机构的定位误差。工程原型可以先验证机械性能,但不得把台架成功写成在患者身上有效。
生物医学传感与成像 · Biomedical Sensors and Imaging(IMG)
研究医疗相关信号的测量与图像形成。例如传感器受运动干扰时能否识别无效读数。图像更清晰或波形更稳定,仍需对应到测量准确度与实际任务。
细胞与组织工程 · Cell and Tissue Engineering(CTE)
研究细胞和组织如何被培养、组织或用于修复。可从公开数据研究支架几何与细胞分布的关系。细胞数增加、组织结构形成和恢复器官功能属于不同证据层级。
合成生物学 · Synthetic Biology(SYN)
把生物元件作为可设计的系统来研究。例如比较编码同一蛋白的不同序列对表达的预测。计算设计与实际生物功能之间还有验证距离,序列优化分数不能替代实验结果。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对生物医学工程项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:密码子优化,为什么算法要懂得生物学
2022 年项目 ENBM074(ICOR)研究编码同一蛋白时,怎样选择不同的同义密码子。摘要介绍了用七千多个大肠杆菌基因构建学习数据,以循环神经网络学习序列上下文,并在 1,481 个基因及四十条已有异源表达研究的序列上评价。官方项目摘要:23103
这个案例连接合成生物学,也使用了计算生物学方法。研究并非简单改变蛋白质的名字或功能,而是讨论不同编码方式可能怎样影响表达。神经网络的任务由生物学约束定义,因此评价也不能只用一般文本生成指标。
作者比较了密码子适应性、使用分布、GC 含量及若干序列特征,并与五种方法对照。摘要还报告表达改善,但短文没有展开所有实验来源和验证条件。读者不应仅凭这一表述,认定作者对每条新设计序列都进行了独立湿实验。
理解项目时要追问:训练和测试序列之间是否过于相近?对哪些宿主成立?优化一个指标会不会损害其他生物要求?已经发表的表达结果可以提供有用基准,却与在新条件下亲自验证新设计不同。
学生从这里能学到一种研究组织方式:先写明哪些特征必须保持,再定义可以改变的部分,最后用独立数据检验改变是否有价值。即便开展的是纯计算工作,也要对生物意义负责,不能让一个更高的模型分数替代真正的功能问题。
2.6 细胞与分子生物学 Cellular and Molecular Biology(CELL)
这一领域关注细胞的功能、信号传递、基因调控和分子机制。它与生物化学有交叉,但问题常落在细胞怎样作出反应,以及这种变化由什么机制驱动。
学生可以从公开细胞图像或表达数据学习:不同实验批次是否会影响某类细胞状态的判别?如果模型能够预测“来自哪个实验室”,却不能在新批次上识别状态,就要怀疑它学到的是批次特征。
湿实验项目则需要明确的实验条件和合格监督。细胞来源、培养条件、重复设计及图像定量都可能影响解释。看到某个指标同时变化,通常只能提出相关性;若要支持机制,还需要能区分不同解释的实验。
第一次做这一方向,先把一项测量做可靠。至于机制,如果目前只有线索,就保留为待检验的解释。图画得再完整,也不能补上缺少的实验。
2022—2026 年官方档案共收录本类 238 个项目,各年依次为 41、57、47、50、43 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
细胞生理学 · Cell Physiology(PHY)
研究细胞如何生长、代谢、应对环境与维持状态。例如利用已有时间序列比较应激前后的形态变化。细胞密度、培养批次和图像曝光都可能造成表面差异,需要逐项排除。
细胞免疫学 · Cellular Immunology(IMM)
关注免疫反应在细胞层面怎样发生。例如分析免疫细胞接触目标后的形态与信号变化。观察到细胞被激活,不等于证明它能改善疾病;功能性证据需要另行建立。
遗传学 · Genetics(GEN)
研究基因、遗传信息与细胞性状之间的联系。例如比较公开突变株与对照的表型。遗传背景、脱靶变化及互补实验会影响归因,单个突变株不能承担所有机制解释。
分子生物学 · Molecular Biology(MOL)
研究 DNA、RNA、蛋白质及其调控关系。例如分析某调控因子变化后哪些基因共同响应。共同变化可能来自更上游的原因,相关网络中的一条边不等于直接结合或调控。
神经生物学 · Neurobiology(NEU)
研究神经细胞的结构、发育和分子功能。例如比较公开显微图像中的神经突起分支。图像分割阈值、细胞成熟度与批次应纳入分析,算法产生的分支变化不一定是真实生物差异。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对细胞与分子生物学项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:珊瑚热应激,先看见什么,再解释什么
2026 年项目 CELL025 研究夏威夷珊瑚 Montipora capitata 的热应激与端粒相关变化。摘要介绍了五天的热应激过程,比较处理前后的成像、组织 DNA 和 RNA 测量,并把白化、叶绿素荧光与端粒长度联系起来。官方项目摘要:27889
作者报告,明显白化的样本中端粒长度增加,叶绿素荧光与端粒长度呈负向关系;端粒酶相关亚基在不同条件下的关联也出现变化。项目由环境问题进入细胞与分子层面,因而可以用来理解 CELL 的细胞生理学和分子生物学子类别。
原题中的“immortality”很醒目,但读者不应把标题理解成“珊瑚不会死亡”或“找到了永生机制”。本项目所测的是特定条件下的细胞相关指标。白化、端粒变化和某种维护机制之间,还需要多层证据来连接。
解读这一类案例,最好把句子拆成三种:观察到了什么,哪些现象相互关联,作者用什么机制解释。前两种可以由对应测量支持,第三种往往还需要额外实验。某两项 RNA 测量失去相关,也不能仅凭这一点完全排除一个机制。
学生若分析公开细胞图像,可以先从更小的问题开始:同一结论是否依赖某个阈值或图像筛选办法?当处理方式稍微改变时,结果还在吗?检查结论的稳健性,是理解细胞研究的重要一步,不需要靠扩大生物学宣称来增加分量。
2.7 化学 Chemistry(CHEM)
化学研究组成、结构、反应与性质之间的关系。选题可以围绕检测方法、反应条件、分离过程或材料中的化学变化,但需要提出具体的比较。
以颜色检测为例,手机拍摄能否在不同照明条件下可靠估计某种安全标准溶液的浓度?这项研究需要校准曲线、空白样本、未知样本验证,以及不同手机或光源带来的误差分析。只展示颜色从浅到深的照片,还不足以证明检测能力。
如果研究吸附,不能把颜色变浅直接等同于污染物被彻底去除。还要考虑容器吸附、光照分解、过滤损失和检测干扰。对照设计能帮助区分这些解释。
化学项目的难度经常取决于表征条件。测不到结构,就谨慎讨论结构;测不到副产物,就不声称过程没有副作用。实验前应阅读安全数据表并落实指导、通风和废物处理条件。危险化学品、活动与装置规则
2022—2026 年官方档案共收录本类 321 个项目,各年依次为 73、65、70、46、67 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
分析化学 · Analytical Chemistry(ANC)
关心样品里有什么、有多少,以及怎样测准。例如比较低浓度分析中两种背景扣除方法。需要空白、标准和回收率,不能把仪器给出的每一个小数位都当作真实精度。
计算化学 · Computational Chemistry(COM)
用计算研究分子、反应与化学性质。例如比较不同计算方法对同一组分子能量排序的影响。要说明模型近似及适用范围,并尽量与可获得的实验值比较。
环境化学 · Environmental Chemistry(ENV)
研究化学物质在环境中的来源、转化和归宿。例如某污染物在不同水质条件下如何改变形态。浓度下降可能是吸附、转化或挥发,必须辨别过程,不能一概称为无害降解。
无机化学 · Inorganic Chemistry(INO)
关注无机化合物的组成、结构和反应。例如讨论金属配位环境与可测性质的关系。对照样品需要保持其他条件相近;改变多种组分之后,很难确定哪项变化起主要作用。
材料化学 · Materials Chemistry(MAT)
以化学组成、合成与反应机制为中心研究材料。例如交联方式如何改变水凝胶的结构。与 MATS 的边界在于主问题:解释化学反应更靠近这里,系统评价材料服役性能则可能更靠近材料科学。
有机化学 · Organic Chemistry(ORG)
研究含碳分子的结构、合成和反应。可从文献与公开反应数据分析选择性问题。真正的实验合成需要相应场所与监督,不能把复杂路线当成可以在家照做的步骤。
物理化学 · Physical Chemistry(PHC)
用热力学、动力学和量子等概念解释化学变化。例如比较两种模型对反应速率曲线的解释。拟合优度之外,还要看参数意义、残差和测量误差,避免用复杂模型掩盖错误假设。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对化学项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:吸附轮胎相关污染物,去除率之外要读什么
2026 年项目 CHEM047 研究交联纳米纤维素水凝胶海绵对 6PPD 及其醌类转化产物的处理。摘要介绍了不同交联方式、批次吸附和柱试验,并使用质谱及多种表征方法分析浓度变化与材料结构。官方项目摘要:28609
项目报告,在摘要列出的 1 ppm 条件下,两种海绵都获得超过 60% 的去除率,其中柠檬酸交联海绵在十五分钟内超过 75%。这些数字需要连同浓度、接触时间和测试介质一起阅读;单独摘出“去除 75%”无法判断它在什么条件下成立。
作者把材料结构证据与吸附表现联系起来,因此可以从材料化学、分析化学和环境化学三个角度理解。与 ENEV 的区别取决于主问题:若研究转向长期运行、处理流量、再生与排放标准,工程系统的权重就会增加。
这个摘要也提供了一次很好的批判性阅读练习。作者强调环境相关浓度,但读者仍要核对具体环境中的浓度范围以及各项试验对应的单位。去除率不说明最终水体已经安全,吸附也不等于彻底销毁污染物。处理后的材料怎样处置,同样影响环境价值。
摘要中的成本与能耗降幅还需结合比较边界和规模假设来理解,短摘要没有展开这些细节。学生学习这类研究时,应把“材料有效”“机制可能是什么”“工程应用是否划算”分别写清。一组吸附数据还回答不了后面的所有问题。
2.8 计算生物学与生物信息学 Computational Biology and Bioinformatics(CBIO)
这一类别使用计算方法回答生物学问题。数据通常比设备更容易获得,但理解数据的生成过程并不容易。表达量、序列或图像背后都有实验条件,不能把它们当作没有来源的数字表格。
一个值得讨论的题目是:某种基因表达分类方法在不同研究队列之间是否稳定?学生可以先复现简单基线,再比较批次处理方式,最后在未参与调参的数据中检查结果。研究价值可能来自解释模型为什么失效,而不一定来自刷新某个准确率。
需要补足的知识包括基础分子生物学、数据预处理和统计建模。特征筛选必须放在训练过程内部,不能先用全部数据挑选相关基因,再报告测试效果。否则测试集的信息已经进入模型选择。
解释性图表也需要谨慎。模型认为某个基因有用,不意味着这个基因导致疾病。若只有统计关联,应据实报告,再提出可验证的生物学假设。
2022—2026 年官方档案共收录本类 368 个项目,各年依次为 75、67、57、77、92 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
计算生物建模 · Computational Biomodeling(MOD)
用数学或计算模型表示生物系统。可研究一个反馈模型怎样产生稳定、振荡或失稳。先检查参数是否可识别、不同参数是否给出相同曲线,再讨论模型对真实生物过程的解释力。
计算流行病学 · Computational Epidemiology(EPD)
研究疾病在人群中的传播或分布。例如比较不同接触网络假设对预测的影响。历史数据拟合良好不意味着未来预测可靠,漏报和检测政策变化也会改变数据曲线。
计算演化生物学 · Computational Evolutionary Biology(EVO)
用计算方法研究演化过程。可检验不同基因集合是否支持相同的物种关系。序列比对、模型选择和重采样的不确定性都应进入讨论,不能只展示一棵树便结束分析。
计算神经科学 · Computational Neuroscience(NEU)
用模型理解神经活动和信息处理。例如比较简化神经网络在不同连接方式下的响应。生物机制模型和工程分类器解决的问题不同,分类准确率提高未必说明更接近真实大脑。
计算药理学 · Computational Pharmacology(PHA)
计算药物与生物系统的相互作用。可研究候选分子排序在不同评分方法下是否稳定。筛选结果需要独立证据,模型不确定性大时应缩小结论,而非扩大到临床应用。
基因组学 · Genomics(GEN)
分析基因组及相关大规模分子数据。例如比较不同数据批次中某表达特征是否重复出现。特征选择必须在训练数据内进行;先用全体样本挑基因再划分测试集会产生泄漏。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对计算生物学与生物信息学项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:BIO-PLEX 怎样把结构预测变成生物学问题
2023 年项目 CBIO068(BIO-PLEX)围绕猴痘病毒复制复合体展开计算研究,结合深度学习、同源建模和突变分析,尝试理解暴发相关序列变化的结构意义。摘要报告在所研究复合体的五个组成部分中观察到十个突变,并重点讨论 DNA 聚合酶中的两个位置。官方项目摘要:23910
它可以连接计算生物建模、基因组学和计算药理学:序列比较负责指出差异,结构模型负责提出影响的解释,药物相关分析进一步提出可能的后果。把这几步排清楚,比只说“AI 分析病毒”更能体现研究内容。
在阅读时,要特别留意从预测到因果的跳跃。模型提示结合关系可能变化,可以形成待验证的假设;它并不能单独证明真实人群中的传播性为什么增强。流行过程还受到接触模式、检测和宿主等因素影响。即使原摘要用了更强的措辞,白皮书也不会把计算推测改写成已经证实的传播机制。
学生应追问模型对未知结构部分有多确定,不同建模方案是否给出相同解释,以及突变差异是否受采样地区和时间影响。若对照序列来源不匹配,得到的“暴发特征”可能只是数据集之间的差异。
一个适合学习的缩小版本,是选定一个公开蛋白结构问题,比较若干方法在已有实验结构上的误差,再讨论未知结构部分。这样做看起来没有“预测下次疫情”宏大,却能明确检验计算工具在哪些条件下可靠。
2.9 地球与环境科学 Earth and Environmental Sciences(EAEV)
地球与环境科学研究自然系统怎样变化,包括水文、气候、地质及生态环境过程。环境工程则更偏向设计解决方案;区分类别时,看项目主要解释现象还是评价干预装置。
城市热环境是一个容易理解的入口。比起“绿地能否降温”,可以进一步问:在相近建筑密度下,不同地表覆盖与特定时段温度的关系是否一致?学生应区分卫星测得的地表温度与人们呼吸高度附近的空气温度,它们不能直接互换。
现场测量需要统一传感器放置方式,并记录阴影、风和测量时间。遥感研究则要处理云、空间分辨率以及地面验证不足等问题。相邻像素的相似性,也会使随机拆分的模型测试看起来过于乐观。
一个地点连续一周的结果很难代表全年或整座城市。把空间和时间边界讲清楚,能够让小规模研究仍然有解释价值。
2022—2026 年官方档案共收录本类 409 个项目,各年依次为 90、82、99、69、69 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
大气科学 · Atmospheric Science(AIR)
研究大气中的物理、化学过程及天气相关现象。例如传感器记录的日变化如何关联风速与边界层条件。附近排放、测站高度与仪器漂移都可能混入结果。
气候科学 · Climate Science(CLI)
研究较长时间尺度的气候及其变化。可以用公开长期记录检验趋势对起止年份的敏感程度。几天的异常天气不能单独支持气候趋势,缺测与站点迁移也需要处理。
环境对生态系统的影响 · Environmental Effects on Ecosystems(ECS)
研究环境变化如何影响生态系统。例如干旱年份与植被群落变化是否同步。应区分相关、时滞和可能的共同驱动因素;遥感变绿也不必然代表生物多样性提高。
地球科学 · Geosciences(GES)
研究地球材料、地貌及相关过程。例如不同坡面特征与侵蚀痕迹的关系。空间样点通常相关,不能把一片坡面上密集取样得到的点都当作互相独立的地区。
水科学 · Water Science(WAT)
关注河流、湖泊、地下水或海洋中的自然过程。例如一次降雨后水体浑浊变化怎样传播。取样位置、流量与时间需要配合;研究水的变化和设计净水设备是不同问题。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对地球与环境科学项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:从七个农场的土壤走向卫星估计
2024 年项目 EAEV019(ANOMaLY)尝试用遥感与模型识别农业氧化亚氮排放热点。摘要介绍了六个月内在北卡罗来纳州七个农场采集的 1,200 多份土壤样本,结合 Sentinel-2 影像构造土壤铵态氮、硝态氮相关光谱指标,再把微生物氮过程的方程与神经网络结合。官方项目摘要:24808
这不是卫星直接“看见”每一处氧化亚氮排放。研究先建立可观察量与土壤性质的关系,再通过模型连接到目标过程。作者报告两种土壤光谱指标的 R² 分别约为 0.53 和 0.46,并报告后续区域模型解释了约 80% 的变化。不同数字属于不同环节,不能混成一个准确率。
它适合连接大气科学、气候科学与生态系统影响。真正需要理解的是测量链条中的每一步,而非模型中用了多少先进名词。如果第一步对某类土壤不适用,后续预测也会受影响。
一个关键问题是外部适用性:七个农场的数据能否代表不同土壤、作物和气候?怎样划分训练与测试,才能避免同一农场相邻时段过于相似?摘要中的全球应用展望,不等于全球各区域都经过现场验证。
学生可以把这一案例缩小为本地研究:选一个能找到参照记录的区域,检验某个遥感指标在不同季节是否稳定。研究“何时失效”并不比报告平均误差低一分逊色,因为它直接决定一个方法能不能被别人可靠使用。
2.10 嵌入式系统 Embedded Systems(EBED)
嵌入式系统关注软硬件结合的专用计算与控制。传感器节点、实时信号处理、边缘计算和低功耗系统都可能进入这一类别。研究贡献应落在系统性能或设计判断上,而不只是把现成模块连接起来。
例如,在校园环境监测中,能否根据变化速度调整采样频率,同时减少耗电并保留重要事件?需要比较固定采样与自适应采样,在相同硬件、相同输入下测量能耗、漏报和延迟。
平均延迟有时会掩盖偶发卡顿。对需要及时响应的系统,还应观察较慢的一部分情况,以及断网、低电量或传感器漂移时怎样表现。测试条件越接近真实限制,工程判断越有说服力。
学习这类系统时,试着追踪一次测量的全过程:信号从哪里进入,程序何时处理,通信在哪一步等待,电量又消耗在哪里。读懂这条过程,才容易找到真正值得改进的地方。如果主要计算都在服务器上完成,还应检查项目的贡献是否更适合软件类别。
2022—2026 年官方档案共收录本类 217 个项目,各年依次为 41、43、41、43、49 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
电路 · Circuits(CIR)
研究电路怎样实现特定功能。例如两种滤波电路在同样噪声输入下的精度与功耗。测量仪器的带宽和自身噪声会限制结论,仿真与实测也应分开报告。
物联网 · Internet of Things(IOT)
关注联网设备的协作、数据获取和远程使用。例如校园传感节点在断网后能否保留完整记录。网络连接成功只是起点,丢包、延迟、能耗和故障恢复才构成可比较的研究指标。
微控制器 · Microcontrollers(MIC)
把微控制器的资源约束作为研究问题。例如在内存和功耗受限时怎样完成实时识别。比较应包含处理时间分布与最坏情形,不能只报告一次顺利运行的平均速度。
网络与数据通信 · Networking and Data Communications(NET)
研究设备之间怎样传递数据。例如干扰或节点增多时通信协议的可靠性如何改变。应记录丢包和重传,并控制距离、功率与数据量,避免比较条件不一致。
光学 · Optics(OPT)
研究嵌入式设备中的光学元件和光电方法。例如低成本成像系统怎样校正镜头畸变。照明和几何条件必须可重复;算法补偿不能替代对光学误差来源的理解。
传感器 · Sensors(SEN)
研究把物理或化学量转换为信号的传感过程。例如同型号湿度传感器之间的偏差有多大。校准、迟滞、温度影响和长期漂移往往比屏幕上能否显示读数更有研究价值。
信号处理 · Signal Processing(SIG)
从采集信号中提取有意义的信息。例如滤波怎样同时影响噪声与短暂事件的保留。降噪后的曲线更平滑,不代表信号更准确;应检验是否抹去了真正需要识别的变化。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对嵌入式系统项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:四个模块机器人,研究重点可以在嵌入式系统
2023 年项目 EBED004 构建了一个自动组装的模块化机器人系统。摘要介绍,每个模块有四个自由度、轮式移动、蓝牙与 Wi-Fi 通信以及电磁连接结构;系统结合 AprilTags、视觉处理与 PID 控制完成定位和运动。作者制作了四个模块,并测试不同组合下的速度、负载速度和连接强度。官方项目摘要:23358
虽然成品是机器人,它实际登记在 EBED。这个例子说明,机器人外形并不必然意味着应报 ROBO。通信、执行、电路和实时协调可以构成嵌入式系统的核心;若贡献主要在自主决策或新运动方法,分类判断又可能不同。
摘要提供了具体的工程比较对象:模块怎样连接,组合后能做什么,负载会怎样改变表现。这比单独展示“四台机器一起动起来”多走了一步。一个可自组装的系统还要证明连接足够可靠,感知误差不会让组装过程频繁失败。
继续阅读时应追问:组装成功率是多少,失败后能否恢复?视觉标记在遮挡或照明变化时怎样表现?连接强度的测试是否覆盖不同受力方向?这些是从系统功能引出的评价问题,本书没有把它们写成原作者已经完成的测试。
如果你也在做机器人,可以先列出每个部件必须完成的动作,再想办法测量它们组合后的表现。即使只做一个连接机构,也可以研究对准误差、承载能力和反复连接后的磨损。项目大小并不决定证据是否完整。
2.11 能源:可持续材料与设计 Energy: Sustainable Materials and Design(EGSD)
能源项目常围绕能量转换、储存和使用效率展开。太阳能、储能和热管理都是值得学习的方向,但“绿色”“高效”必须落到明确的测量范围。
例如,研究一种被动散热结构能否降低小型光伏模块在特定条件下的温升,并改善实际输出。公平比较需要尽量一致的光照、朝向与环境温度,还要考虑结构本身增加的材料和体积。
应同时理解功率与能量:某一时刻输出更高,不必然意味着一天总发电量更多。若讨论节能,还要说明是否计入辅助风扇、控制器或制备过程的消耗。
高温、高电流、电池拆装和化学储能可能带来风险。学生可以选择条件可控的小尺度研究,不必通过提高能量或危险程度来增加“项目分量”。结论应对应实际测试条件,不把实验室效率直接写成完整生命周期的环保优势。
2022—2026 年官方档案共收录本类 261 个项目,各年依次为 52、60、50、48、51 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
生物过程与设计 · Biological Process and Design(BIO)
研究与生物过程有关的能源转化或设计。例如用公开数据比较某生物能源路线的投入与产出。计算边界应包括原料处理与副产物,不能仅凭“来源可再生”判断整体能源收益。
太阳能过程、材料与设计 · Solar Process, Materials, and Design(SOL)
研究太阳能转换的材料、结构和系统。例如不同遮挡方式下输出如何改变。比较要控制辐照度、温度和面积;某一时刻峰值高,不等于一天发电量高。
储能 · Energy Storage(EST)
研究能量如何储存与释放。例如用公开电池循环记录比较容量预测的跨电池误差。单次容量、长期衰减和功率能力是不同指标,不能用一个“效率”包办所有性能。
风能与水流发电 · Wind and Water Movement Power Generation(FLD)
研究风或水流中的能量获取。例如不同叶片设计在多个流速下的输出。输入流场与装置尺度必须说明,小风扇试验的排序未必能直接推广到真实风场。
制氢与储氢 · Hydrogen Generation and Storage(HYD)
研究制氢、储氢及相关材料。可比较文献中催化剂性能随测试条件的变化。电流密度、有效面积、过电位和稳定性需要一起读,单个漂亮数字不足以比较不同实验室结果。
热能发电与设计 · Thermal Generation and Design(THR)
研究热能怎样转换、利用或管理。例如温差发电装置在不同散热条件下的净输出。维持温差消耗的能量也要计入,不能只计算输出而漏掉驱动系统。
摩擦起电与电解 · Triboelectricity and Electrolysis(ELC)
包括摩擦起电、电解等相关能源过程。例如评价一个能量采集器在相同机械输入下的可用输出。开路电压高不意味着能持续带动负载,应看负载匹配和实际输出能量。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对能源:可持续材料与设计项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:同一材料既制氢又储氢,怎样比较才公平
2022 年项目 EGSD018 对一种金属有机框架材料进行改性,研究其制氢相关电催化与储氢表现。摘要介绍了活性炭引入、镍掺杂和结构表征,并分别开展电化学与吸附相关评价。官方项目摘要:21893
作者报告,相对所比较的原材料,比表面积和储氢表现有所改善,并给出了与另一催化材料的电化学比较。这里的“两个用途”很吸引人,但学生需要先看两项用途是否在相同材料状态、各自合适的条件下得到验证。
这个案例主要连接制氢与储氢子类别,也与 MATS 的材料结构和 CHEM 的反应研究相邻。若想判断能源价值,不能停留在表征图上:结构为何有助于目标过程,输出改善付出了什么成本,材料能否在多次使用后保持表现,都需要讨论。
对电催化数字,读者应核对电位参照、电解液、面积口径与测试时间。对储氢数字,需要知道温度、压力以及按质量还是体积报告。摘要并未给出足以独立重建全部比较的细节,本书因此不把其中成本倍数改写成规模化系统优势。
如果学生只有计算和文献条件,可以做一份条件明确的对照综述:仅比较同类测试体系的数据,把无法换算的结果单列。能发现文献中两个醒目的数字其实不具可比性,本身就是开始理解一个领域的标志。
2.12 工程技术:静力学与动力学 Engineering Technology: Statics and Dynamics(ETSD)
这个类别适合对机械、结构、运动和制造感兴趣的学生。研究往往从限制出发:材料有限、重量受限、载荷变化,怎样设计更合适?
一个具体问题是:在相同材料用量下,不同连接方式如何影响轻型结构的反复加载寿命?只测第一次压坏时的最大载荷,会漏掉长期使用中的变化。根据目标,研究可能更需要记录变形、连接松动和破坏过程。
仿真能帮助筛选方案,但要说明材料参数、边界条件和简化假设。若仿真与实验不一致,先检查夹具、接触和制造误差,不要只保留吻合的一组图。
先只改一个有理由改变的结构细节,再看结果。若同时换了材料、厚度和连接方式,即使性能更好,也难以判断哪一次改变起了作用。制作缩小模型时,还要想清楚哪些关系会随尺寸改变。
2022—2026 年官方档案共收录本类 337 个项目,各年依次为 82、69、75、56、55 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
航空航天工程 · Aerospace and Aeronautical Engineering(AER)
研究航空航天系统的结构、运动或性能。例如小尺度翼型在不同迎角下的升阻变化。雷诺数、支撑干扰与测量误差会影响结论,模型实验需要说明与实际飞行的距离。
土木工程 · Civil Engineering(CIV)
研究建筑、桥梁、道路等结构与设施。例如不同连接方式在重复载荷下的变形。承载峰值只是一个方面,还应记录失效模式和变形,不能把模型结果直接当作工程安全认证。
计算力学 · Computational Mechanics(COM)
用数值方法分析结构、流体等力学问题。例如网格加密后应力或流量结果是否收敛。彩色云图很容易生成,边界条件和与实验的对应关系才决定它是否有意义。
控制理论 · Control Theory(CON)
研究系统怎样保持目标状态或跟踪指令。例如控制器面对负载变化时的响应。上升快、振荡小、能耗低未必同时成立,评价应包含扰动和异常条件。
地面车辆系统 · Ground Vehicle Systems(VEH)
关注陆地车辆的部件与系统。例如不同轮胎或悬架参数对台架响应的影响。道路、速度、载荷变化需区分,安全条件不允许时应采用模型或公开数据。
工业工程与工艺 · Industrial Engineering-Processing(IND)
研究生产流程、制造和资源组织。例如回收线材设备的产量、合格率和单位能耗如何平衡。设备能运转还不够,应说明输出是否达到用途要求。
机械工程 · Mechanical Engineering(MEC)
研究机构、机器部件及其运动和受力。例如不同连接结构的刚度与耐久性。一次成功动作难以说明可靠性,需要重复运行、负载变化与失效记录。
船舶系统 · Naval Systems(NAV)
研究船舶与水上系统。例如模型船体在不同载荷下的阻力。水槽尺度、波浪和边界效应需要说明,不能把静水模型结果直接外推到海况。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对工程技术:静力学与动力学项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:把废塑料做成打印线材,设备运行以后还要测什么
2025 年项目 ETSD057 将挤出与拉挤思路结合,尝试把塑料瓶、打印废料等转为新的打印线材。摘要介绍自制设备、冷却与收卷单元,测试了三十多组温区组合,并经历五十多次部件迭代。官方项目摘要:27348
这个项目连接工业工程与工艺、机械工程,也与 ENEV 的回收主题相邻。若核心贡献是设备和加工过程,ETSD 很容易解释;若重点改为整个回收体系的环境收益,就需要补充另一类证据。
摘要给出能耗、线材公差和效率估计,也明确指出还需要进一步优化。阅读这些结果时,最重要的是找到分母:一批加工的用电量对应多少合格线材?设备产出的线材能否稳定打印?把原料变成线状物,与得到符合用途的材料是两回事。
作者报告的约 45% 效率改善属于摘要中的估计。它与完整的能耗审计仍有区别。温区、原料含水量、混合程度和废品比例都可能改变比较结果,尤其需要避免只比较顺利加工的一小段时间。
工程初学者容易在设备第一次成功运行时松一口气。这项线材研究提醒我们,后面还有尺寸、质量、能耗和连续运行等问题。做出第一个版本后,研究才进入真正需要取舍的阶段。若你只有一个小型机构,也可以用“单位合格产出的能耗”“连续运行失败次数”这样的指标,代替只展示成品照片。
2.13 环境工程 Environmental Engineering(ENEV)
环境工程关注污染治理、资源回收和环境监测等解决方案。一个方案是否值得采用,通常同时取决于效果、能耗、维护与产生的新废物。
例如,研究某种滤材对安全替代颗粒的截留能力,先在受控测试中比较颗粒大小、流量和压差。截留率很高却几乎不出水的滤材,未必适合实际使用。再生和重复使用后的表现,也可能比初次实验更重要。
如果使用替代物,应解释它与目标污染物在哪些性质上相近、在哪些方面不同。用易测的染料代表复杂污染物时,结论必须保留这种限制。
环境工程很容易把愿景写得过大。一台小装置在实验室表现良好,可以支持进一步验证;要推断它能处理城市污水,还需要远超中学生项目的流量、成分和运行证据。把当前阶段写准确,会更有说服力。
2022—2026 年官方档案共收录本类 431 个项目,各年依次为 98、86、81、78、88 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
生物修复 · Bioremediation(BIR)
研究利用生物过程修复污染。例如比较已有资料中不同条件下污染物转化的表现。污染物消失不代表产物无害,过程稳定性和处理后的风险同样需要评价。
土地复垦 · Land Reclamation(ENG)
关注受损土地和相关环境系统的恢复。例如怎样监测湿地修复后的水文变化。植被恢复、地表抬升和碳储量增加不是同一个指标,监测方法应与修复目标对应。
污染控制 · Pollution Control(PLL)
设计减少污染产生、释放或暴露的方法。例如过滤装置的捕集率与压降如何取舍。只在清洁介质中测效率不够,还要考虑真实污染物组成和运行后的性能衰减。
回收与废弃物管理 · Recycling and Waste Management(REC)
研究废物减量、回收和再利用。例如回收塑料多次加工后的性能还能否满足用途。新的回收过程也消耗水和能源,不能只凭原料来自废弃物就宣布总体更环保。
水资源管理 · Water Resources Management(WAT)
研究水资源利用、处理和管理方案。例如比较供水系统不同调度策略的可靠性。技术效果、运行成本与水质要求应分别验证,演示“水变清”不能证明可以饮用。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对环境工程项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:泥炭地修复,怎样知道环境正在恢复
2024 年项目 ENEV016 使用多光谱、合成孔径雷达和干涉雷达观测,研究爱尔兰泥炭地修复的监测方法。摘要介绍六个不同退化或保存状态的地点,分别观察植被、湿度与地表运动等变化。官方项目摘要:24920
多光谱分析能提供植被和湿度相关信息,但受到云影响;雷达提供了另一类观测,干涉分析则帮助考察沉降或地表高程变化。作者报告,多传感器信息可支持修复进展评价。它与土地复垦、水资源管理相连,也说明环境工程不一定要求学生亲自建造大型处理装置。
云挡住光学观测时,另一种传感方式可能提供帮助;地表运动又回答不同的问题。各类数据因此有了放在一起的理由。把它们放在一起,应当是为了补足观察能力,而不是为了在标题里列更多技术。若多种方法给出相反结果,差异本身也需要解释。
同时,湿度增加、沉降减少和碳储量增加不能直接画等号。摘要讨论碳汇应用前景,但要定量证明净碳收益,还需相应碳收支证据。遥感中的恢复信号,应先按它实际测到的内容报告。
对学生,一个可行的缩小问题是比较两种观测方法在某类天气或季节的缺测与误差。若缺少现场碳通量测量,就把结论写成“监测植被或水文变化的可行性”,而不是“证明修复抵消了多少排放”。清楚知道自己没有测什么,是好研究的一部分。
2.14 材料科学 Materials Science(MATS)
材料科学关心制备、结构、性能之间的联系。新配方只是起点。研究应说明它为什么改变性能,以及获得某种优势时是否牺牲了另一种性质。
例如,用安全可获得的材料制成可降解薄膜,比较添加比例如何影响强度、吸水和湿度稳定性。若某一配方更结实,却在潮湿环境迅速失效,研究需要把这两项结果一起解释。
不同批次的样品尤其重要。从同一张薄膜剪下许多小片,可以观察片内差异,却不能充分代表独立制备的稳定性。学生应说明多少次独立制备、每次测了多少试样。
没有结构表征时,可以提出合理机制,但要把推测与实测分开。“可降解”也有条件:在某一温度和介质中质量减少,未必说明在自然环境中会完全降解。研究标题不应超过测量能支持的范围。
2022—2026 年官方档案共收录本类 314 个项目,各年依次为 55、56、54、67、82 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
生物材料 · Biomaterials(BIM)
研究用于生物相关环境的材料性质。例如材料浸润前后强度如何变化。与 ENBM 的联系很近;若核心是材料组成、结构和性能,MATS 可能更适合表达贡献。
陶瓷与玻璃 · Ceramic and Glasses(CER)
研究陶瓷、玻璃的结构和性质。例如不同烧结条件对应的孔隙与强度变化。加工历史会显著影响结果,比较样品时需要记录尺寸和制备批次。
复合材料 · Composite Materials(CMP)
研究多种组分结合后产生的性能。例如纤维含量增加时,强度与吸水性怎样共同变化。不能只选一个最好的样品,分散性、界面与批次差异都需要解释。
计算与理论 · Computation and Theory(COM)
用计算和理论研究材料行为。例如模拟缺陷怎样改变应力分布。模型尺度和假设会限制结论;分子尺度的变化不能未经衔接就解释宏观寿命。
电子、光学与磁性材料 · Electronic, Optical and Magnetic Materials(ELE)
研究电子、光学和磁性功能材料。例如处理条件如何影响导电性与稳定性。性能需要在同样温度、湿度和测量条件下比较,也要报告器件间离散程度。
纳米材料 · Nanomaterials(NAN)
研究纳米尺度结构及其性质。例如粒径分布与某种可测性能的关系。平均粒径会隐藏很宽的分布,“纳米”本身不是创新点,更不自动意味着安全。
高分子 · Polymers(POL)
研究高分子的结构、加工与性能。例如交联程度怎样影响吸水和弹性恢复。分子结构、样品厚度与含水量会共同影响结果,应避免一次改变太多变量。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对材料科学项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:更结实的再生纸,为什么可能吸水更慢
2026 年项目 MATS040 用食物废弃物来源的纤维素与果胶制成吸水片材,研究钙离子交联对性能的影响。摘要介绍材料制备、吸水过程建模,以及用响应面和多目标比较选择配方。官方项目摘要:28166
作者报告,某些配方以吸水速率下降约 20%—40% 为代价,换取两至三倍的强度提升;也报告交联与未交联样品之间的湿态强度差异。这里最值得读的正是这种取舍。材料并不总能在所有指标上一起变好。
这个项目连接复合材料和高分子:纤维提供一种结构,果胶及交联网络改变浸水后的表现。与一般“废物做成新产品”的展示相比,研究问题具体落在组成、结构与性能的关系上。
需要继续检查的细节包括:试样厚度和单位面积质量是否一致,拉力是否按截面积规范化,吸水总量与吸水速度怎样分别测量。不同大小的样品吸水量不同,不一定说明材料本身更好。摘要中的规模化成本也依赖假设,不能与零售价格不加说明地直接比较。
学生可以借这个案例练习画一张两指标图:横轴放湿态强度,纵轴放吸水速度,标出每个配方。某个点不在所有方向最好,却可能最适合具体用途。解释这种选择,比宣布“我们找到了最佳材料”更有说服力。
2.15 数学 Mathematics(MATH)
数学项目的主要成果可能是定理、证明、反例、算法性质或新的表达方式。它不一定需要实验室,却需要较长时间理解定义、已有结果和论证细节。
适合起步的问题通常有明确边界。例如,在某类受限图上研究一个组合量的上下界,先计算小规模情况,形成猜想,再寻找证明或反例。数值结果可以提示方向,但不能代替对所有情况成立的证明。
读文献时,应特别注意条件。去掉一个假设、推广到一个新对象,听起来只改了一句话,实际可能使问题难度大幅增加。学生可以先证明特殊情况,解释为什么一般情况还没有解决。
展示数学项目时,最难的往往是让专业背景不同的评委理解问题。可以准备一个小例子说明对象,再讲主要结论和证明思路。把长证明压成满墙公式,通常不如清楚解释关键转折。
2022—2026 年官方档案共收录本类 198 个项目,各年依次为 39、42、37、41、39 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
代数 · Algebra(ALB)
研究代数结构及其性质。例如从小规模对象中发现某种结构规律,再尝试给出一般证明。计算穷举能帮助找反例,但不能自动覆盖无限多情形。
分析 · Analysis(ANL)
研究极限、函数、方程与连续变化。例如证明某类方程解的存在性或某数值方法的误差界。要写清假设和适用域,不能只用有限条曲线支持普遍命题。
组合数学、图论与博弈论 · Combinatorics, Graph Theory, and Game Theory(CGG)
研究离散结构、网络、计数与策略互动。例如图上的某个配置能否达到最优界。先弄清问题规模、目标和可行条件,再区分构造例子、算法和最优性证明。
几何与拓扑 · Geometry and Topology(GEO)
研究空间形状以及在变换下保持的性质。例如某种连接结构怎样影响可变形范围。直观图形能引导猜想,证明仍须处理图中看不到的边界和退化情形。
数论 · Number Theory(NUM)
研究整数、整除、素数等对象。例如某类数列的整除性质是否总成立。检验很多项仍可能漏掉很晚出现的反例,应寻找规律成立的原因。
概率与统计 · Probability and Statistics(PRO)
研究随机现象、推断与估计。例如在样本有限时比较估计方法的偏差与区间覆盖率。模拟需要明确数据生成机制,结论不能越过所设定的分布条件。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对数学项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:证明一种方程不能这样求解,也是一项成果
2026 年项目 MATH006 研究某些亚纯函数方程的解能否用初等函数表示。摘要先指出已有工作处理过的方程与函数范围,再提出更一般的条件,并说明证明结合了置换群相关定理与拓扑伽罗瓦理论中的方法。官方项目摘要:27611
对尚未学过这些理论的读者,可以先抓住问题结构:已知某些方程没有某种形式的解,能否说明一大类方程都如此?“不能用规定的表达方式写出解”是明确的数学结论,不是计算机暂时算不出来。
它连接分析与代数,也借助拓扑观点。数学子类别之间会互相借用工具,报名不应根据论文里出现最多的术语机械计数。更好的判断是主定理在回答什么问题,以及谁最能评价证明。
阅读这类作品,首先要区分引用的定理、作者提出的新命题,以及把前者用于后者的关键步骤。摘要本身不足以检验证明是否完整,本书也不据短文替作者补出证明。真正评价需要查看全文,检查假设、例外与推理细节。
学生不必一开始追求同样高级的题目。可以从一个可理解的猜想出发,先验证小规模情形,尝试寻找反例,再判断需要什么结构性理由。计算帮助探索,证明解释为什么成立;两者都重要,但承担的任务不同。
2.16 微生物学 Microbiology(MCRO)
微生物学研究微生物及其活动,与生态、医学和工业过程都有联系。对中学生而言,最先需要确定的是安全条件和材料来源,之后才是实验的方便程度。
有明确来源的教学菌株或公开微生物组数据,可以成为讨论起点;具体是否允许、需要何种实验条件,应按项目判断。不要把“来自厨房”“环境里到处都有”视为安全依据。官方对居家培养微生物等活动设有明确限制。潜在危险生物因子规则
数据研究中,一个可讨论的问题是:微生物组分类结果对测序深度或分析流程有多敏感?这需要理解相对丰度、批次效应与污染,不只是把数据送入分类器。
湿实验中,生长抑制不等于杀灭,某一测量值变化也不必然代表微生物数量改变。若实验没有直接测量某个过程,就不要用更强的词描述它。研究的安全边界与结论边界,都需要学生讲得清楚。
2022—2026 年官方档案共收录本类 271 个项目,各年依次为 63、65、41、58、44 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
抗微生物剂与抗生素 · Antimicrobials and Antibiotics(ANT)
研究抗微生物作用、药物响应及耐药机制。例如从公开实验数据比较联用药物是否产生额外效果。抑制生长不等于杀灭,也不等于对人体安全;实验实施必须符合相应生物安全要求。
应用微生物学 · Applied Microbiology(APL)
研究微生物在生产、环境或其他任务中的用途。例如在获准条件下比较一个发酵过程的产量与稳定性。应区分菌体增长和目标产物增加,不能仅凭气泡多少判断工艺优劣。
细菌学 · Bacteriology(BAC)
以细菌的结构、功能和行为为中心。例如分析公开显微图像中的细胞形态变化。菌株身份和培养条件会影响解释,未知环境菌不能当作无风险的教学材料。
环境微生物学 · Environmental Microbiology(ENV)
研究微生物与环境之间的联系。例如公开群落数据中哪些变化与水文条件相伴。测序读数是相对数量,不能直接等同于环境中的绝对生物量。
微生物遗传学 · Microbial Genetics(GEN)
研究微生物的遗传变异及其功能。例如比较公开菌株基因组中的耐药相关变异。拥有某个基因不保证在实际条件下表达出对应性状,需要保留基因型与表型的区别。
病毒学 · Virology(VIR)
研究病毒的组成、演化与宿主关系。公开序列和已有结构数据可以支持计算比较。计算预测的结合变化不能单独证明感染力变化,也不构成开展病毒实验的理由。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对微生物学项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:增强抗真菌作用,怎样判断是通过什么机制
2026 年项目 MCRO017 从已有化合物资源中寻找外排抑制剂,希望恢复耐药白色念珠菌对氟康唑的响应。摘要介绍候选物筛选、最低抑菌浓度、外排相关测量,以及人肝细胞毒性和不同真菌形态下的活性评价。官方项目摘要:28328
这里的主要问题与抗微生物剂和抗生素子类别相连。研究并不只是寻找“让生长变慢”的物质,而是尝试解释联用效果是否与细胞将药物排出的过程有关。这个机制问题决定了除了抑菌指标,还应测什么。
作者报告两个候选化合物具有外排抑制相关作用,其中一个在所测有效浓度下表现出较低的肝细胞毒性。这仍是特定模型和条件中的结果。本书不会从中给出临床用药建议,也不会把“低毒”解释为所有组织、剂量与使用时间都安全。
评价时可以追问:候选物单用和与氟康唑联用分别怎样?观察到的外排变化能否由细胞整体受损解释?不同菌株是否重复了结果?机制与功能应有相互支持的测量,不能用同一个终点反复证明所有主张。
这个方向对实验场所和监督的要求较高,不能把真实案例视为家庭实验教程。没有条件的学生可以从公开耐药数据入手,比较同一结论在不同菌株、测定条件中的稳健性。先学会读懂“有效”的限定条件,比贸然复制实验更有价值。
2.17 物理与天文学 Physics and Astronomy(PHYS)
物理项目重视模型、测量和可检验的预测。天文学则为学生提供了使用公开观测数据的机会。两者都需要区分真实信号、仪器效应和数据处理带来的痕迹。
例如,研究在不规则采样与不同噪声水平下,周期信号检测方法何时可靠。学生可以将已知信号加入模拟数据,检查恢复情况,再在合法取得的真实观测中验证。这样能够知道方法对什么样的信号敏感,也知道它容易产生哪些误报。
桌面物理实验同样可以有深度。研究振动阻尼时,应检查传感器采样、边界固定和拟合区间是否影响参数估计。一条漂亮拟合曲线并不能自动证明模型正确。
如果做模拟,必须说明方程、初始条件和数值误差。计算结果与某种理论一致,只说明在测试条件下没有发现冲突;不要把有限模拟写成对理论的普遍证明。
2022—2026 年官方档案共收录本类 365 个项目,各年依次为 74、66、69、75、81 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
原子、分子与光物理 · Atomic, Molecular, and Optical Physics(AMO)
研究原子、分子、光与物质的相互作用。例如用合适的教学装置测量光学系统的分辨能力。仪器响应、背景和几何校准需要先解释,不能把所有峰值都认作物理信号。
天文学与宇宙学 · Astronomy and Cosmology(AST)
研究恒星、行星、星系及宇宙尺度的问题。例如在公开光变数据中寻找周期。观测窗口、仪器系统误差与多重搜索都可能制造假信号,应有独立核验方法。
生物物理 · Biological Physics(BIP)
用物理原理研究生命系统。例如细胞或组织的形变怎样对应简化力学模型。模型参数可能只是有效描述,不能在没有证据时赋予它具体分子机制。
凝聚态与材料 · Condensed Matter and Materials(MAT)
研究凝聚态及材料中的物理现象。例如结构变化如何影响电输运。与 MATS 相比,这里往往更强调解释物理机制,而不只评价材料是否适合某项用途。
力学 · Mechanics(MEC)
研究运动、力、流体等经典问题。例如薄片折叠的几何约束怎样改变运动范围。需要区分理想模型与摩擦、厚度等现实因素;模型失效的位置也值得研究。
核物理与粒子物理 · Nuclear and Particle Physics(NUC)
研究核与粒子相关现象。公开探测数据可以用来讨论背景剔除和信号识别。原始计数、探测效率与物理发生率不是同一概念,器材与辐射相关研究另有严格要求。
理论、计算与量子物理 · Theoretical, Computational, and Quantum Physics(THE)
发展理论、计算模型或量子相关方法。例如在简单模型上比较数值算法的误差与代价。软件跑通并不等于理论成立,需检查守恒量、已知解和收敛行为。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对物理与天文学项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:太阳风数据怎样帮助思考聚变加热
2026 年项目 PHYS030T 把 Parker Solar Probe 的太阳风观测与托卡马克加热模拟联系起来。摘要介绍波动诊断、无量纲参数映射和多种计算模型,并在一百个候选配置中比较离子加热相关结果。官方项目摘要:28377
作者报告,受太阳探测数据启发的一个配置,在模拟中的离子吸收功率优于所比较的参考配置,并报告计算效率改进。这里的结果属于模型研究,不能写成真实聚变装置已经按该方法实现对应性能,更不能外推为整套电站能效。
这个案例跨越天文观测与理论计算。两种系统的尺寸和环境相差很大,联系它们的关键是相应物理关系及适用条件,不是把两个数据集送进同一个模型就足够。无量纲比较的意义,在于讨论哪些关系可能跨尺度保留。
学生应关注参考方案怎样选择,候选参数是否使用同等的搜索预算,模型对哪些参数敏感,以及计算是否满足已知物理约束。若一个方案经过更充分的调优,另一个只用默认值,优势就可能来自比较不公平。
可迁移的学习方法是先做一个小模型,找出有已知解或守恒规律的情况,再逐步加入复杂性。不要一开始就追逐多种软件联用。能解释一次模型失效,比列出一长串模拟工具更能说明你理解了物理问题。
2.18 植物科学 Plant Sciences(PLNT)
植物科学研究植物的生长、生理、繁殖以及环境适应。它适合持续观察,但生长周期、季节和场地条件需要提前计入计划。
例如,比较不同浇水节奏对一种常见植物恢复能力的影响。即使总用水量相同,分配方式也可能影响生长;要把这点研究清楚,需要统一起始条件、随机安排位置,并记录温度和光照。
一盆里的多株植物共享土壤和浇水条件,不能轻易当成完全独立的样本。研究者应先决定实验单位是植株、花盆还是生长箱。独立重复不足时,多拍照片不会自动增加证据强度。
生长更快也不一定意味着整体更好。根据问题,可能需要比较生物量、叶片状态、用水量或恢复时间。提前选定主要指标,有助于避免结束后只挑最有利的结果。
2022—2026 年官方档案共收录本类 282 个项目,各年依次为 54、57、66、55、50 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
农业与农艺学 · Agriculture and Agronomy(AGR)
研究作物及农业管理。例如在合规条件下比较不同灌溉策略的用水与生长表现。产量、品质和投入需要一起看,盆栽结果不能直接代表田间规模。
生态学 · Ecology(ECO)
研究植物与环境、其他生物的相互作用。例如城市遮阴条件与植物群落的关系。土壤、维护方式和季节可能同时变化,不能仅凭一项环境变量解释全部差异。
遗传与育种 · Genetics and Breeding(GEN)
研究植物遗传与育种。例如公开品种数据中的抗逆性差异能否在不同环境下重复。单地点优势可能来自特定环境,需考虑基因与环境之间的交互。
生长与发育 · Growth and Development(DEV)
关注萌发、生长、开花等阶段如何受到调控。例如根系对水分分布的响应。记录整个过程往往比只测最后高度更有帮助;更高不一定意味着更健康或生物量更多。
病理学 · Pathology(PAT)
研究植物疾病及其发生过程。例如用公开图像研究早期症状的可辨识性。图像标签、品种与拍摄环境都可能混淆分类,病斑识别不能自动替代病原诊断。
植物生理学 · Plant Physiology(PHY)
研究光合、运输、代谢等功能。例如叶片状态如何随水分条件变化。叶色只能提供间接线索,不能不经验证就把图像亮度当作光合作用速率。
系统学与演化 · Systematics and Evolution(SYS)
研究植物分类与演化关系。例如形态鉴定与公开分子序列结果是否一致。杂交、近缘种和参考库误标都可能造成差异,需要讨论证据冲突。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对植物科学项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:植物长高了,就代表生长得更好吗
2025 年项目 PLNT026 使用三维回转装置,并结合水分分布与磁场条件,研究葱的形态响应。摘要报告了茎和根的长度、数量、生物量及叶绿素等多个指标,讨论不同方向性刺激之间的联系。官方项目摘要:26569
这个案例主要连接生长与发育、植物生理学。作者报告,某些条件下茎伸长,但生物量可能下降。这能纠正一个常见的入门误解:只测株高,很容易把某种应激反应误写成促进生长。
回转装置的“模拟微重力”也需要谨慎理解。它改变植物感受到的重力方向条件,不等同于真正消除地球重力;转动还可能带来其他机械与环境影响。读者应查看装置参数和适当对照,而非只沿用标题里的太空农业背景。
摘要讨论了激素、离子或信号等可能机制,但并没有为每一种机制列出直接测量。本书将这些保留为作者的解释性假设。形态变化、统计差异与分子机制应分开表达。
如果学生尝试类似的生长问题,先用少量因素建立能稳定记录的系统通常更合理。记录起始大小、连续变化、终点生物量,并事先决定主要指标。因素一多,每个组合所需的独立样本也随之增加,复杂装置可能反而挤占了必要的重复。
2.19 机器人与智能机器 Robotics and Intelligent Machines(ROBO)
机器人项目研究机器如何感知、决策并行动。机械平台可以购买或借用,但学生应清楚说明自己的贡献在哪个环节,以及这一环节怎样改变系统表现。
例如,在光照变化和部分遮挡下,移动机器人能否用更少的计算稳定避障?需要设置可重复的场景,比较基线方案,记录碰撞、任务完成率、路径长度和耗时。不要只用一段成功视频代表系统能力。
仿真测试可以扩大场景范围,实物测试则会暴露摩擦、传感器误差和电机响应等问题。如果只能完成仿真,应如实限定结论,讨论距离真实部署还缺哪些验证。
有些学生会不断加摄像头、机械臂和语音功能,最后难以解释哪部分是研究。较好的做法是先明确一个性能问题,把其他功能控制在支持测试所需的范围内。
2022—2026 年官方档案共收录本类 373 个项目,各年依次为 85、76、82、69、61 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
生物力学 · Biomechanics(BIE)
研究模仿或理解生物运动的智能机器。例如柔性夹爪怎样适应不同形状。仿生名称不是证据,应比较变形、抓取稳定性和失效条件。
认知系统 · Cognitive Systems(COG)
关注机器怎样感知、推理和作出行动选择。例如传感信息不完整时怎样选择下一步动作。成功率、决策时间和错误代价都重要,不能只展示理想环境下的演示。
控制理论 · Control Theory(CON)
研究机器人在变化环境中如何稳定运动。可比较控制器面对扰动和延迟时的表现。测试应覆盖调参时没有见过的条件,否则很难判断是否具有适应能力。
机器学习 · Machine Learning(MAC)
研究从数据中学习感知或决策的方法。例如模型在新物体和新场景中的表现。应按物体、场景或个体划分测试数据,避免近乎相同的画面落在训练与测试两侧。
机器人运动学 · Robot Kinematics(KIN)
研究机器人的几何关系、位置与运动。可比较不同机构的可达范围和定位误差。理论可达不代表能承受负载,运动学与动力学结论需要区分。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对机器人与智能机器项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:柔性折纸夹爪,怎样证明它更适合抓取
2022 年项目 ROBO002T 研究可整体打印的柔性折纸结构夹爪,并结合视觉与软体运动设计。摘要介绍不同夹爪、机械臂速度、物体质量和形状条件下的抓取测试,以及与硬质夹爪的比较。官方项目摘要:21680
它能够连接仿生相关力学、机器学习和机器人运动学。柔性结构提供顺应性,视觉帮助感知,机构决定怎样运动。三个部分组合起来以后,仍要分别检查作用:改善来自夹爪结构,还是来自更准确的定位?去掉其中一项,系统会怎样?
摘要同时报告抓取相关模型的表现和视觉分类指标。分类准确率不是整个抓取系统的成功率;知道物体是什么,也不保证能够稳妥夹起它。不同数字必须对应到具体任务,否则很容易被一个接近满分的指标掩盖系统失败。
作者还把夹爪思路延伸到柔性腿部结构。要评价迁移是否成功,应分别看耐久、运动能力与任务表现。原摘要提到跌落测试等观察,具体次数和成功比例还需查阅更完整的材料。
学生可借鉴一个直接的方法:把整体系统拆成“看见、决定、行动”几个可测环节,再增加去掉某部分的比较。例如固定感知方式,只比较夹爪结构,便更容易判断机械改进是否真的有用。失败案例应保留:滑落、压坏物体、卡住或定位偏差,可能对应完全不同的改进方向。
2.20 软件设计 Software Design(SFTD)
旧资料常使用 Systems Software 或 SOFT。当前官方类别名称为 Software Design,本书据此更新。软件项目可以涉及算法、计算系统、软件工程及其他符合官方定义的计算问题;具体子类应在报名时核对。类别定义入口
一个软件能运行,并不代表已经形成研究。若开发学习工具,可以研究特定交互或检索方法怎样影响可测量的任务表现;若提出算法,则应比较准确性、速度、内存占用或可证明的性质。
例如,在相同硬件和数据条件下,一种轻量检索方法能否在降低延迟的同时维持结果质量?需要报告数据划分、基线版本、参数选择和重复测试。只挑对自己有利的数据集,会使比较失去意义。
使用大模型时,调用现成接口本身通常不足以说明原创贡献。模型版本、提示变化和运行波动都可能影响结果。若引入真实用户测试,还要单独考虑人体参与者审批。
2022—2026 年官方档案共收录本类 279 个项目,各年依次为 59、47、54、58、61 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
算法 · Algorithms(ALG)
研究完成计算任务的方法及其效率。例如同一问题在数据规模增大时怎样控制时间和内存。比较需使用相同硬件和问题实例,复杂度证明与运行实验各自回答不同问题。
网络安全 · Cybersecurity(CYB)
研究系统如何抵御未经授权的访问或破坏。例如在许可的隔离环境中比较异常检测方法。威胁模型应具体,不能以未获授权的真实系统作为试验对象。
数据库 · Databases(DAT)
研究数据怎样存储、组织、查询与更新。例如不同索引在读写比例变化时的表现。数据分布、缓存和并发负载会改变结果,只测一个小文件难以支持普遍优势。
人机界面 · Human/Machine Interface(HMC)
研究人怎样理解和控制软件系统。例如两种界面怎样影响任务完成与操作错误。功能数量不是可用性,参与者经验、任务顺序与学习效应都要处理。
编程语言与操作系统 · Languages and Operating Systems(LNG)
研究编程语言及操作系统层面的设计。例如某种调度策略面对混合负载时的响应。吞吐量、延迟、公平性和资源占用可能冲突,需要说明目标与取舍。
移动应用 · Mobile Apps(APP)
研究面向移动设备的软件及其限制。例如弱网条件下应用能否可靠完成任务。做出安装包只是实现的一步,研究还需提出可比较的问题和真实使用条件。
在线学习 · Online Learning(LRN)
这里的 Online Learning 指借助电子技术开展教育与学习,不是机器学习中的在线更新算法。例如反馈方式是否影响知识保持。使用时长和满意度不能替代实际学习结果。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对软件设计项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:冷却预测更准确,为何并没有节能
2026 年项目 SFTD047(CoolSmart AI)在 Python 仿真中比较预测式冷却和达到温度阈值后才启动的反应式冷却。作者用随机森林预测近期温度,再以规则控制冷却水平,在相同负载条件下比较两套系统。官方项目摘要:28551
摘要报告,预测式方案降低了最高温度,并将超过 80°C 的时间从 1,193 秒降到 188 秒;与此同时,总冷却用量从 958 增至 1,080 个仿真单位。原题包含“节能”方向,但结果并不支持冷却用量已经减少。结果没有完全符合最初的期待。把增加的冷却用量写出来,让读者看到了研究实际走到哪里。
它可以联系算法设计,也与控制理论和能源系统交叉。研究价值来自同负载下的对照与明确的性能取舍。冷却量增加换来过热时间减少,是否值得,要由应用目标和完整成本来判断,不能只看其中一个指标。
还需要注意,两组数字来自仿真;“单位”没有直接对应到现实中的千瓦时。若要主张真实数据中心节能,就需要校准热模型、比较总功耗并开展适当实测。当前摘要能够支持的是模型条件下的温度与冷却使用变化。
学生可以进一步学习多目标比较:改变控制参数,画出过热时间与冷却用量之间的关系,再选出符合约束的方案。这比只寻找一个比基线好看的指标更诚实,也更接近真实软件工程中的决策。
2.21 技术增强艺术 Technology Enhances the Arts(TECA)
这一类别关注技术如何帮助艺术创作、表达、理解或保存。它要求技术与艺术问题之间有实质联系。作品看起来好看,与技术是否解决了某个问题,是两个需要分别说明的层面。
例如,研究一种交互映射能否帮助演奏者更准确地控制数字乐器的表达。设备延迟和信号稳定性可以通过台架测量;实际使用体验则可能需要获批的用户研究,并认真定义“更准确”或“更容易表达”的含义。
另一个方向是对历史图像修复方法进行比较。可以用已知原图人为构造损坏来评估恢复误差,但不能因此断言真实历史图像被恢复成了原貌。技术生成的细节与历史证据应分开呈现。
做这一方向,值得请熟悉相应艺术实践的人看一看:这项技术究竟帮助了哪一步?对演奏者有用的改进,未必恰好体现在模型分数上。把使用情境说清楚,再选择与之对应的评价方式。
档案中 2024、2025、2026 年分别有 21、20、20 个项目,共 61 个。此前没有该独立类别,不能据此写成研究方向不存在。
子类别怎样区分
显示技术 · Display Technology(DSP)
研究支持艺术表达或体验的显示方法。例如显示方式如何影响细节辨识和观看舒适度。除技术性能外,还要考虑内容和观看情境,不能只比亮度或分辨率。
人际信息交流 · Human Information Exchange(HIE)
研究技术怎样帮助人表达、交流和感受信息。例如触觉编码能否传达某类视觉结构。准确率、学习负担与表达范围需要分别测量,技术成功不等于使用者容易理解。
音乐与图像处理 · Music and Image Manipulation(MIM)
研究音乐或图像的分析、生成与处理。例如修复算法怎样平衡去噪和细节保留。自动评分与人的感受可能不同,应说明主观评价的设计和参与者构成。
游戏 · Games(GAM)
研究游戏相关的技术与体验。例如某种交互机制怎样影响空间任务表现。游戏更受欢迎不必然说明学习更有效,需要把娱乐体验和目标能力分别评价。
三维建模 · 3D Modeling(MOD)
研究支持创作的三维表示、生成与编辑。例如文字生成模型是否能输出可继续修改的几何结构。渲染图好看不等于网格完整、可编辑或可制造。
工程特效 · Engineering Effects(ENG)
研究工程方法支持的舞台、影视或艺术特效。例如低成本装置能否稳定复现某种光影效果。可控性、重复性与创作自由度都值得比较,而不只展示一次成功画面。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对技术增强艺术项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:文字生成三维作品,好看之外还要能修改
2024 年项目 TECA019T(CloudGen)构建了从文字到三维形状的生成与编辑流程。摘要介绍点云编码、文本表示、扩散生成、平滑处理,以及让用户通过反馈修改结果的机制,并提供网页和虚拟现实查看界面。官方项目摘要:25944
这个项目直接连接三维建模,也涉及人际信息交流和图像处理。与一般生成算法研究相比,艺术创作情境带来不同问题:用户能否表达意图,生成后能否修改,设计是否仍受创作者控制。
摘要说进行了定量与定性实验,但没有展开具体人数、指标或完整结果。仅凭这些信息,还不能判断创作效率提高了多少,或者不同艺术家是否容易上手。
阅读时可以追问,形状与提示词相符到什么程度,网格有没有破损,平滑是否抹掉用户想保留的细节,修改一次是否会意外改变其他部位。可打印性也不能仅凭渲染图判断,还涉及封闭性、壁厚和具体制造条件。
对于学生,TECA 的优势在于可以把技术测试与真实创作任务连接起来。一个小而清楚的题目,例如比较两种编辑方式完成同一造型任务的时间、返工次数与控制感,可能比再搭一个通用生成网站更有研究内容。涉及使用者测试时,同样要提前处理适用的人体参与者审批。
2.22 转化医学科学 Translational Medical Science(TMED)
转化医学关注基础研究如何向诊断、治疗或预防应用推进。它与其他生物医学类别有交叉,通常更强调研究结果走向应用时需要跨过的验证步骤。
对中学生来说,一个合适的问题可能是:某项候选标志物在独立队列中能否保持区分能力,或者某种测量方案是否满足进一步验证所需的稳定性。题目必须对应实际能够完成的研究层级。
细胞结果、动物结果、回顾性人群数据和前瞻性临床证据,各自回答的问题不同。把这些层次混在一起,会让一个本来扎实的小研究变成过度承诺。公开数据上有用的指标,距离临床决策仍可能很远。
这一方向尤其需要合格导师帮助理解证据和伦理要求。学生应能讲清自己完成的是哪一步,距离真实应用还欠缺什么,而不是把“有潜力”写成“已经可以使用”。
2022—2026 年官方档案共收录本类 405 个项目,各年依次为 66、80、81、86、92 个。这个数量帮助判断阅读范围,不表示这一学科容易或难以获奖。
子类别怎样区分
疾病检测与诊断 · Disease Detection and Diagnosis(DIS)
把检测或诊断工具与明确的疾病问题相连。例如已有影像上的筛查方法能否识别独立患者。必须说明参考标准、灵敏度和特异度,不能只报总体准确率。
疾病预防 · Disease Prevention(PRE)
研究降低疾病发生或发展风险的方法。例如用公开纵向数据评价早期风险指标。风险标记、改变行为和减少疾病发生是不同结果,不能在没有随访证据时相互替代。
疾病治疗与疗法 · Disease Treatment and Therapies(TRE)
研究治疗方案怎样产生效果。可分析已有研究中疗效与剂量或人群的关系。模型结果与患者获益之间还有距离,不能把预实验写成临床治疗建议。
药物筛选与测试 · Drug Identification and Testing(DRU)
筛选与比较候选药物的活性和适用性。例如分析候选分子在多个测定体系中是否一致。只对一个靶点有效还不够,选择性、毒性和可达浓度会影响后续价值。
临床前研究 · Pre-Clinical Studies(PCS)
在进入临床之前评价机制、效果与安全相关证据。例如比较细胞或模型系统中的多个终点。没有观察到毒性,只能说明在所测条件与时间内未观察到,不能推出普遍安全。
其他 · Other(OTH)
用于本学科内确实不能归入上述子类别的研究。跨越多个子类别时,应先找主要贡献,而不是因为涉及面广就直接选择 Other。对转化医学项目,试着用一句话说明你新增了什么知识或方法,再判断由哪个专业方向的评委来评价最合适。
案例:从显微图像识别虫卵,到实际筛查还有几步
2022 年项目 TMED010T(BiDEx)把显微图像中的肝吸虫卵检测与风险资料分析结合,服务于筛查流程。摘要介绍以 1,800 张显微图像建立初步检测模型,再利用虫卵形态相关处理改进识别,并建立患者风险排序相关模型和网页应用。官方项目摘要:21821
它与疾病检测与诊断相连,也涉及疾病预防的应用背景。这里不能把三个结果混为一谈:图像中找到虫卵、判断一位患者是否感染,以及筛查后减少疾病负担,分别需要不同层级的证据。
作者报告图像识别准确率从初步模型的 95% 提高到后续的 98%,并给出风险资料模型的另一组结果。读者应检查图像怎样划分,来自同一份标本的图像是否跨越训练和测试,以及困难阴性样本是否足够。1,800 张图像不一定代表 1,800 位独立患者。
对于筛查,漏掉真实感染者和让无感染者接受进一步检查的代价不同。因此灵敏度、特异度和实际人群中的预测值,通常比单个准确率更能帮助判断用途。摘要提到减少延误和预防疾病的前景,但这些还需要长期临床结局等证据来验证。
学生可以用这个案例练习从模型指标回到使用流程:谁提供样本,谁复核结果,算法不确定时怎么办?模型离临床使用还有多远,应由这些实际环节来判断。报告中写清已经验证的部分,读者才知道结果可以怎样使用。
2.23 怎样在几个题目之间作选择
如果手里有三个候选题目,先不要急着评分。分别写出最关键的一次验证:要取得什么数据,用什么对照,什么结果能回答问题。然后逐项核实条件。
| 判断角度 | 可以继续推进的迹象 | 值得暂缓的迹象 |
|---|---|---|
| 问题 | 能用一句具体的话说明比较或解释对象 | 只有主题和技术名词 |
| 证据 | 知道最重要的测量是什么 | 只能展示效果,无法检验主张 |
| 资源 | 已确认设备、数据或材料来源 | 关键资源仍靠设想 |
| 时间 | 能给失败和重复验证留下余地 | 第一轮结果出来就到提交日 |
| 学生理解 | 能解释为何采用某种方法 | 只能复述导师或教程的步骤 |
| 审批 | 已明确需要谁审查、何时提交 | 打算先做,之后补手续 |
若几个题目的条件相近,可以问自己:连续两周没有好结果时,我还想研究哪一个?它未必是标题最漂亮的那个,却更可能让你愿意留下来找原因。
第三章 科研项目材料与展示
3.1 从证据倒推材料
准备材料,可以先不打开排版软件。拿一张纸,写出你最想让别人知道的结论,再把支持它的图放在旁边。两者对得上吗?如果还缺一个公平的对照,或者图只能说明较小范围的结果,就先处理这些问题。
如果结论是“新结构更耐用”,就应有明确的耐用性定义、比较对象、测试条件和重复结果。如果结论是“模型可以跨场景使用”,测试数据就应包含真正未见过的场景。材料的任务,是让别人看懂这些联系。
一份项目通常会涉及研究计划、审批表、原始记录、分析文件、摘要、展示材料以及答辩准备。它们的用途不同。研究计划帮助人在实验前判断方案;记录保存实际发生的事情;摘要和展板则把已完成的工作讲清楚。不要用一份事后写成的漂亮报告代替所有过程材料。
3.2 开始实验之前,先认识审批
ISEF 中的 SRC 是 Scientific Review Committee,即科学审查委员会;IRB 是 Institutional Review Board,即人体参与者研究审查委员会。前者负责研究规则与资格等方面的审查,后者承担人体参与者保护方面的审查。某些研究还会涉及所在机构的动物或生物安全审查。
研究对象与操作方式决定审批要求。问卷、访谈、应用试用和生理信号采集,都可能触及人体参与者规则。使用动物、微生物、组织或危险材料,也不能只按项目名称判断风险。应把具体程序交给成人指导者和相应审查机构确认。国际规则入口与 Rules Wizard
| 项目情境 | 实验前需要查清的事情 |
|---|---|
| 向同学发问卷、组织访谈或进行用户测试 | 是否需要 IRB 审批,如何取得适用的同意,怎样保护隐私 |
| 使用公开的人体数据 | 是否真正公开、是否含可识别信息、使用许可和豁免条件是否满足 |
| 使用导师提供的病历或未公开数据 | 数据来源、原研究审批、授权及本项目所需审查 |
| 研究脊椎动物 | 是否允许该类研究,场所、监督与审批是否满足要求 |
| 培养微生物或操作生物材料 | 风险等级、实验室条件、监督、处理和处置要求 |
| 使用化学品、高温、电气或机械装置 | 风险评估、适当监督及相关许可 |
这张表只是帮助识别问题,并不能替代审批。有些研究可能满足豁免条件,但“豁免”也有具体定义。学生最容易犯的错误是先招募参与者、发出问卷,再询问是否需要审核。对需审批的人体研究,招募和数据收集都应安排在适用批准之后。人体参与者规则
若计划发生实质变化,例如增加一个刺激条件、改用另一种材料或扩大参与者范围,应先确认是否需要重新审批。原方案获批,不意味着之后所有变化都自动获批。
3.3 2027 表格应该怎样理解
2027 规则调整了部分表格。旧教程里的 Form 1C 和 Form 2,不能直接当作本赛季表格名称使用。下面的编号依据 2027 规则书;完整要求和签字位置仍应在原表中核对。2027 规则与表格原文
| 表格或材料 | 用途与适用范围 | 时间上的关键点 |
|---|---|---|
| Form 1 | 成人指导者检查与安全评估 | 研究前与指导者共同检查 |
| Form 1A 与研究计划 | 学生信息、时间地点、研究安排 | 计划应在实验前完成;变化要记录 |
| Form 1B | 学生、家长及相关审查的批准记录 | 各签署部分按原表要求办理;不能倒签 |
| Form 2A | 学生支持披露,所有项目均需提交 | 原表明确允许实验前或后完成;支持记录宜从开始就保留 |
| Form 2B | 合格科学家及适用监督信息 | 适用项目在实验前完成 |
| Form 2C | 受监管研究机构或工业场所工作说明 | 适用时由相关人员据实际工作填写;包括规则所述远程指导情形 |
| Form 3 | 风险评估 | 适用时在开展活动前完成 |
| Form 4 | 人体参与者研究 | 适用时先获相应批准,再开展研究 |
| Form 5A / 5B | 脊椎动物研究的不同场所与记录 | 区分场所及原表用途;机构审批须提前落实 |
| Form 6A / 6B | 潜在危险生物因子、人体或脊椎动物组织 | 按材料、操作与适用豁免条件判断 |
| Form 7 | 延续或递进研究 | 清楚比较前期与本年度工作 |
Form 2A 值得特别阅读。它要求说明成人支持、付费支持和生成式 AI 使用情况。导师、研究生、家人或外部专家提供过什么帮助,应按实际情况记录;付费支持可能包括项目、实验空间、指导或材料准备等费用。填写时不要只写“提供建议”,而应说明帮助发生在哪个环节。
比如,“导师教我使用仪器,并协助排查第一次测量中的接线错误;之后的数据由我在监督下采集”,比笼统写“全程独立完成”更准确。学生可以独立作出重要判断,同时接受必要的教学和安全监督。
支持披露表可以事后完成,不代表其他前置审批也能事后补办。各种文件的时间要求不同,整理时应分别检查。
3.4 怎样写出有用的研究计划
研究计划要让一个没有参与讨论的人理解:为什么要做,打算怎样做,如何保证安全,以及得到数据后怎样回答问题。学生应自己写初稿,成人可以指出不清楚的地方,再由学生修改。
先写背景和问题。背景不需要从整个学科的历史讲起,而应说明已有工作到哪里、哪个问题仍不清楚。接着给出研究问题、假设或工程目标。科学项目可以预期某种关系,工程项目则要写清成功标准和限制。
方法部分应具体到足以判断比较是否公平,包括样本来源、变量、对照、测量方式和数据排除标准。涉及复杂技术时,可以引用规范的方法来源,但不能只写“按标准流程操作”而不说明采用哪一套流程。
最后写分析与安全安排。准备比较均值、拟合关系还是评估预测?关键图可能是什么样?出现什么异常时会暂停?这些问题在开始前想一遍,通常比结束后补一个复杂统计方法更有用。
以下是一个教学构想的缩小过程:最初的问题是“做一种更好的散热片”。把它改为“在相同材料质量和热源功率下,改变翅片间距是否影响稳态温升”,就能够继续讨论对照、环境温度、稳定状态的定义和测量重复。此时研究计划开始具有可执行性。
3.5 重复实验、样本量与数据分析
同一条件下重复测量,可以了解仪器波动;独立制备或独立抽样,才能帮助判断结果是否能在新的样本上重现。两种重复都有用,但不能互相替代。
假设从一块材料上测了十个位置,得到十个数值。它们提供了材料内部均匀性的线索,却没有证明十次制备都能得到同样性能。写材料研究时,应分别报告制备次数与每件样品的测量次数。对于植物、动物和群体数据,也要先想清楚实验单位。
本书不规定一个适用于所有项目的“最低样本量”。合理数量取决于预期差异、测量噪声、设计和可接受的不确定性。小样本研究可以作为探索,但应控制结论强度。不能因为收集数据困难,就把很不稳定的估计写成确定结果。
数据分析应同时关注效应大小与不确定性。一个很小的差异可能在大量数据下达到统计显著,但实际价值有限;一个看起来很大的差异,也可能因为样本过少而很不稳定。若使用置信区间、误差条或统计检验,学生必须知道它们表示什么。
算法项目还要处理调参和测试的分工。训练数据用于学习,验证数据用于选择方法或参数,测试数据尽量留到最终评价。反复查看测试结果后再改模型,会削弱测试作为独立检验的意义。小数据场景可以采用合适的交叉验证,但数据分组、特征筛选和预处理都必须放在正确的位置。
一个数字怎样被写得更准确
以下数字只是写作练习。假设方法 A 在同一测试中从 80% 提高到 88%,可以说“提高了 8 个百分点”;若说相对提升,则是相对于 80% 的 10%。两种说法不能混用。
再往前一步,还需要知道测试集有多少样本、错误集中在哪些情况,以及比较是否使用同样条件。只有一个百分比,读者无法判断结果是否可靠。
3.6 研究日志记录什么
想象三周后你要重做今天的实验。到那时,你还记得用了哪个数据文件、为什么调过一次参数吗?日志应留下这些信息,以及日期、操作、异常和下一步打算。“今天完成实验,效果不错”很难帮你把实验再做一遍。
如果失败了,记录你观察到什么,以及为什么决定改变方法。不要把后来理解的原因写成当时就已经知道。研究记录可以补充解释,但应让人分得清当时记录与事后备注。
代码和数据也需要保留版本。至少能够回答:这张图由哪个数据文件、哪一版脚本生成,单位如何换算,哪些记录被排除,为什么。涉及个人信息时,公开展示使用去标识化内容,并按获批计划管理原始数据。
团队可以各自记录工作,再定期合并讨论。每个成员都应理解整体问题和主要证据,但不必假装所有人都做了每一步。分工清楚,反而方便解释贡献。
3.7 摘要与研究报告
ISEF 的英文摘要最多 250 词、一页,描述本年度由学生完成的研究。完整研究论文和数据本在国际总则中属于强烈建议材料,并非对所有项目统一强制;附属赛事可以另行要求。摘要与文件要求
摘要的空间很少,应优先保留问题、关键方法、主要结果与有限度的结论。背景只需解释为什么读者要关心这个问题。若大量篇幅用于介绍疾病或全球问题,却没有交代自己的结果,摘要就失去了作用。
写结果时,应给出足以理解比较的数字或明确发现。不要只写“效果显著”“性能优异”。如果研究没有支持最初的假设,也可以据实说明结果,以及它排除了哪一种解释。
研究报告则可以完整展开方法、结果与讨论。阅读起来较顺畅的报告,通常先界定问题,再说明方法,随后逐个回答研究问题。讨论部分既解释结果,也承认样本、测量和推断上的限制。参考文献应来自学生确实查阅过的材料。
参考资料的多少没有统一的理想数字。几十篇没有读过的引用,不能替代几篇真正理解的关键文献。遇到二手资料转述时,应尽量找到原研究,确认原作者做过什么、没有做过什么。
3.8 展板:让读者看见研究的主线
展板需要支持现场交流。读者先看到问题和主要发现,再决定看哪一张图、问哪个问题。因此,最重要的结果应占据最容易看到的位置,背景文字则可以收紧。
一个常见布局是:左侧介绍问题与必要背景,中间展示方法和关键结果,右侧解释结论与限制。它只是设计建议,不是官方规定。若研究逻辑更适合别的顺序,可以调整。
图表应写明横纵轴、单位、样本数,以及误差条的含义。图注尽量回答“这张图支持什么判断”。如果需要口头解释五分钟才能理解图中每一种颜色,图本身还可以简化。
2027 规则给出的项目最大空间为深 76 厘米、宽 122 厘米、从地面到顶部高 240 厘米,支架、桌子及展示材料都应考虑在内。这是整个项目空间限制,并不是要求所有学生制作同一尺寸的海报。经批准的官方摘要及适用文件如何展示,也有专门要求。Display & Safety 规则
2027 展示规则要求逐项标注图像、图表的来源;自己制作的图也要交代所用软件和年份。非本人照片涉及的授权应按规则准备。项目或学生的二维码、网站、邮箱等联系方式受到展示限制,不能像商业海报一样随意添加;引用来源的 URL 则有相应用途,不应与个人推广链接混淆。
文件也要分清去处。官方批准的摘要和适用的 Form 2C、Form 7 按要求竖直展示;其他适用审查文件供核查。已填写的人体研究知情同意或同意参与表,不得带入展厅或放在展位上。做展示清单时,把“必须展示”“留存备查”“不得带入”分别列开。
实物陈列另受安全规则约束。请先核对规则中的禁带清单,再决定哪些装置或材料带去现场;不能陈列的部分,可在规则允许的范围内用合规照片或视频说明。2027 展示规则,规则书第 24—28 页
最好先把展板缩小打印,检查逻辑与文字,再按接近实际观看距离检查字号。请一位不了解项目的老师看一分钟,让他复述研究问题和主要发现。如果复述偏离很大,就调整展板,而不是只解释“现场我会讲清楚”。
3.9 虚拟展示材料与注册
2026 年官方参赛者页面要求决赛学生在实体展示之外完成虚拟展位,并通过 Finalist Questionnaire 完成注册。2027 年的上传格式、页数、视频长度和截止日期,应以该赛季发布的材料指南及个人参赛通知为准。本书不把上一年的细节写成下一年的固定要求。官方参赛者信息页
现在可以准备的是内容本身:清晰的项目介绍、可读的关键图表、方法示意和真实的贡献说明。等当季要求公布后,再组织成指定格式。数字材料与现场展板中的标题、数据和结论应一致,修改时要一起更新。
录制介绍时,先让听众理解问题,再展示证据。镜头和动画不应比研究本身更复杂。演示装置时,可以说明一次测试的条件,不要把剪辑后的成功片段当作连续可靠运行的证明。
注册信息需要与学校、附属赛事和旅行证件保持一致。团队成员应提前确认姓名拼写及参与安排。已经获选,不等于注册、科学审查和展示审查都已经完成;每一项通知都需要认真处理。
Quad Chart:按哪一年的要求准备
2026 官方指南要求一页横向视觉摘要,以图像上传。采用四区形式时四块等大;也可采用不超过五块的其他清晰布局。正文字号最低 18 pt,图注或图片署名最低 12 pt;浅底深字。标题、身份信息与项目编号按指南安排。它是公开材料;图形要注明来源,不列参考文献表或致谢,也不使用“abstract”作名称。2026 官方材料指南,第 6—7、15—16 页
这些是 2026 年要求,不能直接当成 2027 年已确认的提交规范。早年流传的字号与尺寸说明也不宜继续照抄。准备当季提交文件时,应从参赛者入口核对最新指南;本书的中文案例图用于教学。
先选出最能回答研究问题的一张图,再补上理解它所必需的方法。整页缩小后,如果读者只看得到四段密密麻麻的文字,就还需要删减背景、放大证据。第五章新增八个真实案例的读图练习,分别讨论仿真取舍、人体研究、材料、生态、诊断、数学与艺术技术项目。
3.10 答辩怎样练习
答辩训练可以从三种长度开始:用半分钟说明问题,用两三分钟讲完整研究,再准备围绕图表深入讨论。时间只是练习安排,实际面谈以赛事要求为准。
开场不必把所有细节讲完。可以先说明研究对象、为什么需要比较,以及最主要的发现。随后根据评委的问题展开。若评委在方法部分打断,通常意味着他希望先理解证据是否成立,学生可以顺着这个问题回答。
| 常见追问 | 准备时应找到的依据 |
|---|---|
| 为什么研究这个问题? | 具体观察或文献中的未解问题 |
| 与已有工作相比新增了什么? | 对照文献及本项目的清楚边界 |
| 为什么选择这个方法? | 备选方法、资源限制及取舍理由 |
| 如何知道结果不是偶然或偏差? | 重复、对照、数据划分及误差分析 |
| 哪一部分是你完成的? | 日志、代码记录和真实分工 |
| 什么情况会使方法失效? | 已做的边界测试或尚未验证的条件 |
| 如果再有一个月,会做什么? | 最能减少当前不确定性的下一次验证 |
回答时先回应问题,再给必要细节。听不清可以请评委重复;不知道可以说明自己目前的理解和还需查证的部分。把一个问题硬转回背熟的讲稿,往往会让对话更困难。
练习者也不必扮演故意刁难的评委。请老师连续追问一次实验为什么这样设计,比快速问二十道套话更有用。团队答辩可以轮流解释同一张关键图,再讨论彼此理解的差异。
3.11 AI 工具可以帮到哪里
2027 总则要求学生独立完成研究,并对 AI 资源给予恰当引用与说明;生成式 AI 不得用于撰写研究计划、摘要、展板或生成引用。官网链接的 AI 使用表进一步区分了初稿代写、语法修改、代码生成和统计工具建议等情境。AI 使用指导表
| 使用情境 | 官方指导的要点 |
|---|---|
| 学生写完初稿后,仅修改语法和句法 | 指导表允许这一有限用途;不要借润色加入新论点 |
| 让 AI 起草计划、摘要、论文或展板 | 不允许;初稿应由学生独立完成 |
| 让 AI 生成初始代码 | 允许的条件包括明确标注相关部分,并保留提示记录 |
| 用 AI 寻找统计检验或工具的思路 | 可作为辅助并保留记录;数据解释由学生完成 |
| 让 AI 写结论、未来工作或补充论文观点 | 不允许 |
| 让 AI 生成参考文献名单 | 不允许;已确认文献的格式整理另有允许条件 |
2027 的 Form 2A 还要求披露生成式 AI 的使用环节,并提供提示与回复记录;无法取得记录时,表格要求提供相应摘要。指导表中某些有限用途“不要求显式引用”,不等于可以忽略本赛季表格的披露问题。2027 Form 2A,规则书第 34 页
对学生来说,最实用的习惯是保存使用记录,并对每一项输出负责。AI 给出一段代码,要能解释和检验;它解释一个概念,要回到教材或原文确认。不要上传未经许可的个人信息、未公开数据或他人的保密材料。
本白皮书是面向公众的参赛教育读物。书中的解释和例子可以帮助理解研究,但学生的参赛计划、摘要和论文,应由学生按照规则独立撰写。语言听起来像人写的,也不能替代真实的独立工作。
3.12 提交前的一次完整检查
最后一次检查,最好由学生从头讲述项目,让指导者一边听一边对照材料。研究问题与题目是否一致,图表能否找到原始记录,摘要中的数字是否仍是最终版本,支持与分工是否如实披露,审批时间是否与研究过程相符。
再检查一些容易遗漏的细节:单位换算、样本数量、图片来源、英文术语、文件是否能在另一台电脑上打开。若有延续研究,明确标出本年度工作;若某项结果尚未完成验证,就降低结论强度。
检查结束后,再请学生挑一张最重要的图,从原始记录讲到结论。哪里还说不清楚,就回到那里继续整理。
第四章 各区域晋级机制
4.1 ISEF 没有面向个人的总决赛直接报名
ISEF 总决赛的参赛资格来自附属赛事选拔。各地附属赛事由当地机构组织,在 Society for Science 的网络中获得相应名额。它们可能处于地方、地区、州或国家层级,并不都采用“校赛—市赛—省赛—全国赛”的同一条路线。ISEF 官方常见问题
因此,讨论“今年能不能参加 ISEF”,至少包含两个问题:学生是否符合国际总则,学生是否符合某一具体附属赛事的资格。后者需要根据就读地点、学校或居住条件、年级、推荐方式和团队组成逐项确认。
一个在本地比赛获奖的项目,也未必自动获得 ISEF 名额。要看该赛事是否具有当赛季附属资格,以及相应奖项或选拔程序是否通向 ISEF。宣传中的“国际交流机会”与正式总决赛参赛资格不能混为一谈。
4.2 怎样找到可靠的入口
首先使用 Society for Science 的 Find a Fair 查询所在国家或地区,并从目录进入赛事主办方页面。然后阅读当年通知,确认报名对象、时间、审批联系渠道和晋级方式。Find a Fair 官方查询
截至本书核查时,查询首页仍显示 2025—2026 年度。它可以帮助查找已有联系线索,但不能单凭旧页面断言某场比赛已完成 2026—2027 年度认证。新赛季名单会随着年度认证更新;找不到赛事时,也不能立刻判断所在地区没有路径。
建议把确认结果保存成一页参赛记录,至少包括下列内容:
- 赛事全名、当年通知和主办方联系方式。
- 自己符合资格的依据,包括学校、年级及地区条件。
- 报名、研究计划审查、材料上传和现场评审的截止时间。
- 该赛事怎样选出 ISEF 代表,名额是否按项目计算。
- 团队、指导、费用和差旅方面有哪些额外要求。
遇到模糊之处,应询问主办方具体情境。比如“我在某地就读、持某种身份,是否符合本年度报名条件”,比泛泛问“国际学校学生能不能参加”更容易得到有用答复。重要答复尽量保留文字记录。
4.3 中国内地:按地区和当年通知核实
对中国内地读者,不能把多年前的一条选拔链条当成全国所有学生都适用的固定路线,也不能把网络上出现的每一项“直通 ISEF”宣传都视作官方通道。本书用能够核实的主办方文件说明如何读通知,不给出未经确认的 2027 全国通道总表。
重庆市青少年科技教育工作者协会发布的 2026 通知,是一个具体例子。该通知列出可申报的项目来源、资格审查及现场布展问辩等安排,同时要求中英文摘要、论文和研究记录等材料。它说明地方选拔可以提出比 ISEF 国际总则更具体的要求。通知里的 2026 日期和资格,仅适用于那一届,不能直接用于 2027 报名。重庆 2026 交流项目遴选通知
上海科技教育资源页面公布的 2026 申报材料说明,也展示了当地项目选拔对材料的具体安排。准备下一届时,应继续查找主办方新通知,而不是只替换旧模板上的年份。上海 2026 申报材料说明
这两份文件还有一个共同启示:在国际总则中属于“建议”的论文,可能在当地选拔中变成“必须”。学生应同时阅读两个层级的规则。也不要把一地关于原创性、重复参赛或材料格式的要求,推广成所有地区的统一规定。
跨省就读、学籍与居住地不同、团队成员来自不同地区的学生,尤其应提前确认资格。实验室所在城市并不自动决定报名地区,导师认识哪一位老师也不能代替主办方确认。
4.4 港澳台地区及海外就读学生
这些地区各自有当地学校和科学展体系。查询时应以学生实际符合条件的赛事为起点,核对学校、居住、年龄和推荐要求。中文名称相似的科学展,未必具有相同的 ISEF 选拔功能。
台湾国际科学展览会的官方记录说明,2026 ISEF 代表项目来自当年 TISF 选拔;科教馆网站也已列出 2027 TISF 报名注意事项与日程入口。读者应直接进入当届文件确认条件,不沿用 2026 的人数或时间。2026 代表队说明、2027 报名资料入口
在新加坡,Science Centre Singapore 的 SSEF 页面明确说明该赛事与 ISEF 附属关系,以及选拔优秀获奖者代表新加坡参赛的安排。该页面同时限定报名对象为 MOE 学校的中学与大学预科学生。因此,“在新加坡学习”本身不足以推断一定符合报名资格。SSEF 官方介绍
在美国就读的学生,通常从学校及所在地区对应的科学展了解路径。部分地方赛事可以直接输送项目,另一些则衔接州级赛事。应按真实覆盖区域查询,不能把全美想象成统一报名的一场预选赛。美国及其他地区的附属赛事查询
如果所在地区的新赛季通道还不清楚,学生仍可进行文献学习、方法训练和方案讨论,但不要为了赶进度绕过前置审批。把路径核实与研究准备同时推进,通常能减少后期返工。
4.5 可以同时报几个附属赛事吗
2027 总则对参加多个 ISEF 附属赛事设有限制,允许的例外包括从附属地区赛继续晋级到附属州级或国家级赛事。这不能理解成可以自由选择多地比赛反复争取名额。跨地区团队的资格也由相应附属赛事判断。团队与多赛参赛规则
是否还能参加其他类型的研究活动,则要同时查看各活动对重复提交、既往成果和研究时间的要求。相同主题未必是相同项目,但换个标题也不会使同一份成果自动成为新研究。
团队的组建应在研究早期认真讨论。国际规则对成员变更及个人、团队项目转换有约束,尤其在项目参加过任何层级科学展后。不要把“以后再找一个同学加入答辩”作为计划的一部分。
4.6 从获选到总决赛,还会发生什么
获得附属赛事推荐后,通常还要完成注册和材料提交,接受科学审查,准备实体与数字展示,并处理旅行安排。到达现场后,展示还需要通过 Display & Safety 检查。附属赛事的认可与总决赛的材料审查,是相互衔接而不同的步骤。官方参赛者信息
把所有截止日期放到同一张日历上,再明确由谁处理。研究与展示主要由学生推进,证件、住宿和学校请假则需要家庭与带队方尽早协调。最后一周若还要一边改图表、一边追着补旅行文件,会很疲惫。
国际总则还限制附属赛事之后对项目的改动。能够继续收集何种数据、是否需要重新审查,应根据获批研究计划与当年规则确认。不要在获选后临时增加完全不同的实验,只为了让总决赛材料显得更丰富。
4.7 给 2027 赛季读者的时间安排
下面是一种以当地选拔提交日为终点的安排建议,不是官方日历。不同项目的培养、观测或审批周期差异很大,应尽早调整。
| 距当地提交日 | 主要工作 | 本阶段应能回答的问题 |
|---|---|---|
| 约 6—9 个月 | 明确资格,阅读,收缩题目,确认资源 | 为什么是这个问题,最难取得的条件是什么? |
| 约 4—6 个月 | 完成计划和所需审批,再开展适用的试验 | 方法能否测到关心的变化,是否需要修改方案? |
| 约 2—4 个月 | 按计划开展研究,记录异常,做必要验证 | 结果是否稳定,还有什么解释没有排除? |
| 最后 4—8 周 | 分析、写作、图表和材料一致性检查 | 每一句主要结论是否有相应证据? |
| 最后 2—4 周 | 展示、答辩、文件与提交检查 | 学生能否自然解释研究及其限制? |
若距离提交只剩两个月,首先判断现有项目是否已经有可用证据。此时再开一个需要长周期审批或实验的大题目,往往会把时间全部消耗在启动阶段。适当缩小研究范围,比仓促许诺完整成果更实际。
排完时间表,不妨再问一次:如果关键仪器晚两周才能用,项目还能完成吗?若答案是否定的,就提前准备缩小范围的方案。等待发生后再想办法,选择通常会少很多。
第五章 真实案例与四象限读图
5.1 获奖作品应该怎样读
读获奖报道时,最吸引人的往往是奖金额、年龄和一个很大的应用前景。学生真正能学到的内容,则藏在更具体的问题里:作者发现了什么限制,怎样构造比较,哪些结果足以支持主张,还有哪些事情尚未验证。
本章前半部分选取最近五届比赛中的七个案例,覆盖工程、天文、材料、计算、环境及数学相关研究。项目事实来自主办方报道或年度回顾;随后的方法讨论是本书的解读,不是获奖者的自述,也不是评委提供的打分意见。报道没有给出的样本量、完整实验条件和论文细节,本书不补造。
这组案例不是获奖作品全集,也不能代表各类别获奖概率。读者可以用官方项目数据库继续查找同方向项目,再把本章的问题带入阅读。ISEF 项目数据库、近届项目展示入口
5.2 2022:Robert Sansone 与同步磁阻电机
Robert Sansone 获得 2022 年 George D. Yancopoulos Innovator Award。他的研究改善了同步磁阻电机的转矩与效率,研究背景与不依赖稀土永磁体的电机方案有关。主办方把进一步用于电动汽车的可能性描述为未来方向,而非已经完成的车辆应用。2022 官方年度回顾
“改进电动汽车”很难直接变成一项中学生实验。缩小到某类电机的转矩与效率之后,比较对象和测量目标才逐渐清楚。读这项研究,值得留意这种从大背景走向具体部件的过程。
阅读时可以追问:转矩在什么条件下比较?效率怎样测量?新旧方案的材料、尺寸和输入是否一致?当转速或负载改变时,优势是否仍存在?这些问题不是说原项目一定存在缺陷,而是在帮助读者找出评价电机改进所需的证据。
如果想从这个案例获得自己的题目,没必要复刻高水平电机研究。可以在安全、可监督的小系统中研究一个实际限制,例如测量方法的误差或散热条件对表现的影响。关键是把比较做清楚。
这个案例也提醒学生区分原型与应用。一个部件有所改善,不意味着整套产品已经更经济、更可靠。写作时把“本项目测得的改进”和“未来可能支持的用途”分开,读者才知道证据走到了哪里。
5.3 2023:Kaitlyn Wang 与近轨道系外行星识别
Kaitlyn Wang 获得 2023 年最高奖。主办方年度回顾介绍,她开发了更有效识别某些紧邻恒星运行的系外行星的方法,并发现了其中一些很小的行星。2023 官方年度回顾
这个案例与许多“用机器学习分类”的学生项目有一个值得比较的地方:研究首先由一个天文学问题组织起来,计算方法服务于特定信号的发现。若学生只关注模型名称,就容易忽略观测数据的结构和误报来源。
我们阅读这类工作时,会希望知道方法对不同周期、信号强度与噪声的敏感度,以及发现候选后怎样排除其他解释。把已知信号加入测试数据,检查是否能够找回,是理解检测方法的一种常见教学思路;本书并不据报道断言原作者采用了某一套具体测试。
对于学生,公开天文数据的吸引力在于可以接触真实科学问题。困难则在于真实数据往往不整齐:观测间隔不一致,存在缺失,仪器或处理过程会留下痕迹。数据清洗因此是研究的一部分,不能只把它当作调用现成算法之前的杂事。
从案例中可以提炼一个阅读问题:为什么这个对象过去不容易被发现,而新方法改变了什么?能够回答它,比复述“使用先进算法提高效率”更接近研究本身。
5.4 2023:泰国团队与草蛉孵育装置
Teepakorn Keawumdee、Pannathorn Siri 和 Poon Trakultangmun 获得 2023 年 Regeneron Young Scientist Award。官方介绍,其孵育装置改善了草蛉的存活;草蛉可以捕食粉蚧等害虫。2023 年获奖项目回顾
这项工作提供了另一种工程选题思路:从一个生物过程中的实际障碍出发,设计装置解决它。题目不需要先从某种昂贵技术开始,而可以从使用过程中的损失、效率或可重复性开始。
学生阅读时应关注“改善”怎样衡量。存活比例的观察时间是否一致?起始个体状态是否可比?不同批次环境是否相同?装置改善了某一阶段,是否又带来清洁、维护或规模化方面的问题?这些都是从案例引出的研究问题,而非本书掌握的原项目实验细节。
如果在自己的环境中寻找类似问题,可以先与实际使用者讨论,了解哪一步最耗时或最容易失败。即使最终只能验证其中一个环节,也可能形成完整的工程研究。
若要把想法用到自己的研究中,应先与指导者确认物种和场所条件,尤其不能自行引入或释放生物。原项目成立的研究条件,不会随着题目一起复制过来。
5.5 2024:Grace Sun 与有机电化学晶体管
Grace Sun 获得 2024 年最高奖。官方报道介绍,她通过对有机组分进行化学处理,改善了有机电化学晶体管的实验室表现。报道提到未来生物电子用途,但没有把这项研究等同于已经获准使用的医疗器械。2024 顶级奖项报道
从研究结构看,这类项目需要把处理方法、器件性能与潜在机理联系起来。一个指标提升很有吸引力,但评价材料或器件时,还应关心稳定性、重复性,以及改善一项指标是否损害另一项指标。
学生可以借这个案例学习如何阅读多层证据。先看性能发生了什么变化,再看作者用什么信息解释变化,最后看应用前景建立在哪些尚待验证的条件上。三层之间有关联,但不应该合并成一句“可用于治疗疾病”。
这类高水平项目往往依赖专业设备与指导。对条件不同的学生,最值得学的是问题的精度,而不是材料名称。你也许无法制作同类器件,却可以在可获得的材料体系中研究处理条件、性能变化和可靠性之间的关系。
项目的复杂程度应与学生能够理解和验证的内容匹配。能解释一条可靠的性能曲线,通常比展示多张不理解的表征图更有教育价值。
5.6 2024:Michelle Wei 与二阶锥规划算法
Michelle Wei 获得 2024 年 Regeneron Young Scientist Award。主办方介绍,她针对二阶锥规划提出新的求解思路,结合近似解与锥的进一步划分,改善计算表现。2024 官方获奖报道
这项研究把注意力放在优化问题的结构上。对计算方向学生来说,它提供了一条值得尝试的路线:先理解问题有什么特殊性质,再问这些性质能否减少不必要的计算。
读算法论文时,可以把实验部分看作一组公平比较的问题。各方法是否使用同样的精度标准?时间是否包含预处理?哪些实例更有利,哪些会失败?若速度优势只在牺牲解的精度时出现,就不能只展示运行时间。
数学性质与实验表现也应分别阅读。证明可能说明某种条件下的方法性质,实验则展示有限实例上的表现。一个学生项目不必两方面都做到同样深,但要明确自己的结论属于哪一类。
选题练习可以从一个受限问题族开始:先复现简单方法,再说明某种结构如何允许改进,最后加入会使改进失效的反例。这个过程能帮助学生判断自己提出的是普遍方法,还是只适用于特定情况的技巧。
5.7 2025:Adam Kovalčík 与抗病毒药物合成路线
Adam Kovalčík 获得 2025 年最高奖。他研究的是在研抗病毒药物 galidesivir 的合成路线。官方报道说,研究减少了合成步骤,并提高生产效率;这项贡献不等同于证明该药物已获批或已经具备确定的临床疗效。2025 官方获奖报道
这个案例让“创新”有了更具体的含义。目标分子已有研究,并不意味着合成问题已经结束。原料、步骤、条件和产率,都可能成为值得改进的对象。
不过,“步骤更少”本身不是完整结论。路线比较还可能涉及纯化难度、原料可得性、危险性、总产率和放大条件。学生阅读时应寻找比较的完整范围,不要只摘一个最漂亮的数字。
对没有专业有机实验条件的学生,这个案例不应成为照着开展高难度反应的理由。它更适合说明一种研究视角:在已经存在的过程里,找到一个具体的、能够证明改善的环节。这样的视角也可以用于数据处理、材料制备和工程流程。
报道中对药物应用的期待,与学生完成的化学研究处于不同层级。写案例分析时,保留这种区分,也是在练习如何准确讨论自己的研究。
5.8 2026:Hikaru Kuribayashi 与复杂折叠模拟
Hikaru Kuribayashi 获得 2026 年最高奖。他开发了用于研究复杂折叠的模拟程序,采用马尔可夫链蒙特卡洛方法探索可能的折叠情形,并在瓢虫翅膀折叠等已知情形上进行了验证。官方列出的可展开结构用途属于潜在应用。2026 官方获奖报道
折纸看起来很直观,真正转为研究时却需要精确描述:哪些部分能够转动,哪些状态符合约束,不同路径之间怎样切换,计算如何避免只找到一个局部可能。一个日常现象由此变成了数学与计算问题。
学生可以从中学习验证模拟的方法。已知解或已知结构提供了检查程序的机会;若连可验证的小例子都不能重现,就很难信任复杂情形中的新结果。之后才适合研究更大范围的表现和限制。
这里还需要理解采样方法的边界。通过采样探索许多可能,不等于对所有情况给出了穷尽证明。评价类似算法时,应查看收敛、不同初始化和难例表现。报道没有提供完整技术细节,本书也不据此替原项目作更强的数学主张。
对有计算兴趣的学生,一个可行的练习是先研究小规模、可以人工检查的结构,比较不同搜索方法怎样受到约束影响。把一个小问题讲透,有助于判断何时值得扩大规模。
5.9 从七个案例中,可以学到什么
这些项目横跨多个学科,研究条件也不相同。共同值得学习的,是作者都围绕一个能够辨认的问题组织工作:改善具体性能、发现特定信号、消除某个过程的瓶颈,或提出新的计算方法。
不能由此推导“有某种关键词就容易获奖”。获奖报道已经经过筛选,通常更强调成功结果和应用价值。没有获奖的项目中也可能有认真完成的研究,而这些信息并未在本章构成对照样本。
读案例时,可以做一张自己的分析页。左边只记原文明确提供的事实;右边写你据此产生的问题。比如左边是“报告改善了效率”,右边是“效率的分母包含什么,测量条件是什么”。把事实与追问分开,能够防止读着读着把猜测当成原项目内容。
5.10 怎样继续读原始摘要、论文与展示
先确认年份、作者和项目题目,再从官方数据库或官方链接进入材料。媒体报道适合理解背景,摘要适合抓住主要主张,方法和补充材料才更适合分析研究细节。并非每个项目都有公开完整论文,找不到时应承认资料有限。
第一遍阅读,不急着理解所有术语。先找研究问题、比较对象与主要结论。第二遍集中阅读关键图和方法:样本从哪里来,数据怎样收集,图表怎样支持结论。最后再读局限和未来工作,判断作者自己认为尚未解决的是什么。
遇到不理解的方法,可以先找基础教材或原方法论文。若直接模仿获奖作品的高级术语,很容易跳过自己尚未掌握的步骤。能够独立解释一个基础对照,往往是进入复杂研究的必要准备。
5.11 关于评委反馈与成功经验
本书没有取得这些获奖者的完整评分表或逐字评委反馈,因此不把推测写成“评委喜欢什么”。公开且可核实的依据,是官方评审标准对研究质量、创造性、学生理解和面谈的要求。官方评审标准
把这些要求用于自己的项目,可以问:我是否能解释一次关键修改?我是否知道最重要的误差来源?如果别人提出另一种解释,我能指出哪项数据支持或反对它?这些问题比背诵“我的创新点有三条”更接近研究讨论。
读完后,在笔记里留下一句下次能用上的话。例如:“比较电机时,要查清负载和输入条件是否一致。”等到自己设计实验时,再回来看看这句话。
5.12 用官方 Quad Chart 结构重新读一遍案例
一篇摘要读完,常常只记住一个技术名词和一个很好看的结果。把它放进四区摘要,信息之间的缺口就容易看出来:问题问的是节能,结果却只画温度;方法研究的是细胞,结论却已经走到患者治疗。问题里承诺要回答的事,应当能在结果中找到依据。
这里采用 2026 官方指南中的 Quad Chart 结构:左上是问题,左下是方法,右上是结果,右下是解释与结论。它与“创新程度×验证程度”那种有横纵轴的分析矩阵不同。官方图是组织研究内容的一种方式,不是给项目分档或计算获奖概率的工具。官方材料指南,第 6—7、15 页
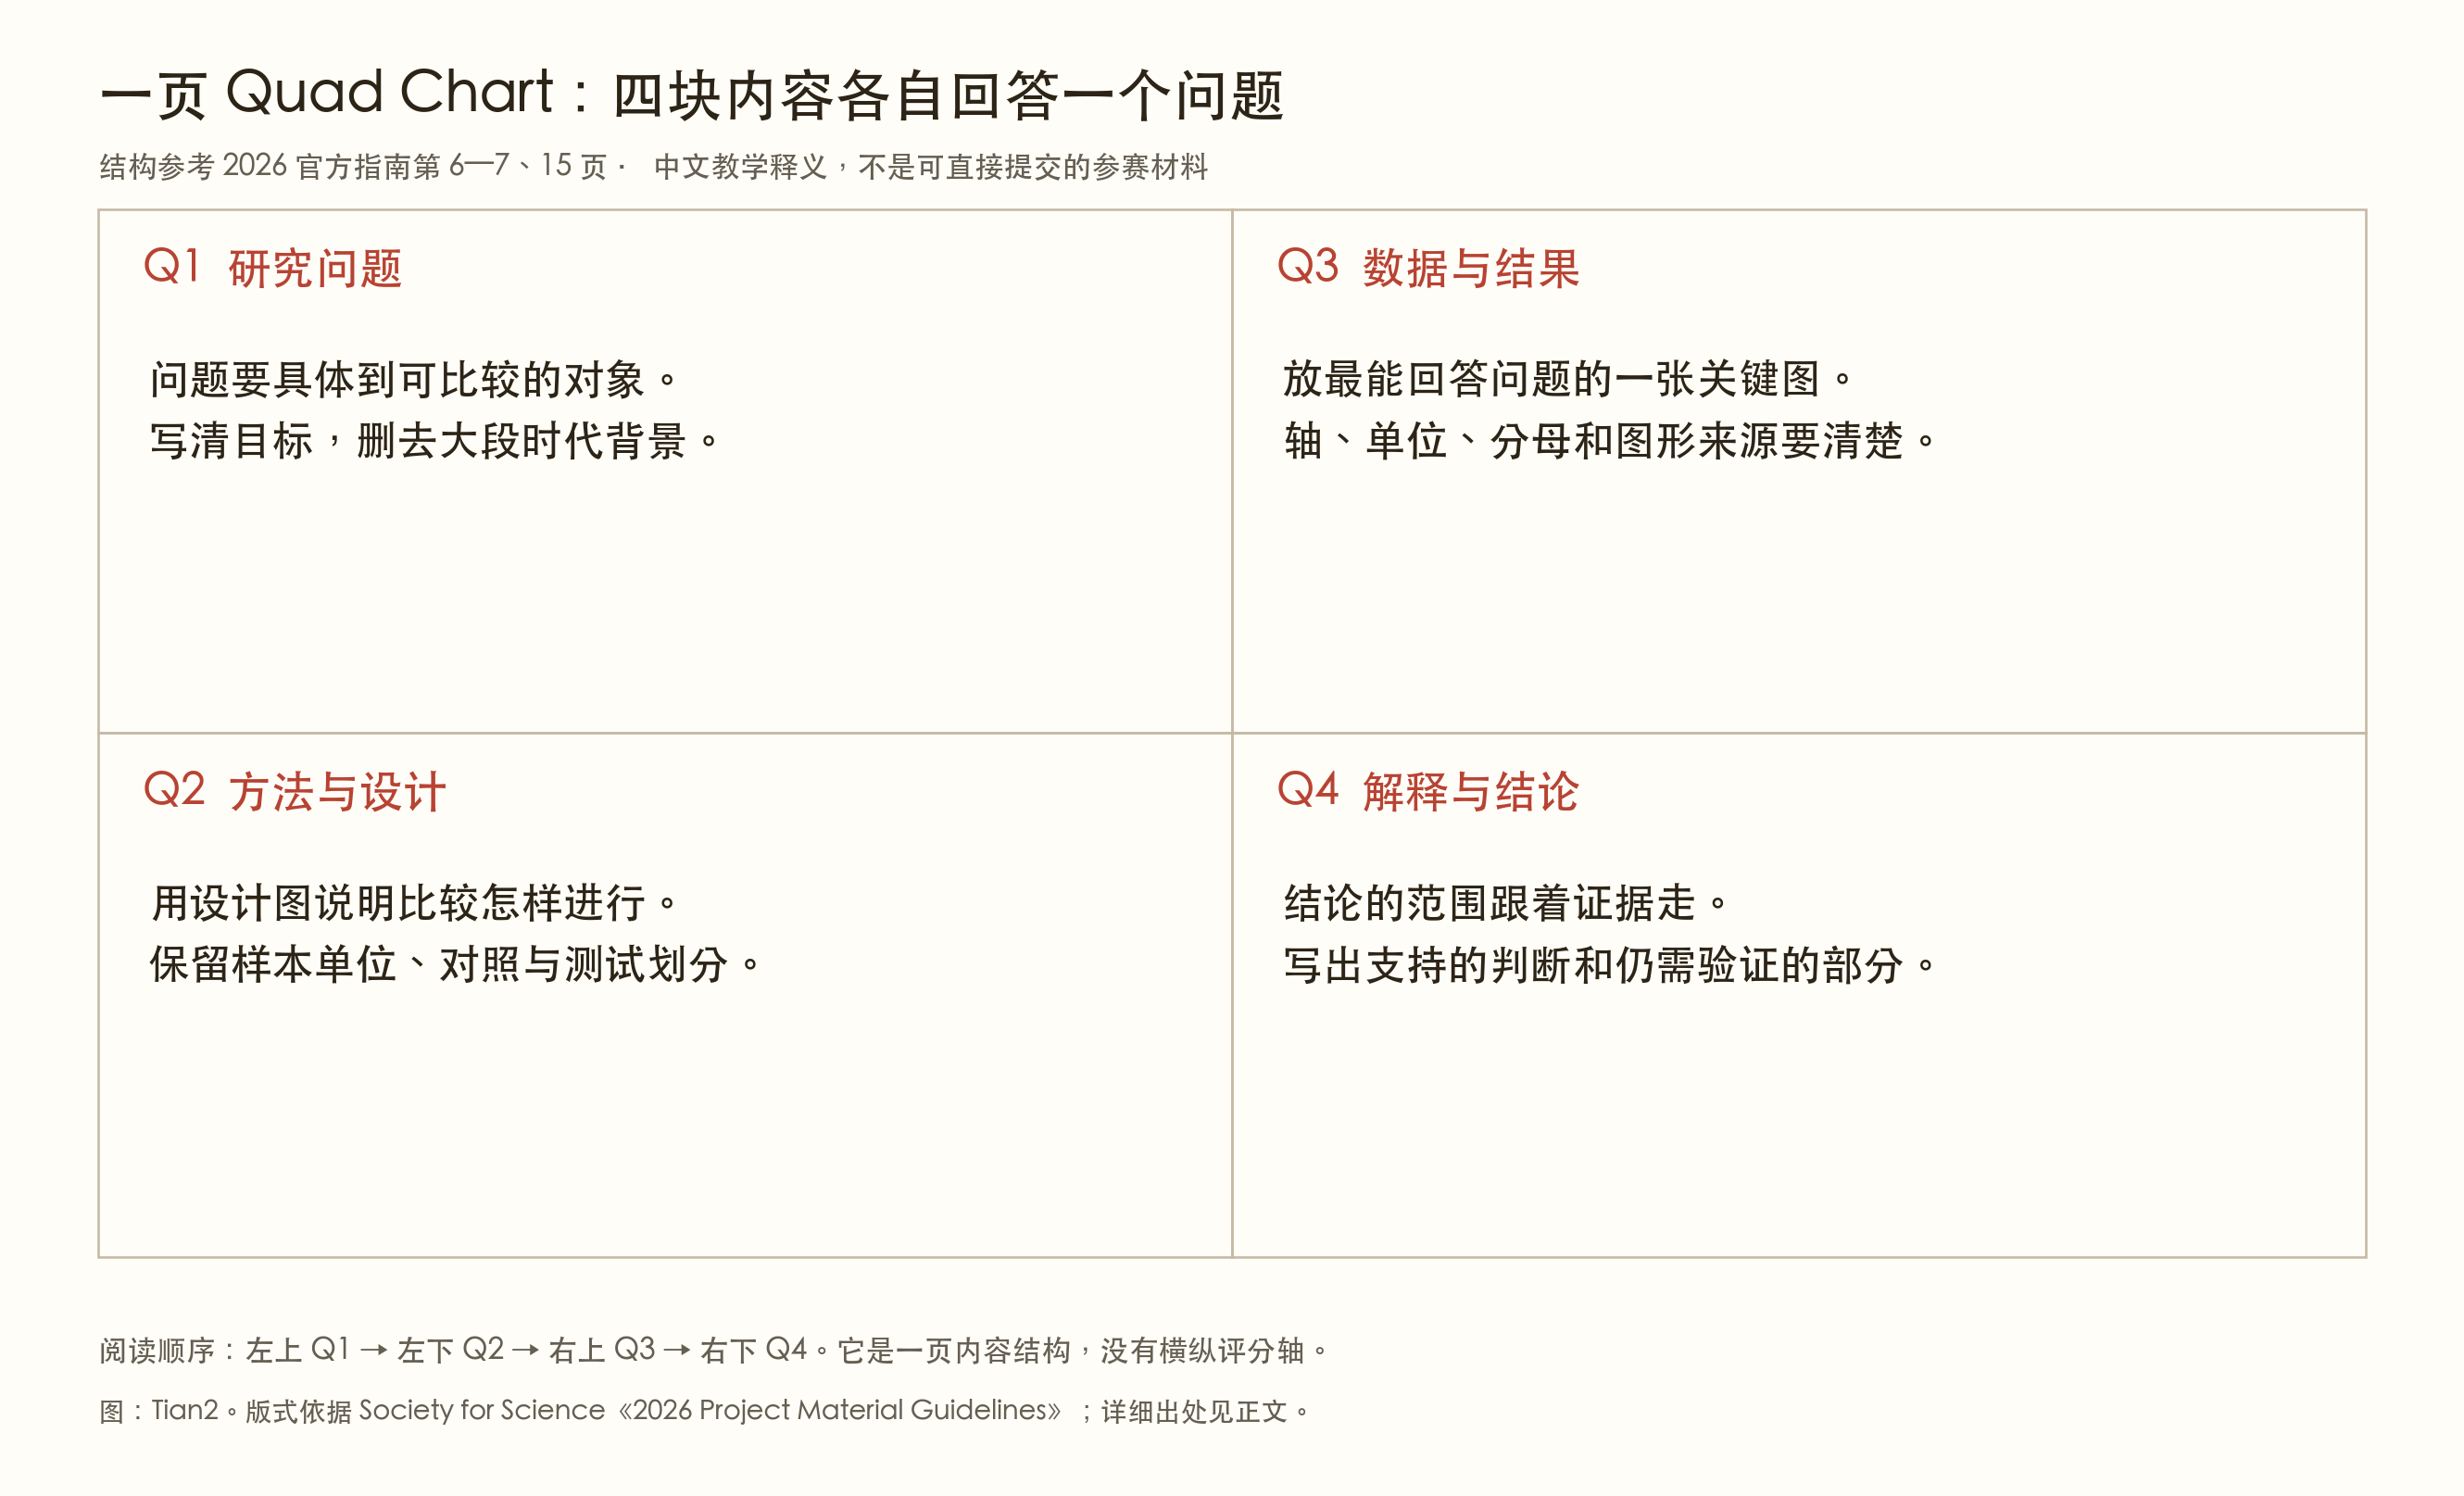
图 5-1|结构依据官方指南,由 Tian2 以中文重新绘制。图内的写作提示是本书建议。可单独打开 高清图 或 可编辑 SVG。
接下来的八张案例图,全部根据第二章已经介绍的官方项目摘要重新整理。它们不是获奖学生提交的原版图片,也不声称恢复了作者没有公开的实验信息。图里有明确数值时,只采用摘要列出的数值;没有完整数据时,就画方法关系或证据层次,不补造散点、误差棒和显著性星号。
九张图另提供独立图解册 PDF,适合放大阅读或课堂讨论。
读每张图,可以先遮住 Q4,自己写一句结论,再与本书的解释对照。如果你的句子比数据覆盖的人群、条件或任务更大,就需要缩小。如果结论写不出来,先回头查方法和结果,暂时不用急着填满四块。
5.13 CoolSmart AI:一张结果图怎样改变结论
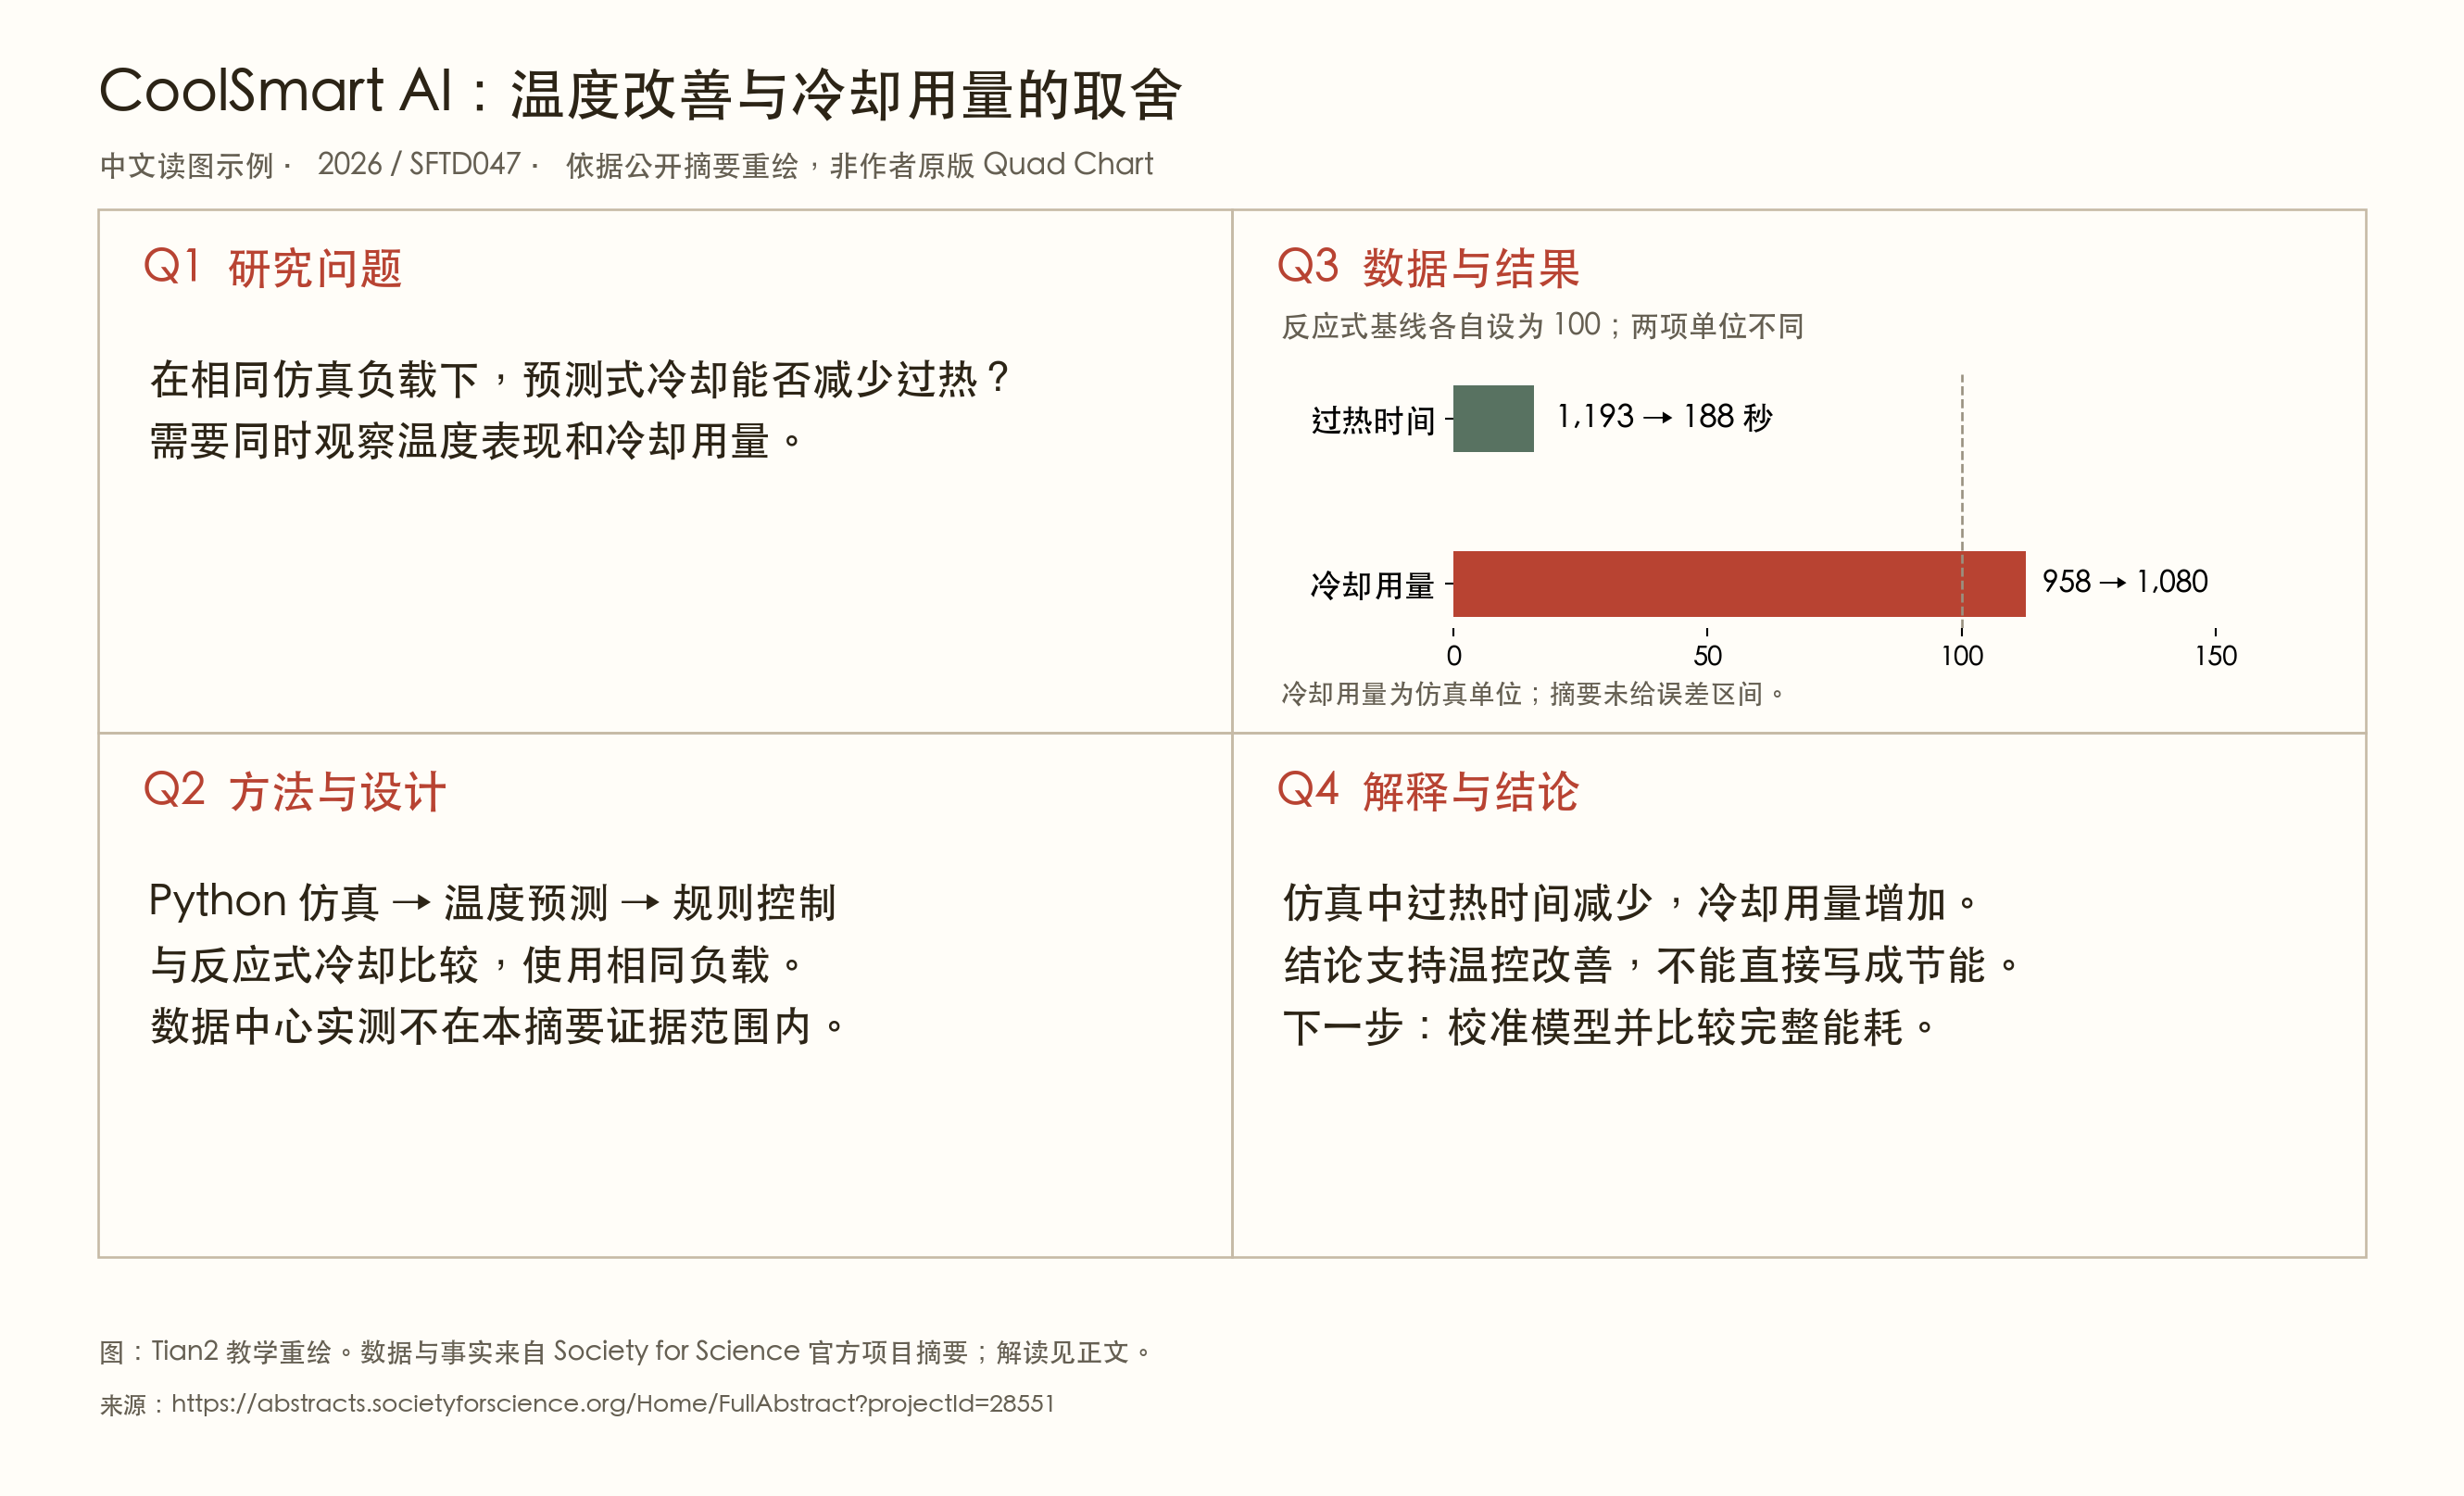
图 5-2|根据 2026 年 SFTD047 官方摘要重绘;不是作者原版。图中两项指标分别以反应式冷却为 100,保留原始读数与单位。官方摘要 · 高清图
Q1 如果写“实现节能”,Q3 就必须给能耗相关证据。这个案例报告的事实是:过热时间从 1,193 秒降到 188 秒,冷却用量从 958 增至 1,080 个仿真单位。前者约下降 84.2%,后者约增加 12.7%;两项百分比由摘要读数计算,没有额外实验含义。
图中把基线各自设为 100,是为了让变化方向一眼可见,并不是把“秒”和“冷却单位”变成同一种物理量。两根条形不能相减,更不能据此得出系统净收益。若冷却量增加避免了设备过热,是否值得,还要知道过热的后果和完整运行成本。
Q2 决定 Q4 能说多远。这里的测试发生在 Python 仿真中,因此可讨论该模型与负载条件下的表现。若写成“真实数据中心降低了能耗”,就同时跨过了仿真到实物、冷却用量到能源消耗两道尚未验证的关系。
更好的下一步不是继续修饰标题,而是补一个能回答原问题的比较:热模型怎样与实测校准,所有方案是否保持相同的安全约束,总用电量包括哪些部分?这些是后续设计建议,不是原作者已经完成的工作。
一句与当前证据相称的结论可以是:“在所设仿真负载下,预测式冷却减少了过热时间,同时增加了冷却用量。”读者既能看到过热减少,也不会漏掉增加的冷却用量。
5.14 AI 建议:两根柱子之间,未必是一项因果效应
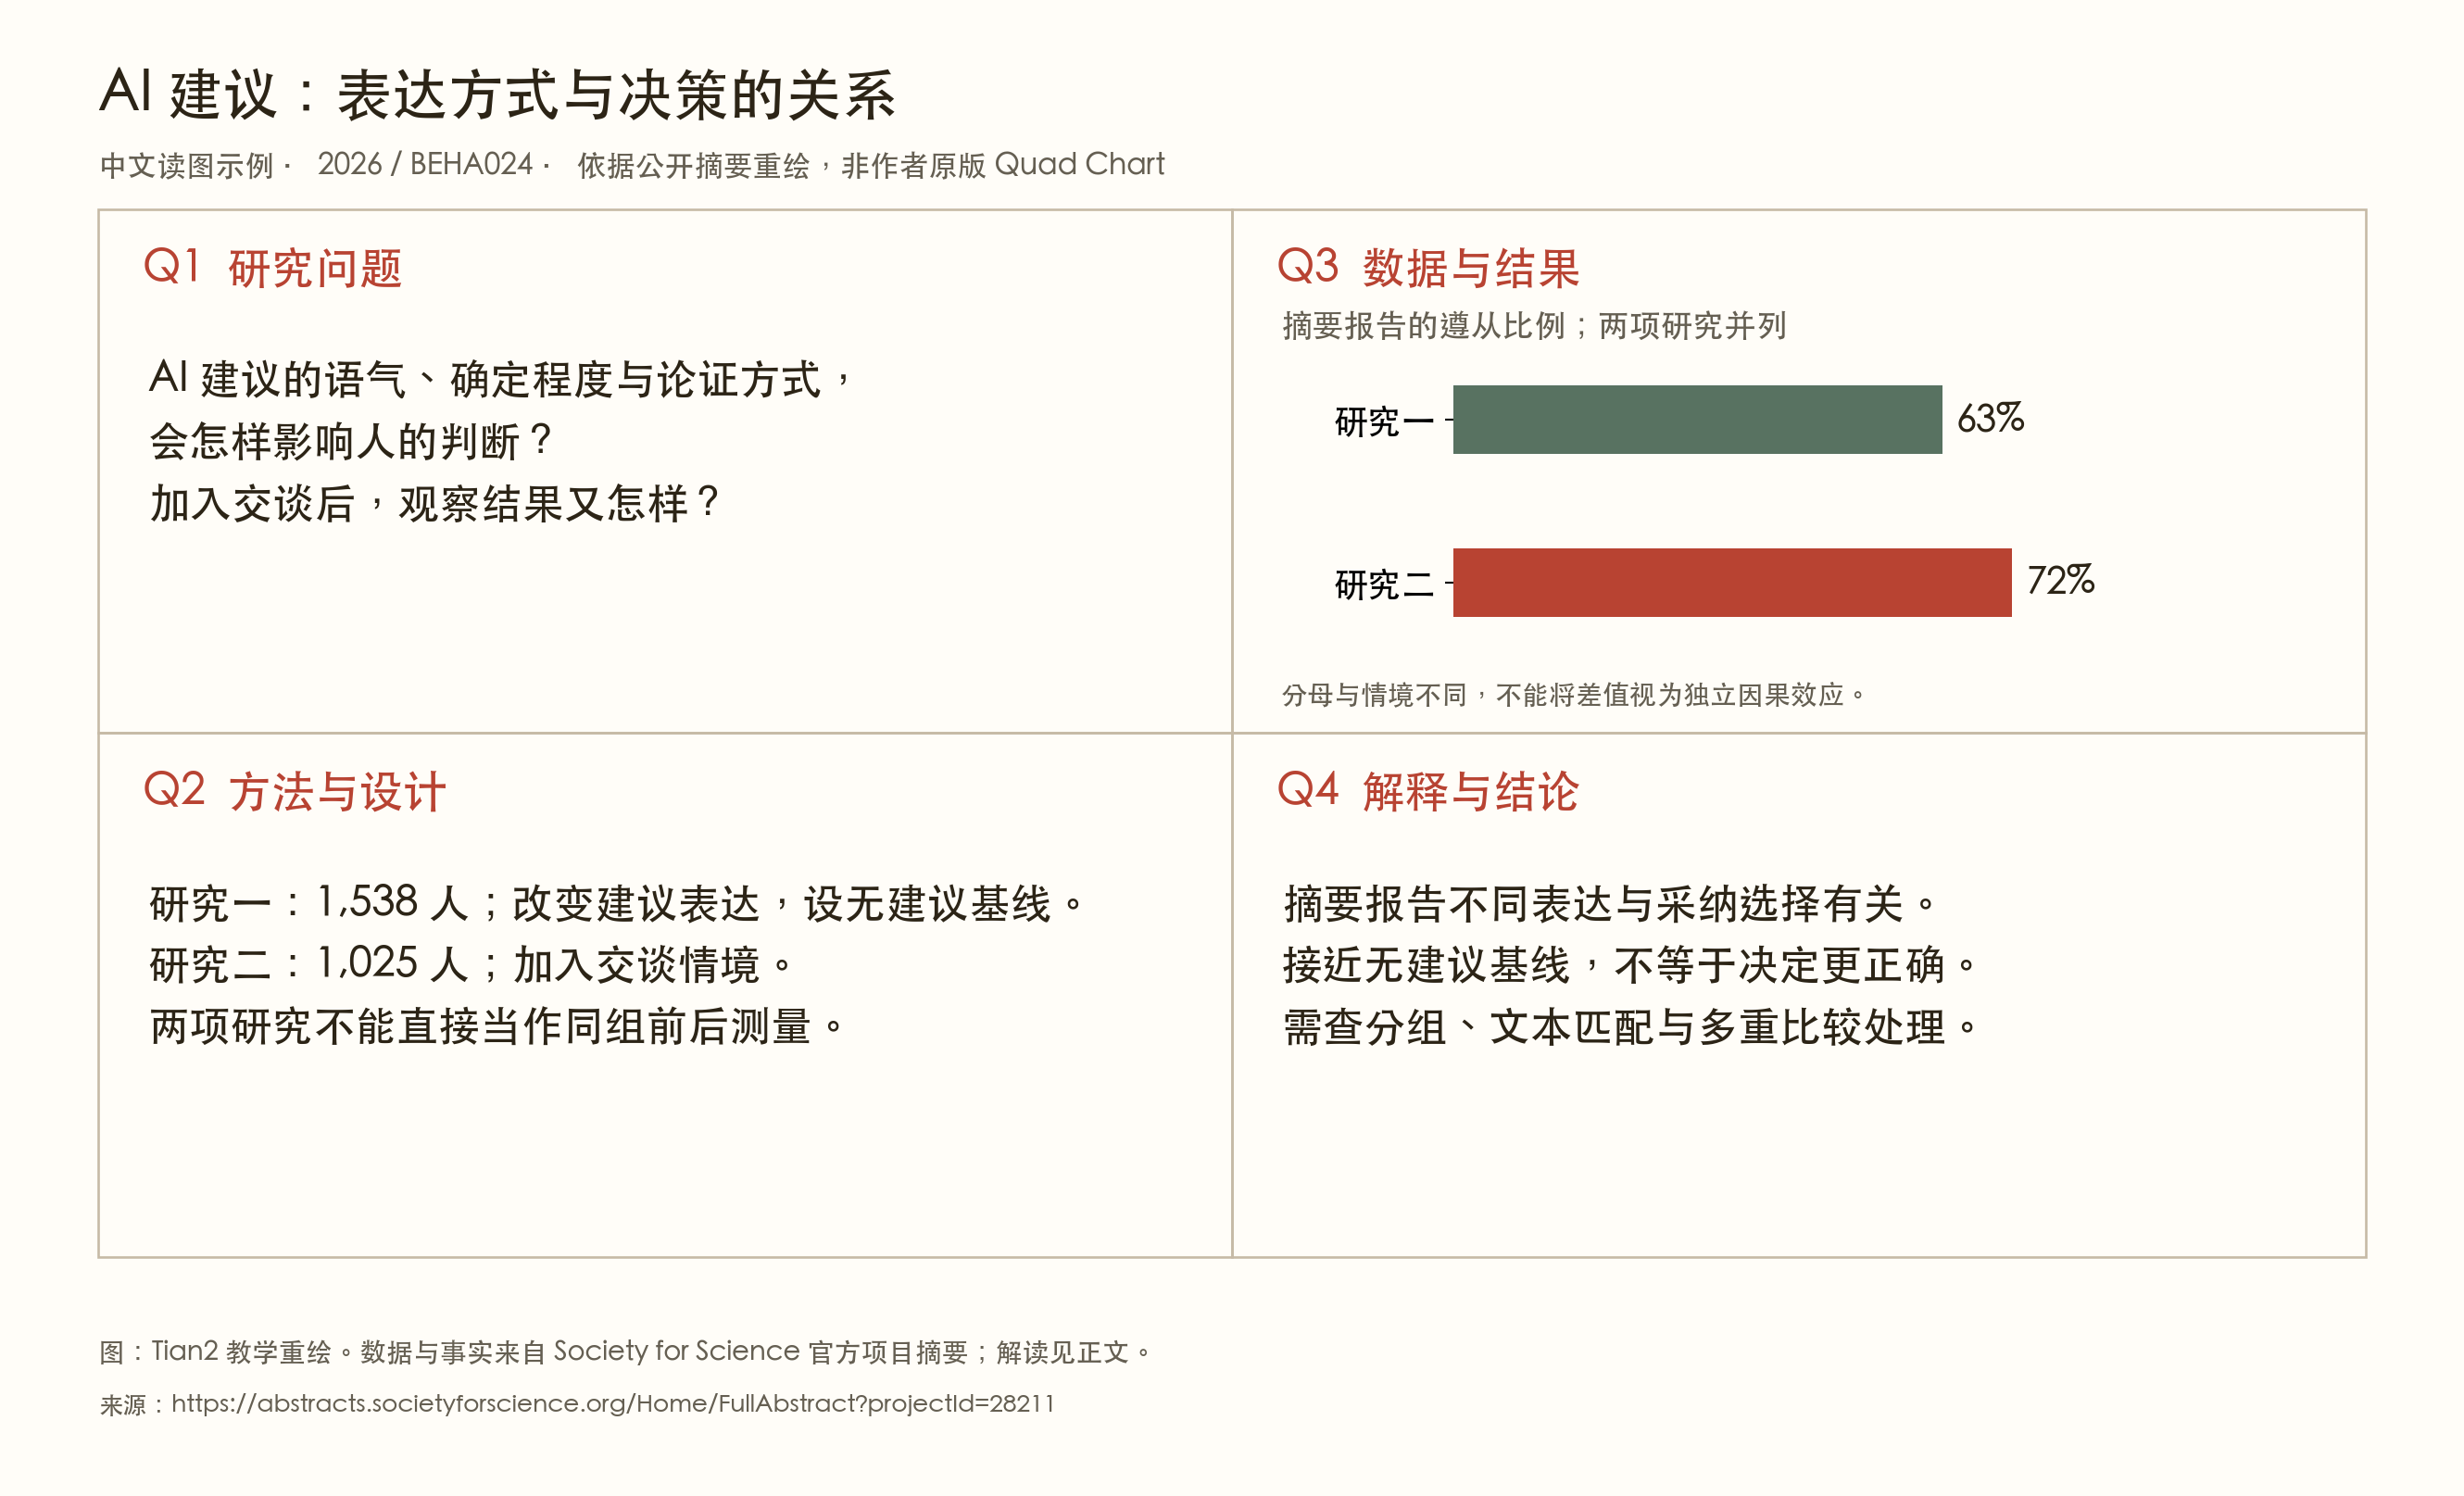
图 5-3|根据 2026 年 BEHA024 官方摘要重绘。63% 与 72% 来自两项研究,不是同一组人的前后测量。官方摘要 · 高清图
最容易写出的结论是“交谈使遵从率提高九个百分点”。但要确认这个因果判断,需要先看两项研究如何衔接:参与者是否可比,建议内容是否一致,分配方式和测量定义是否相同。摘要中有两个结果,不等于已经提供了这些条件的全部证据。
Q2 中的 1,538 人与 1,025 人分别是两项研究的参与者规模。第一项研究还包含多个困境和表达条件。不能不看具体分析单位,就用总人数给某个处理组补画置信区间;同一个人回答多个问题,也可能带来回答之间的关联。
再看 Q4。“更接近无建议基线”表示选择分布与基线更相似,它不等于判断更准确。道德困境中的正确性、责任感和是否采纳建议,是不同的概念。若题目关心独立判断,图表和测量就应围绕这一概念解释。
学生研究课堂反馈时,也会遇到类似问题。比较两种反馈文本,可以改变是否解释理由,同时尽量保持长度、难度与语气一致。如果把所有特征一起改变,即使结果有差异,也不容易知道哪项变化起了作用。
下次看到两根柱子,可以先在旁边写一句:“这两个分母怎样形成?”查清之后,再讨论差了多少。
5.15 蜜蜂:证据多,并不意味着每一项都相互独立
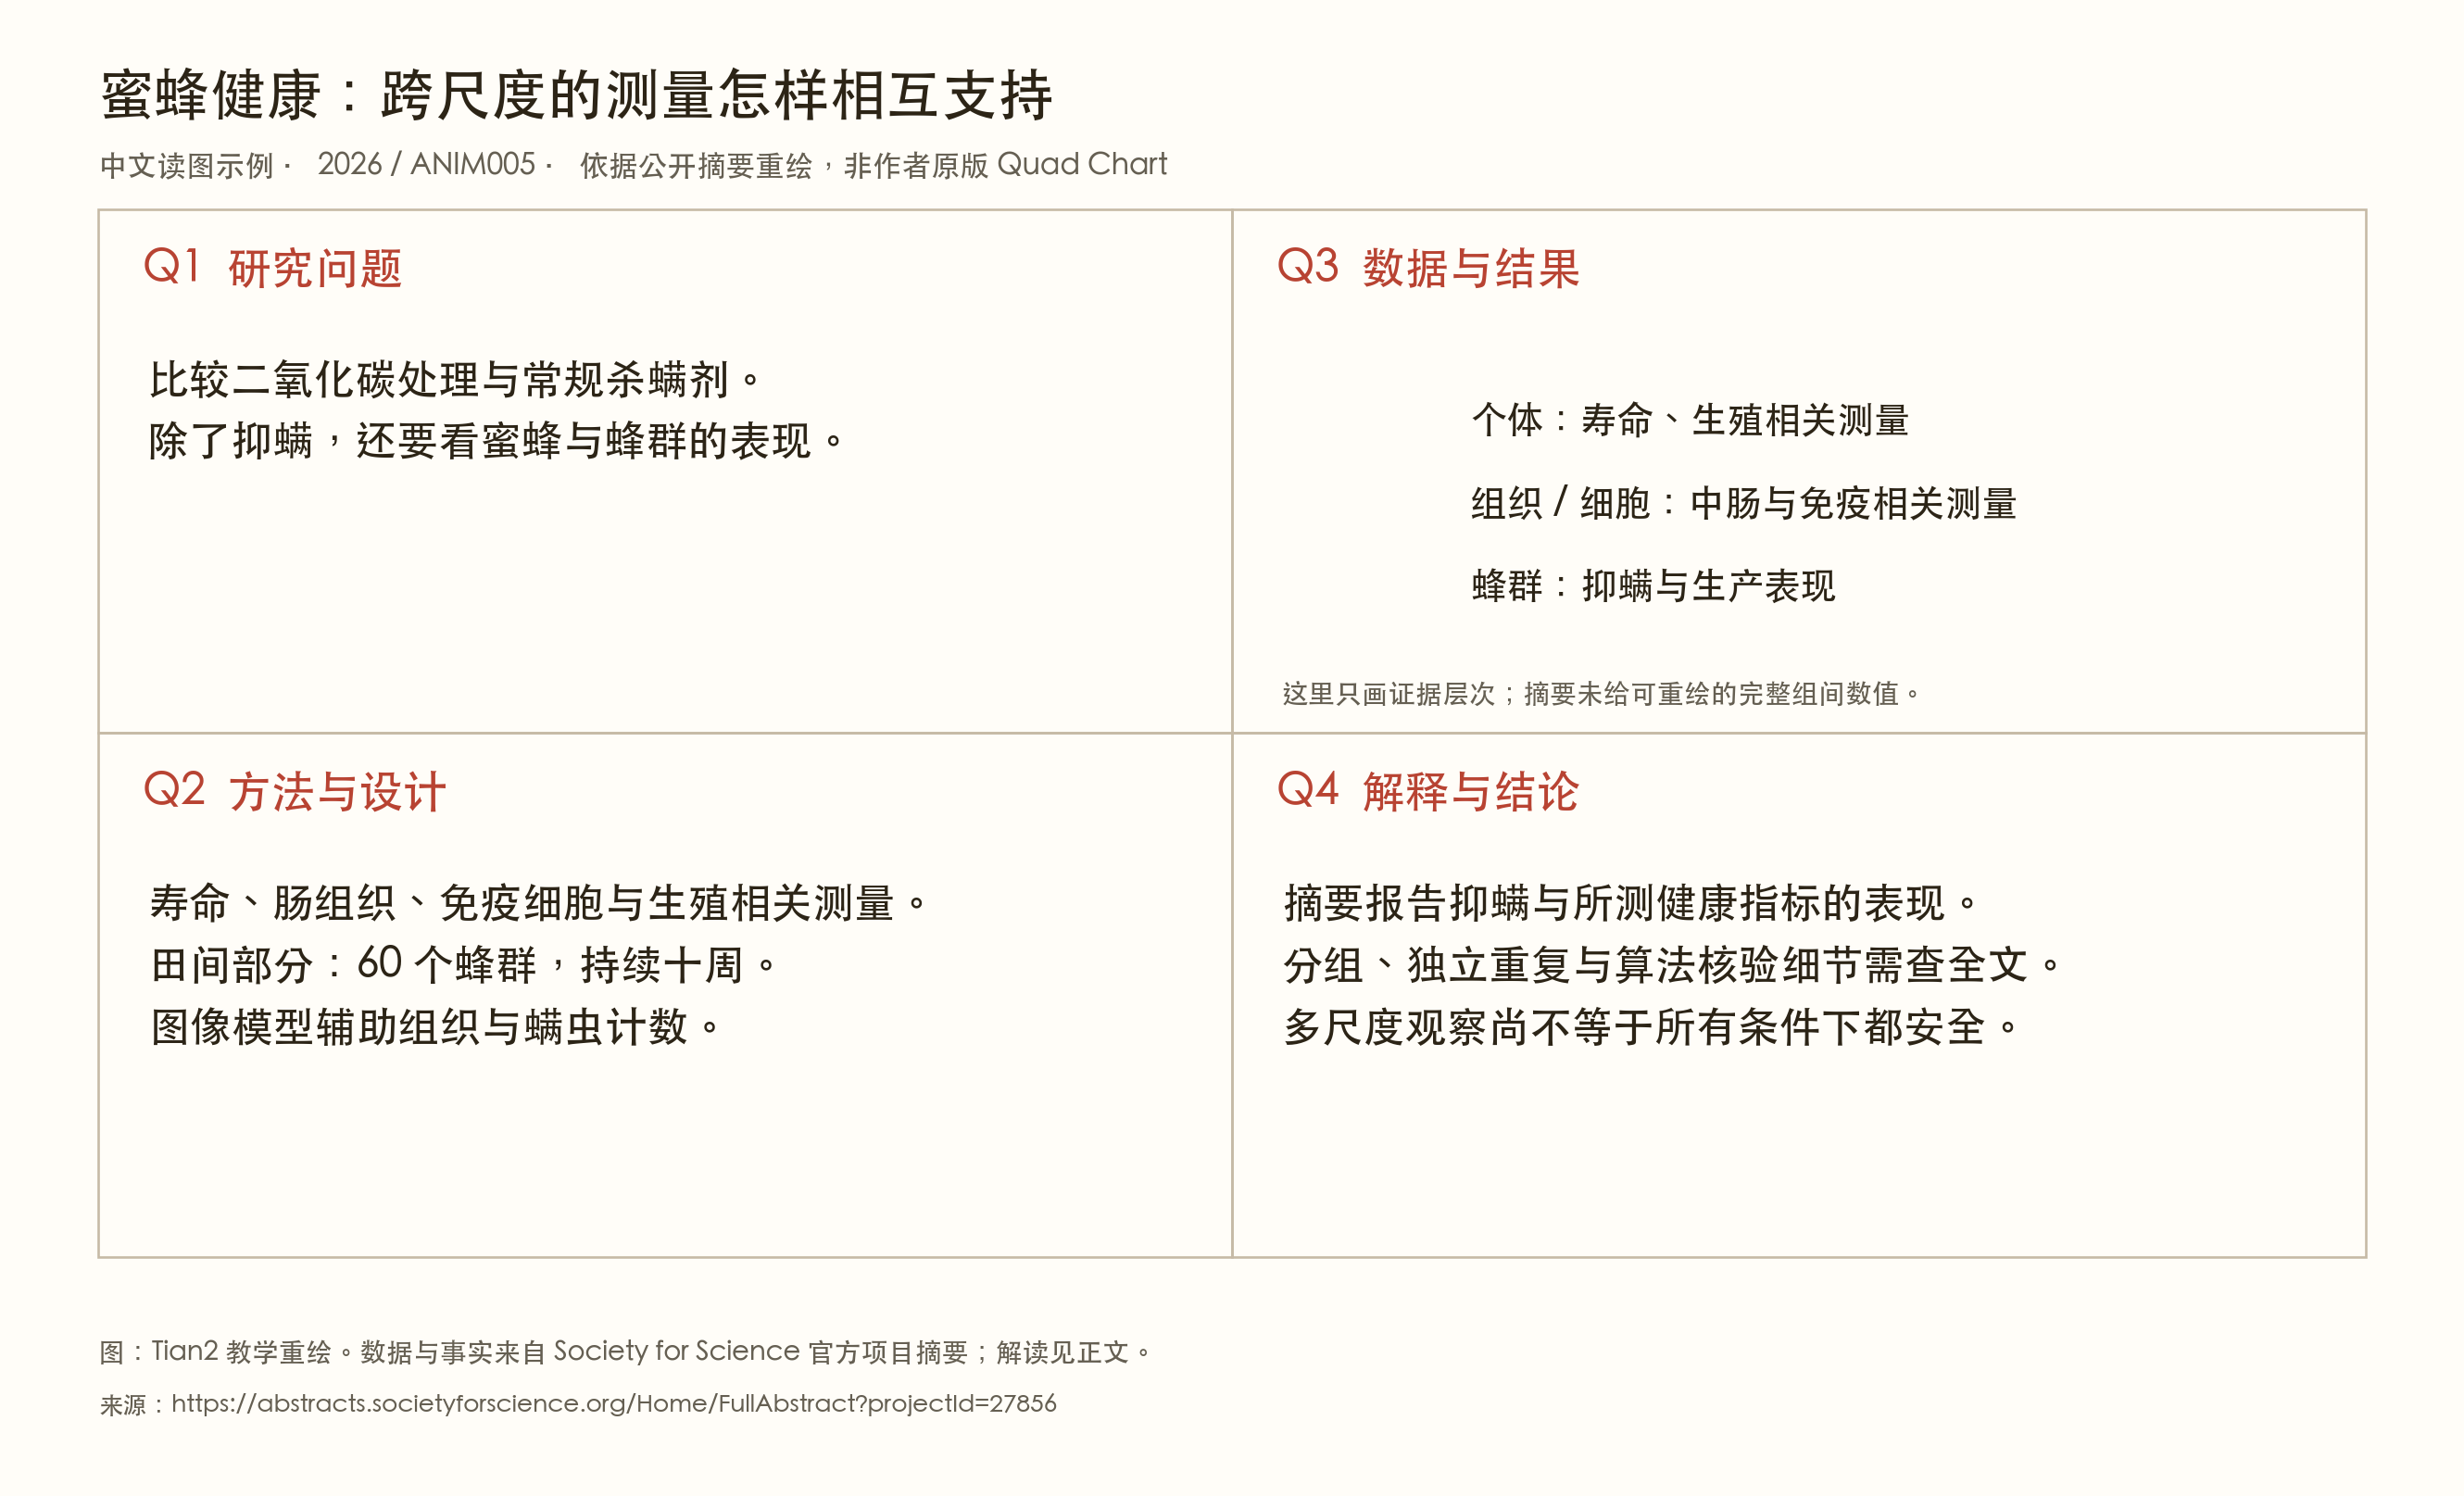
图 5-4|根据 2026 年 ANIM005 官方摘要重绘。Q3 展示证据层次,未虚构各组效果量。官方摘要 · 高清图
螨虫少了,蜜蜂本身怎样了?这个案例把两个问题放在一起研究。若只测螨虫数量,处理方法对蜜蜂组织、寿命或蜂群产出的代价可能被遗漏。四区图让读者看到,Q1 的问题决定了 Q3 需要哪几类结果。
多个测量值之间有什么关系,也要保留在分析里。假设从同一蜂群采很多只蜜蜂,再从每只蜜蜂拍多个视野,视野、蜜蜂和蜂群就形成了层级。它们不能全部当作同一层面的独立重复。这个例子说明应检查的结构,并不是对原作者具体取样安排的复原。
如果处理在蜂群层面分配,评价处理效应时就需要保留蜂群这一层。把蜂群中的个体全部打散,可能让样本看起来比实际更独立,进而低估不确定性。摘要只给出 60 个蜂群和十周田间观察,还不足以替原作者完成统计复核。
图像模型还增加了另一道测量问题:算法计数是否经过人工检查,误差是否在不同处理组中相近?若某组图像更容易被算法识别,表面上的组间差异可能部分来自测量方式。
写 Q4 时,可以讨论摘要报告的多项表现,但“对所有蜂种、地点、季节都安全”仍超出当前资料。结论需要列出研究实际覆盖的条件,不必替未来应用先作承诺。
5.16 再生片材:把性能取舍画清楚
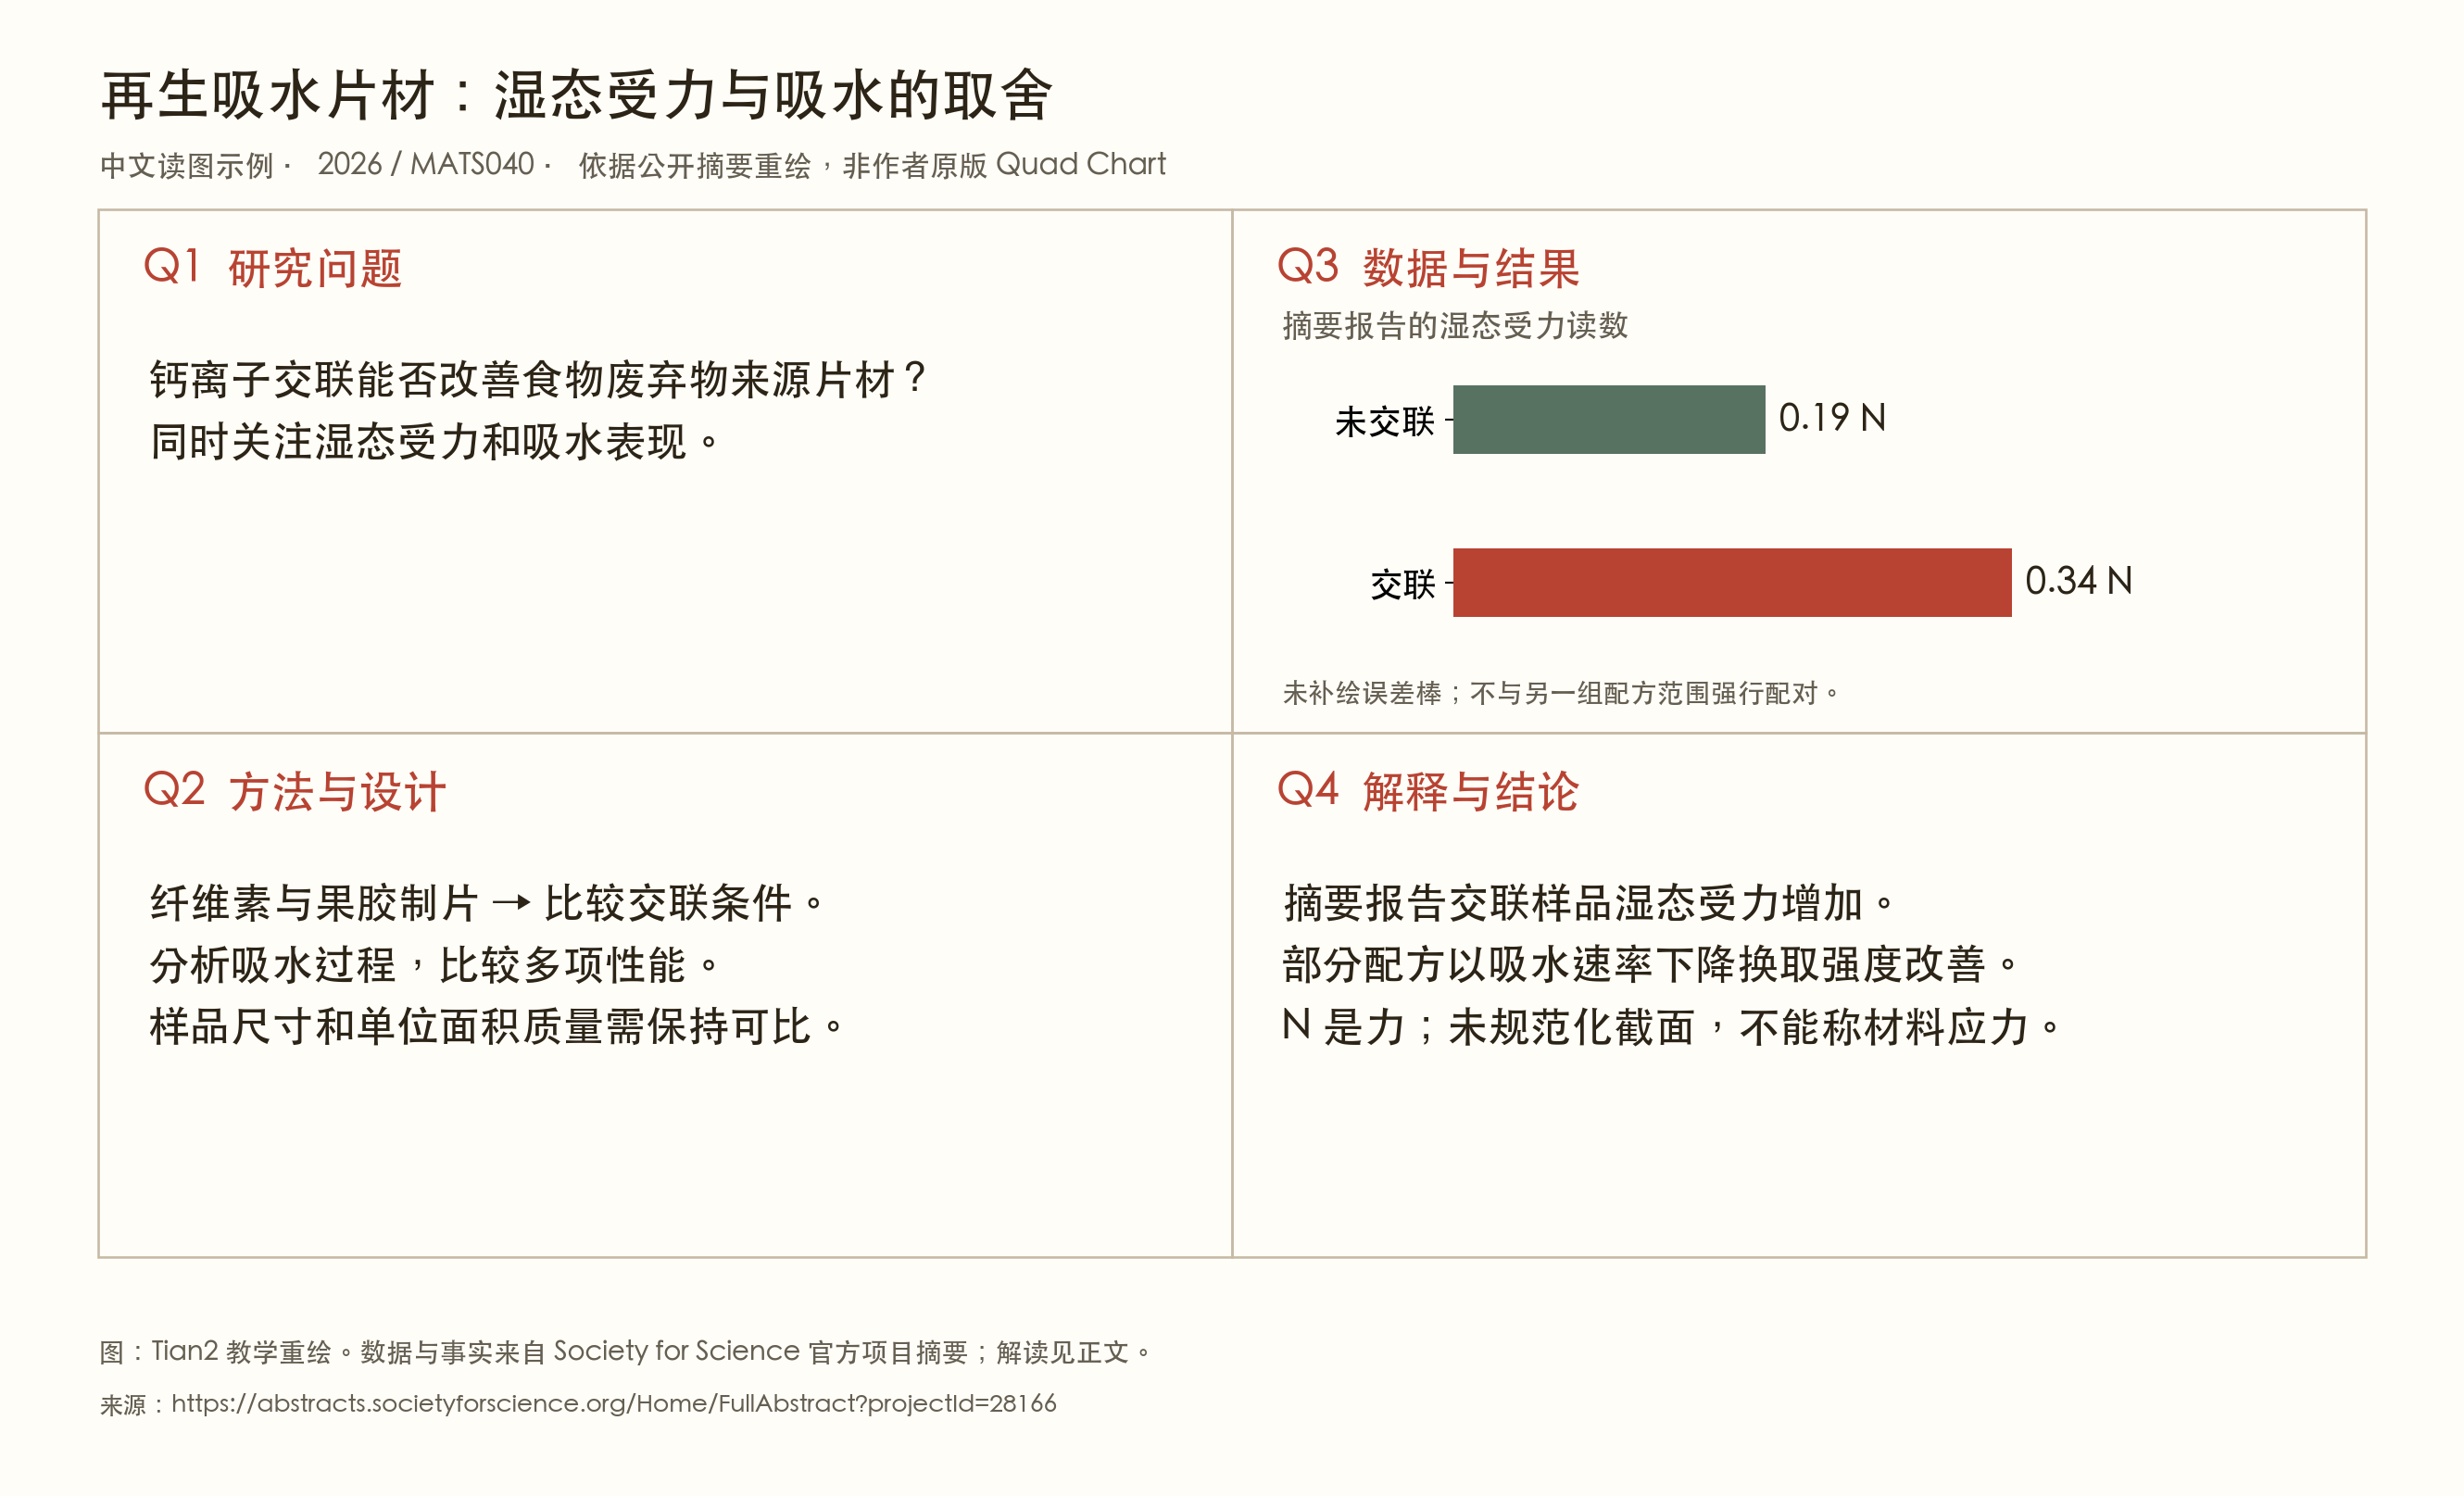
图 5-5|根据 2026 年 MATS040 官方摘要重绘。0.19 N 与 0.34 N 按原单位展示;未补画摘要没有提供的误差区间。官方摘要 · 高清图
这里有两个很容易混淆的比较。摘要一处报告交联样品的湿态受力读数从 0.19 N 到 0.34 N,按这两个读数计算约增加 78.9%;另一处讨论部分配方以吸水速率降低换取强度提升。它们未必是完全相同的样品组合,不能拼成“某一个配方同时实现全部最优指标”。
量纲也决定结论。牛顿表示力;若要比较材料应力,需要相应的截面积信息。两块厚度不同的片材承受不同拉力,并不能单独说明材料本身发生了同样比例的改善。Q2 应让读者找到尺寸、厚度、含水状态和制样批次。
如果有每个配方成对的原始数据,可以画吸水性能与力学性能的散点图,观察哪些方案在一个指标变好时牺牲了另一个指标。当前摘要给出的是若干范围,缺少完整配对关系,所以本书没有替它画一条貌似精确的最优边界。
画自己的结果时,也会遇到这种诱惑:手里只有几个范围,却很想画出一张完整的趋势图。把范围的上下限任意配成散点,会制造原数据没有表达的关系;为了让图更丰富而补出的点,反而会改变研究结论。
Q4 可以落在具体用途上:清洁用吸水片更看重哪项性能,包装缓冲材料又看重什么?“最佳配方”只有在目标和约束清楚之后才有意义。讨论用途属于设计判断,仍须与已经测到的性能分开。
5.17 泥炭地:把测量、代理指标和最终目标分开
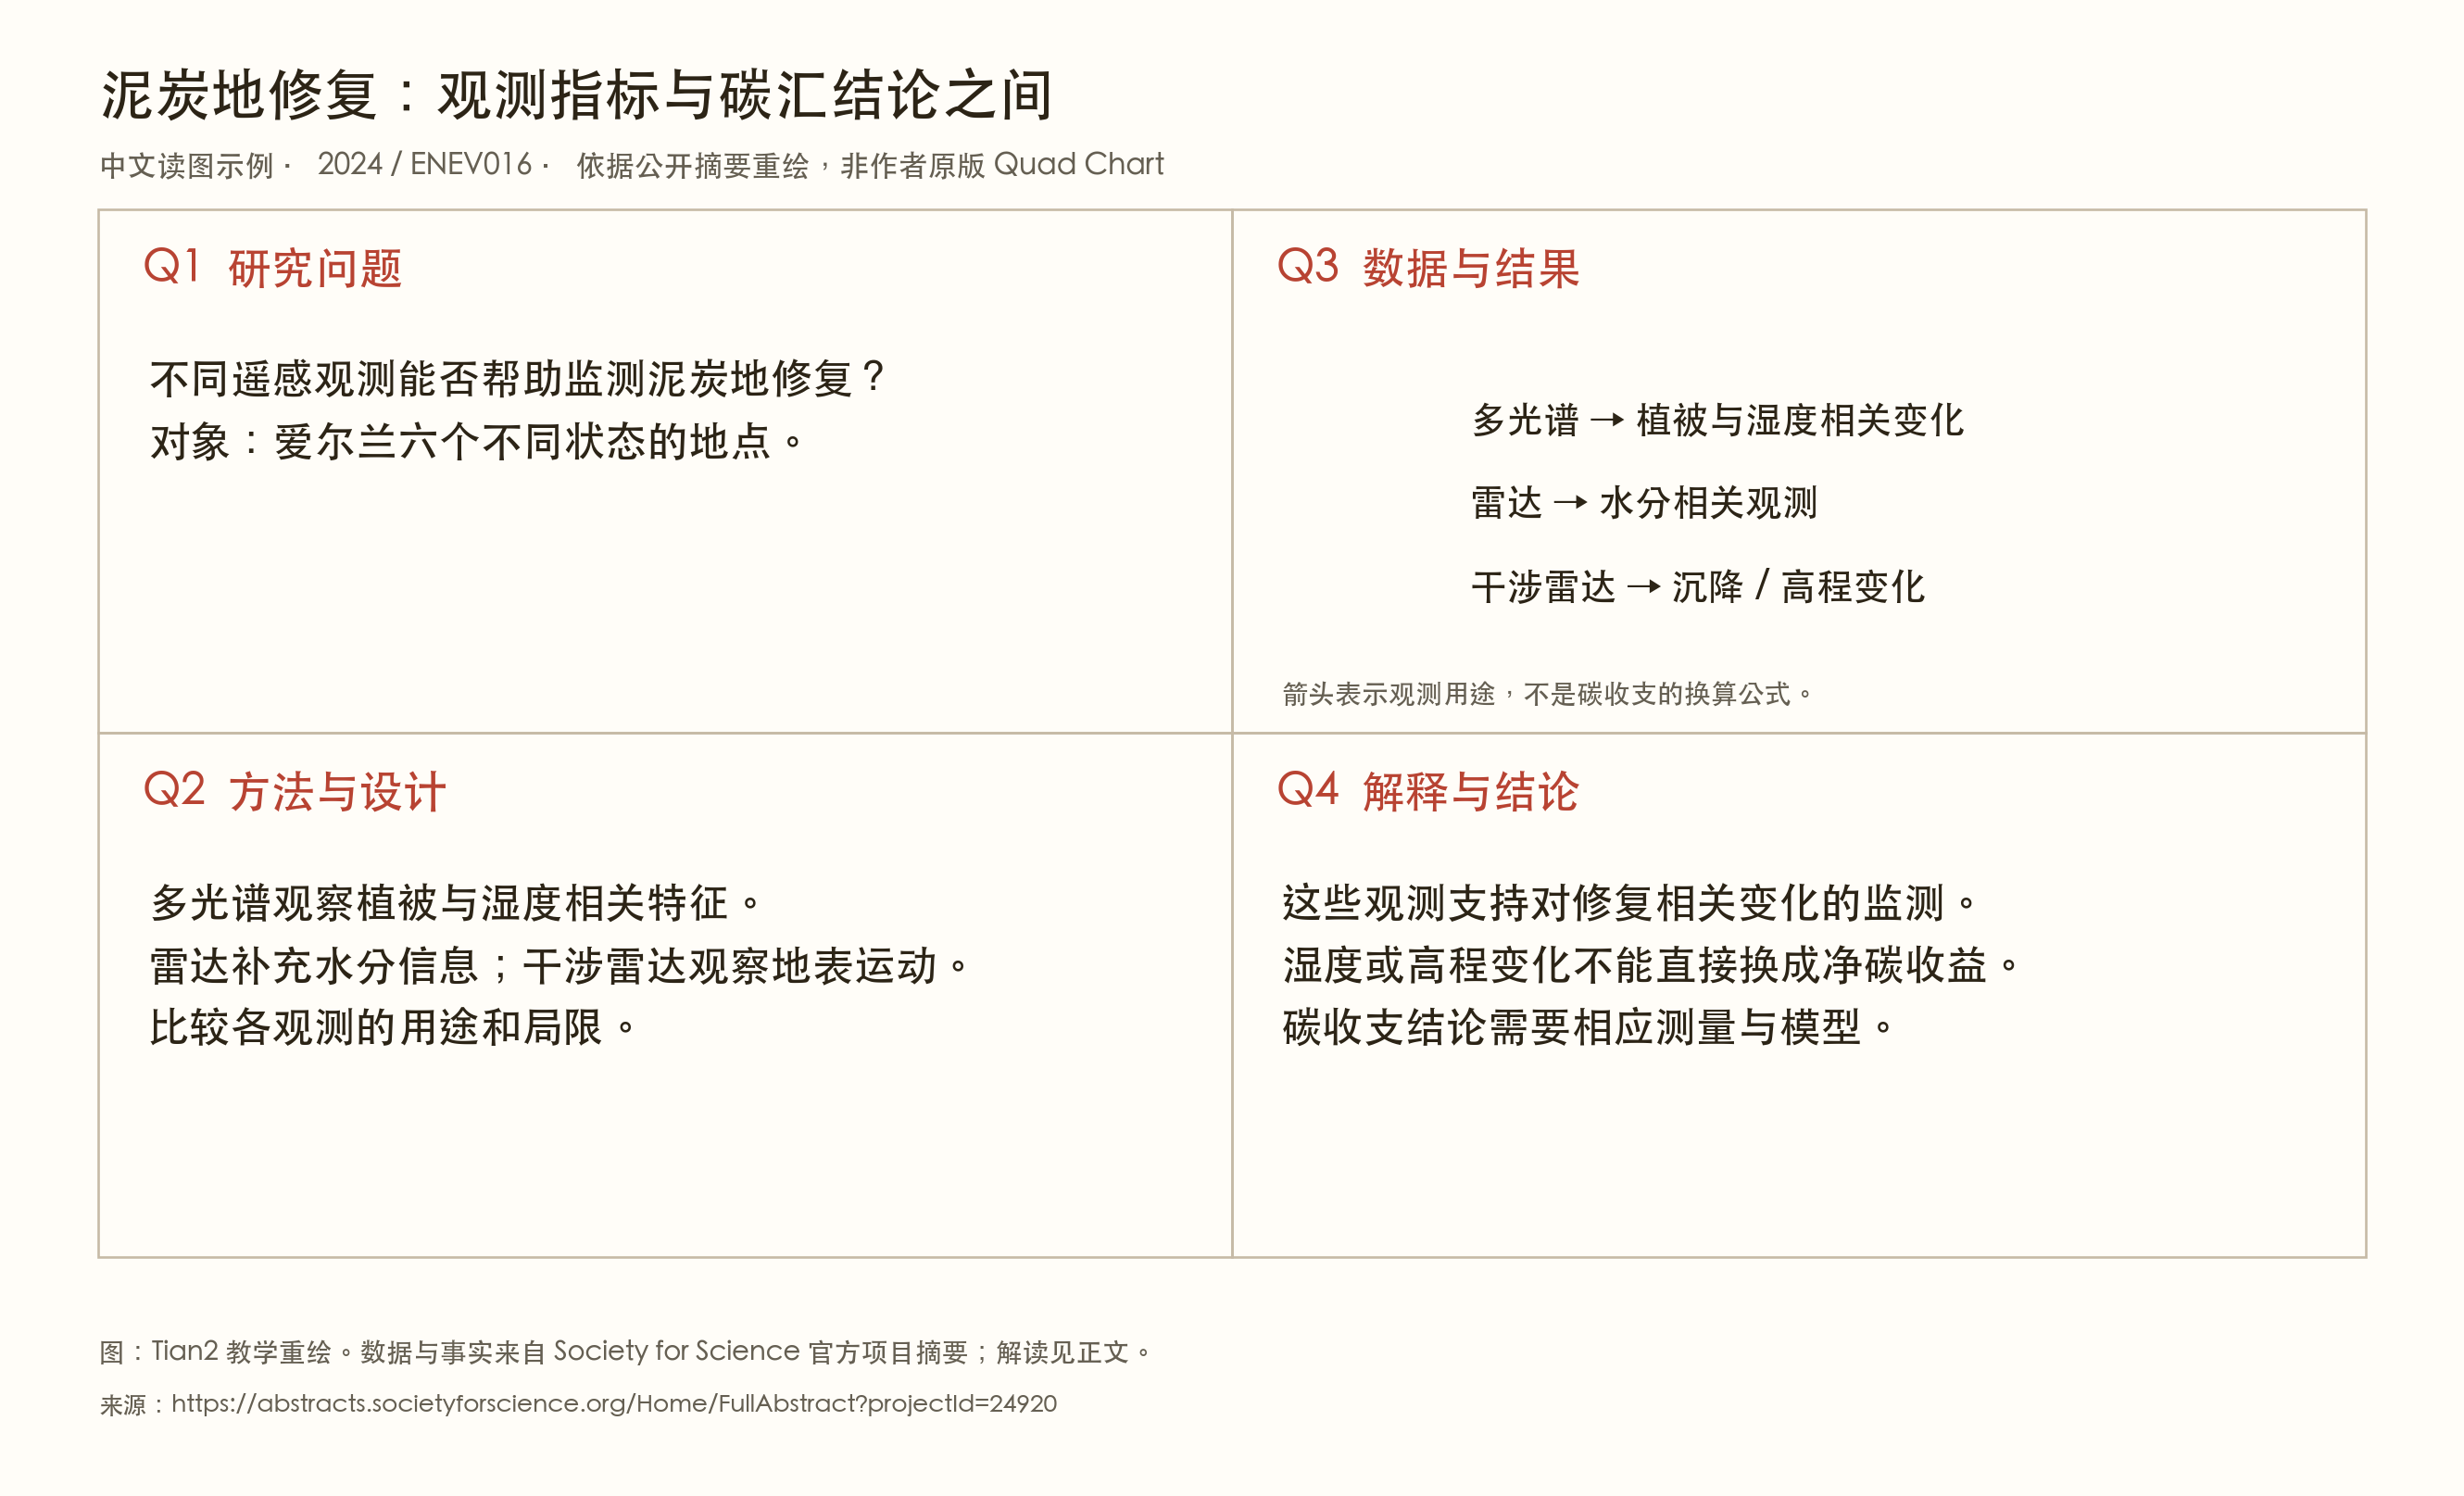
图 5-6|根据 2024 年 ENEV016 官方摘要重绘。箭头表示观测用途,不表示从遥感量到碳收益的直接换算。官方摘要 · 高清图
Q1 可以把碳储存作为研究背景,但 Q3 应展示实际观测到的内容:植被和水分相关特征、沉降或地表高程变化。把这两块分开后,读者就能发现一个常见跳跃:监测到修复相关变化,不等于已经测出净碳收益。
从观测走向目标,通常需要中间关系。某一遥感量与水文状态怎样对应,水文变化与生态过程怎样联系,哪些过程又进入碳收支?其中一环没有验证,最终数值就不能只靠画箭头产生。
多传感器也不保证多份独立证据。例如两种产品可能共享同一基础影像、同一参考标签或相同处理假设。它们结果一致,是值得继续检查的信息,却不能直接当作两次完全独立的验证。
如果是学生自己的项目,可以把结果拆成一张来源表:每个指标来自什么传感器或产品,代表什么,受什么条件影响,有没有现场参照。随后才决定是否合并。这种表格能帮助解释不同数据源为何一致或冲突。
摘要中的六个地点提供了明确研究范围。若要扩展到新地区,下一步应检查当地地表类型、气候和修复方式,而不是直接把模型输出区域涂满一张世界地图。
5.18 BiDEx:准确率为什么还回答不了筛查效果
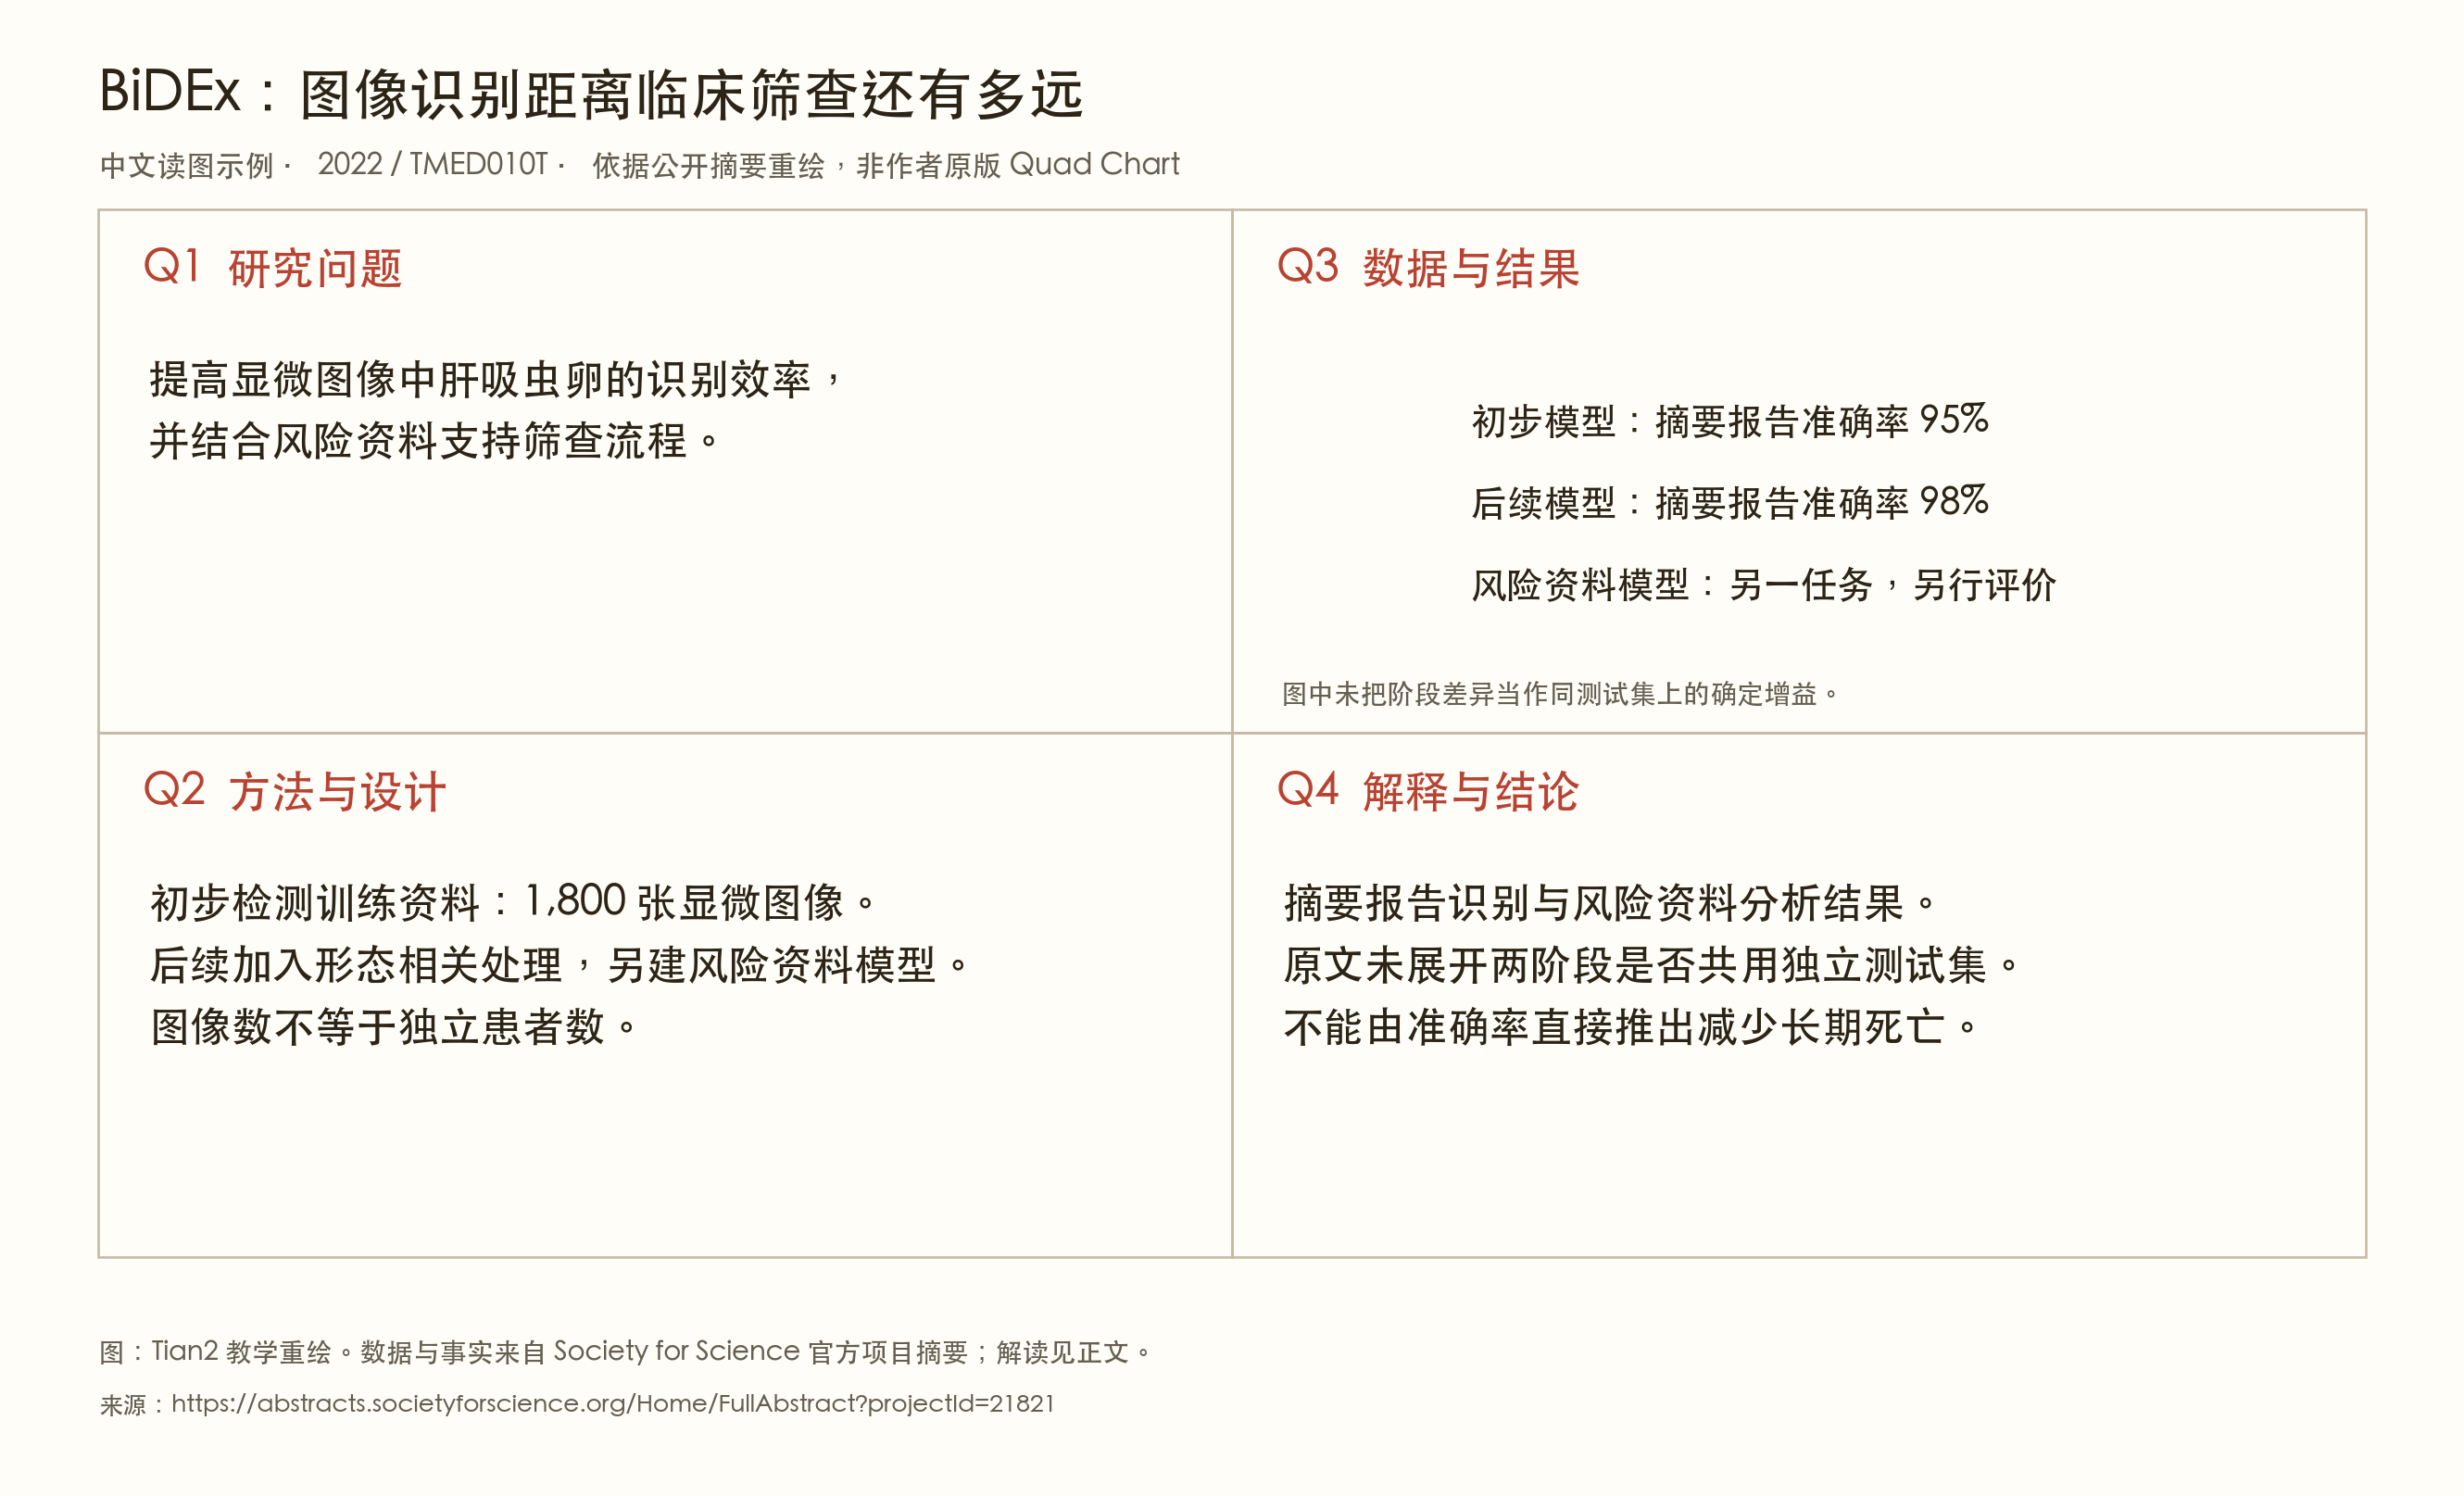
图 5-7|根据 2022 年 TMED010T 官方摘要重绘。两阶段准确率分别列出,不补充未公开的独立测试设计。官方摘要 · 高清图
Q3 中的 95% 和 98% 很醒目。首先需要确认它们针对什么任务、什么样本:同一张图像里有多少目标,是否按图像、标本或患者统计,测试中各类样本比例怎样?如果两个阶段的测试资料不同,仅凭数字还不能确定改进幅度。
再往实际筛查走,会遇到基础比例的问题。下面是独立的教学假设,所有数字都是为了演示计算而设定,与 BiDEx 的实际性能无关:假设有 10,000 人,其中 1% 符合目标疾病状态;某筛查方法的灵敏度为 90%,特异度为 95%。
| 教学假设下的筛查结果 | 实际有目标疾病:100 人 | 实际无目标疾病:9,900 人 |
|---|---|---|
| 检测阳性 | 90 人 | 495 人 |
| 检测阴性 | 10 人 | 9,405 人 |
这里有 585 个阳性结果,真正有目标疾病的是 90 人,阳性预测值约为 15.4%。这个例子不评价原项目,也不是临床建议;它只是说明,脱离实际人群的基础比例,不能从一个看起来较高的模型指标直接推断筛查后会发生什么。
Q2 中的 1,800 张图像也不能代替独立患者数。来自同一标本的图像若进入不同数据分组,会让测试看起来比对新患者更容易。只有保留图像与标本、患者之间的来源关系,才能判断划分是否符合研究目标。
于是,Q4 需要分层:图像检测表现如何,筛查流程能否工作,患者是否因此得到更及时或更有效的处理。每往后一层,都需要相应证据,不能由同一个准确率包办。
5.19 数学:Q3 不一定是一张实验曲线
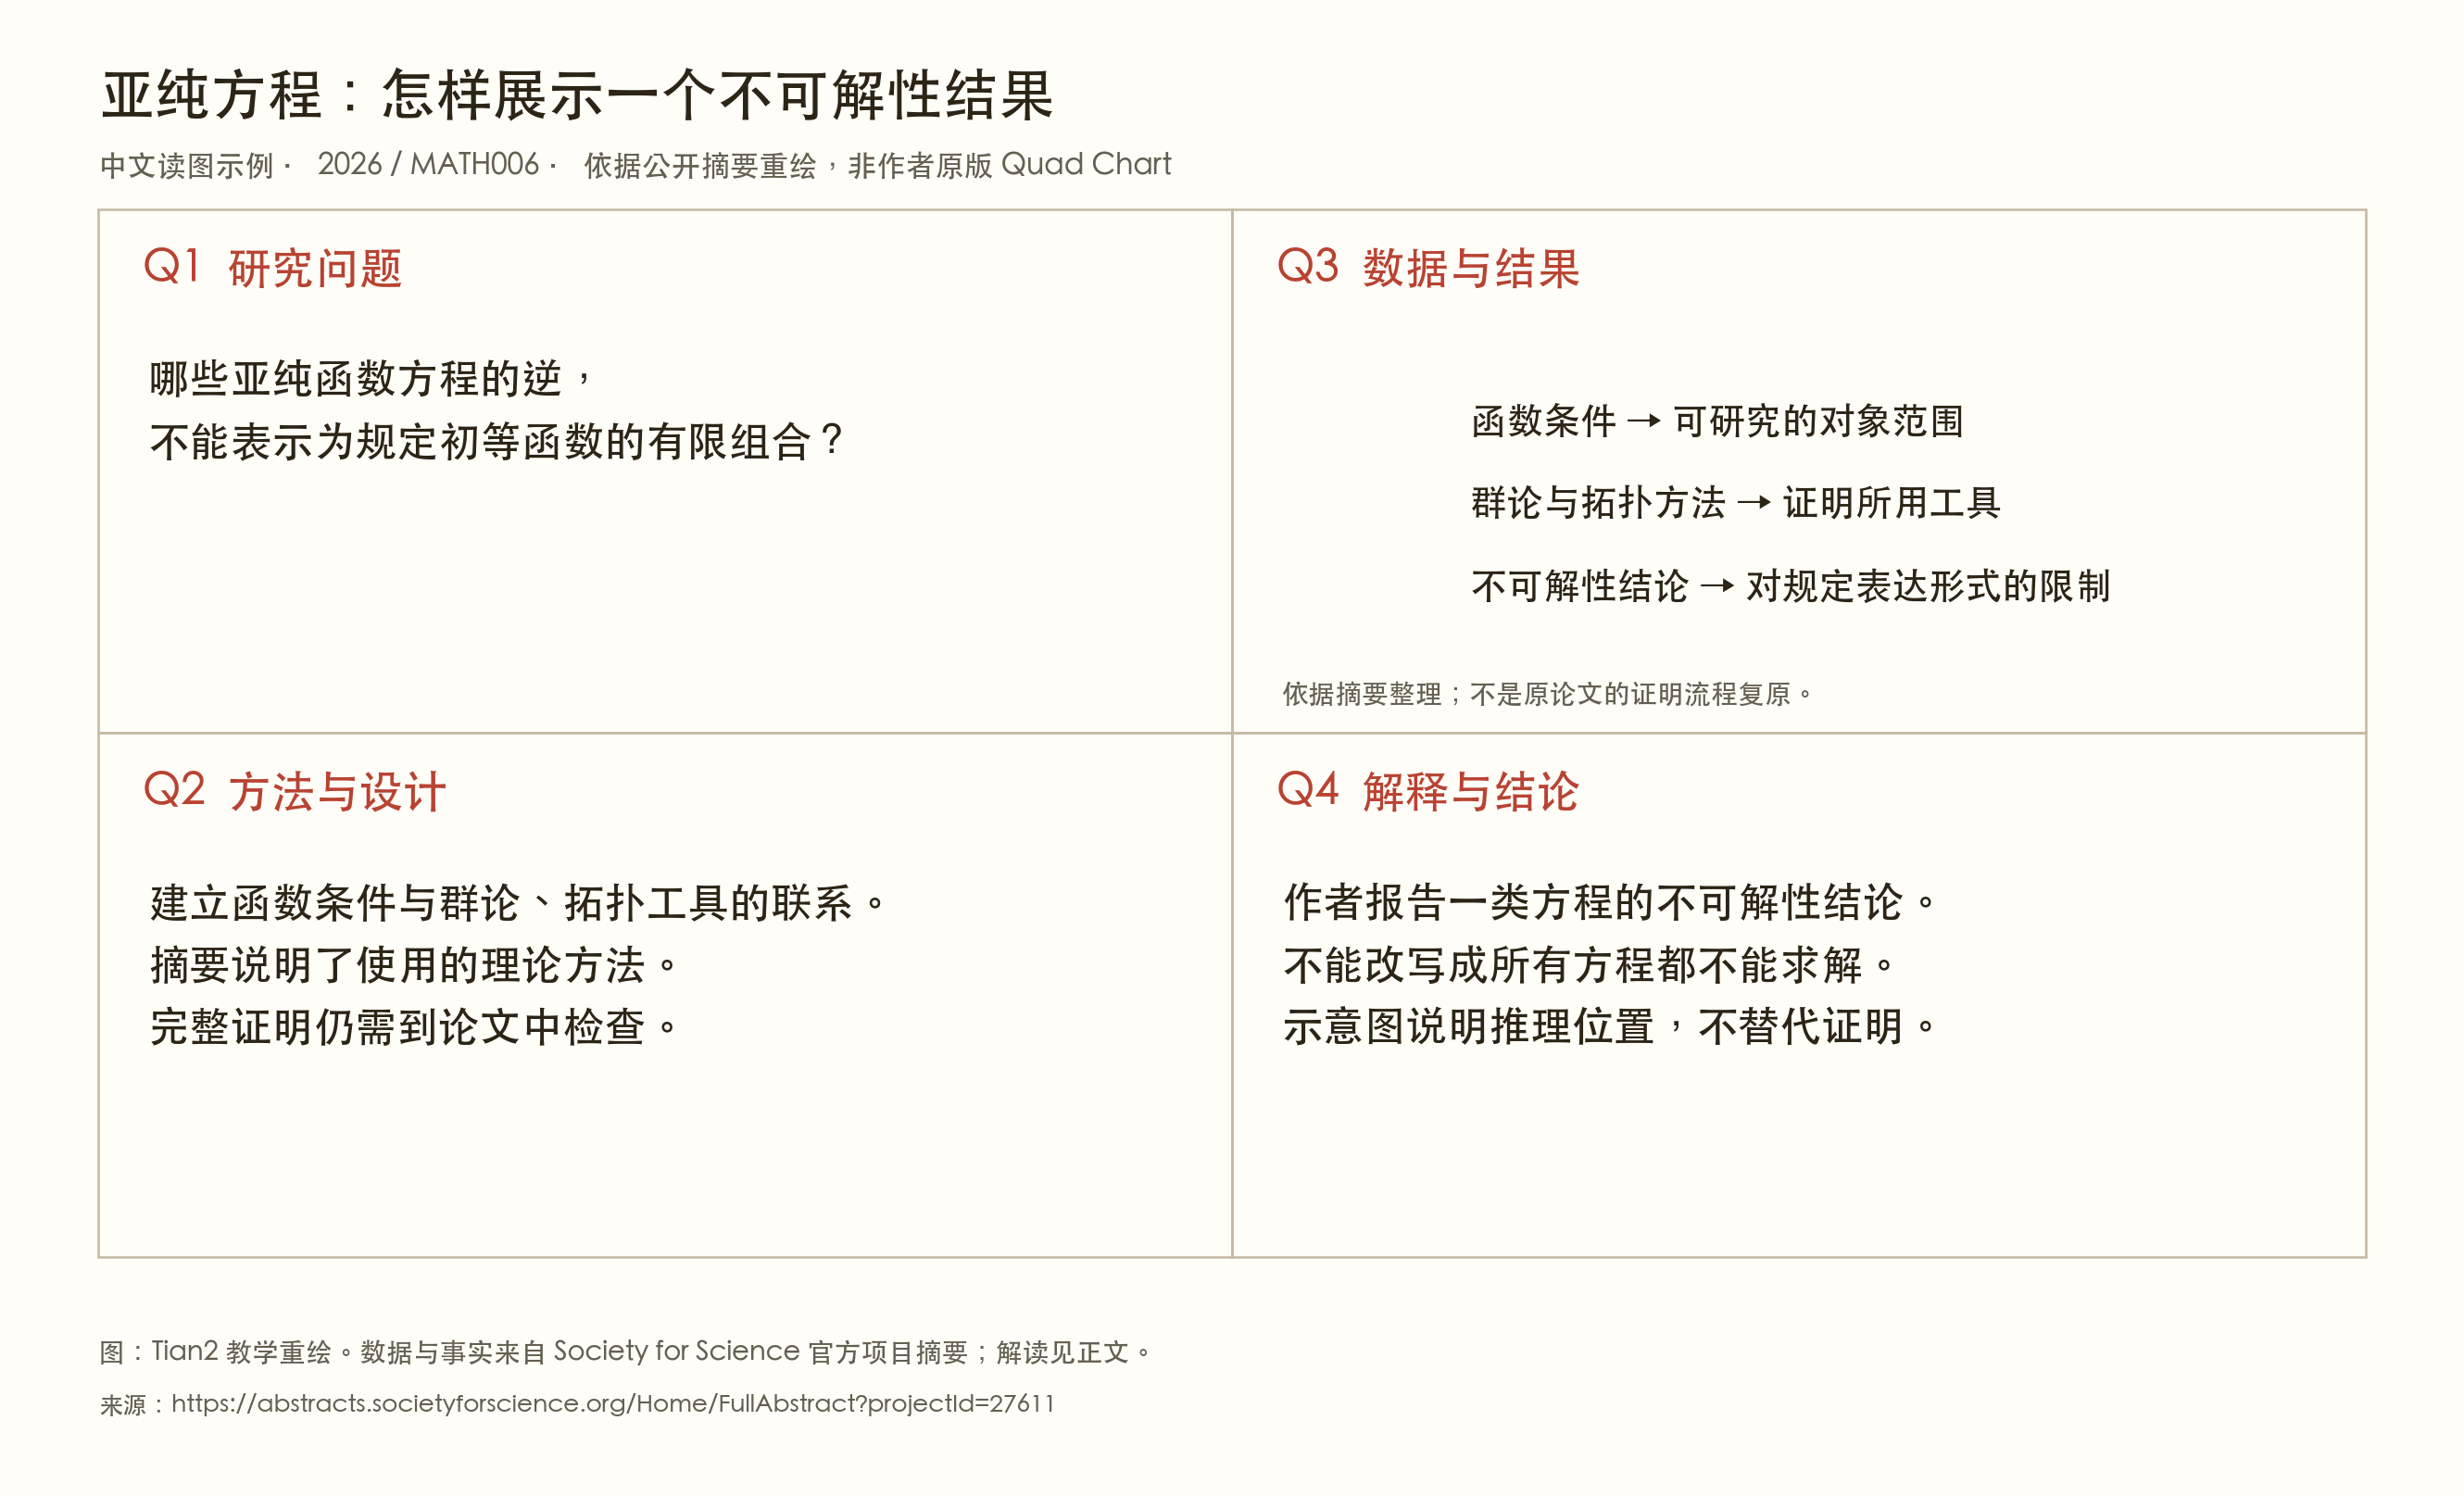
图 5-8|根据 2026 年 MATH006 官方摘要整理。图中仅说明条件、工具与结论的位置,不是对原论文证明的重建。官方摘要 · 高清图
理论项目也可以使用四区摘要。Q1 给出精确问题,Q2 说明对象、定义和所用方法,Q3 陈述新结论与证明的关键想法,Q4 交代它相对已有工作推进到哪里。无需为了看起来像实验项目而增加一张无关柱状图。
这个案例讨论某类方程是否能用规定的初等函数表达求解。不可解性是相对于允许的表达方式而言,不是说任何数值近似都不可能,也不是说作者计算到某一步放弃了。术语的范围必须在图中或配文中解释清楚。
为什么计算许多例子仍不等于证明?可以用一个与获奖项目无关的小练习理解:前 n 个正奇数之和等于 n²。代入一百个 n 可以提供线索,但一般证明需要覆盖任意正整数。例如从 n 项成立出发,加上下一项 2n+1,得到 n²+2n+1=(n+1)²,再配合起始情形,就建立了归纳证明。
这个简单例子说明图表与证明各自承担什么任务。数值图可以展示规律,证明解释为什么在规定范围内成立。原项目的数学远更复杂,本书没有完整论文,就只能介绍摘要明确报告的命题范围和理论工具。
读者看 Q3 时,应寻找“作者新增的命题”与“引用的已有定理”的分界。若图中把两者都写成创新点,读者就无法判断学生的实际贡献。答辩时能解释这条分界,比罗列高级理论名称更有说服力。
5.20 CloudGen:没有效果数据时,图里应留下什么
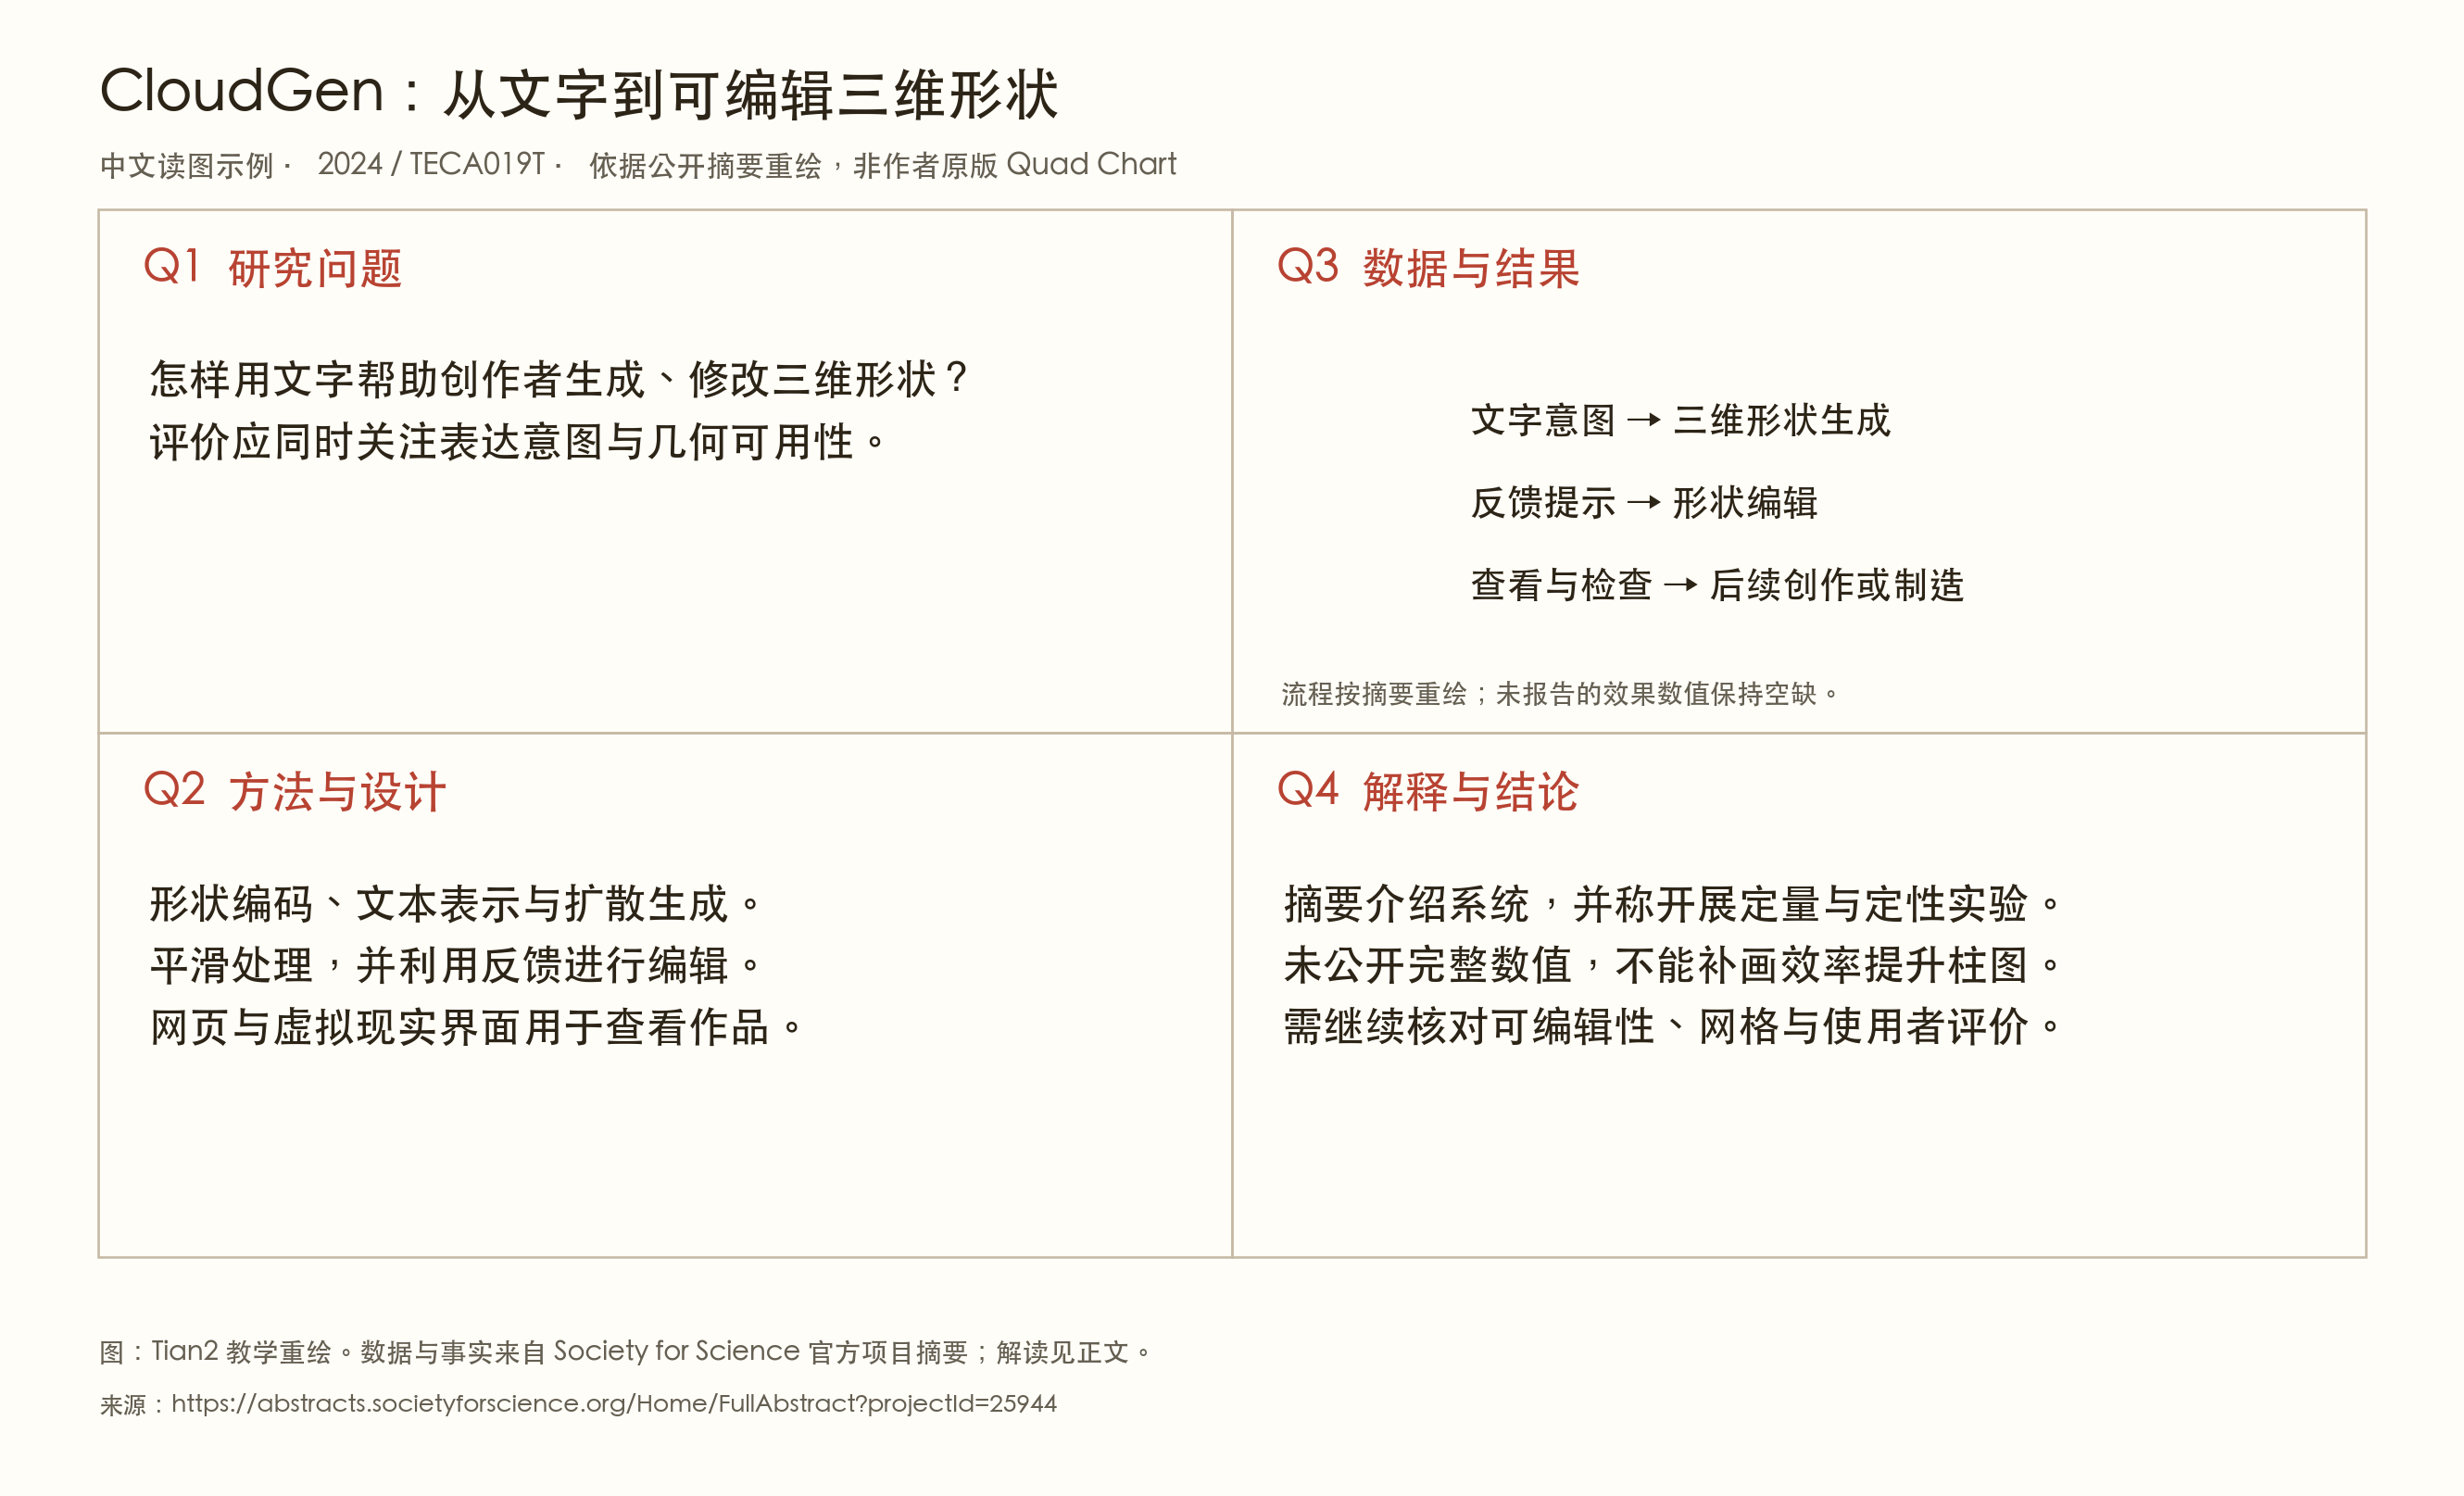
图 5-9|根据 2024 年 TECA019T 官方摘要重绘。Q3 保留流程与公开信息范围,没有补造使用者实验结果。官方摘要 · 高清图
这张图的结果区没有效果柱状图。原摘要介绍了系统,并称开展定量与定性实验,却没有提供完整效果数值。我们可以画清功能流程,但不能画出一根“创作效率提高 60%”的柱子,也不能把作者展示的渲染图当作用户体验已经改善的证据。
流程图放在 Q3 的位置,提醒读者当前公开信息的限度;在学生自己最终提交的研究里,如果主张提高创作效率,就应补上真实、对应的测试结果,而不是一直以流程代替结果。
“生成得像”与“创作者能控制”可以采用不同的评价。前者关心形状与意图的对应,后者关心能否局部修改、是否需要反复重做、能否保留已经满意的部分。可打印性还需要检查几何结构和制造条件,不能由一张漂亮渲染图替代。
假如学生比较两种编辑方式,最好给使用者同样的任务,处理任务顺序和学习效应,并同时保留完成时间、失败或返工情况。参与者满意度可以补充理解,但不能单独证明任务完成得更好。这些是本书提出的后续评价思路,原摘要没有说明已经按此实施。
这一例适合提醒自己:公开资料缺少数字时,写出缺口。读者可以带着这个缺口继续查材料,知道还需要哪项结果。
5.21 从官方评审要求走到一场具体的图表讨论
官方评审标准分别讨论研究问题、设计、执行、创造性与潜在影响,以及展示和面谈。面谈关注学生是否理解研究、结果的解释和限制;工程项目还强调原型与多种条件下的测试。官方评审标准
四区图可以帮助练习这些讨论,但在所核对的官方评审标准中,没有“Q1 值多少分、Q4 值多少分”的换算表。更不能因为四块都填满,就认定研究已经完整。一个缺乏公平基线的实验,排版再整齐也不会增加证据。
| 图中位置 | 用现有案例练习的追问 | 回答时应拿出的材料 |
|---|---|---|
| Q1 问题 | CoolSmart AI 想解决过热还是节能? | 预先定义的目标和约束,以及二者之间的关系 |
| Q2 方法 | 蜜蜂试验中的独立研究单位是什么? | 分组、采样层级与重复测量记录 |
| Q3 结果 | 片材的 N 表示什么,样品是否可比? | 原始读数、样品尺寸、测试方法与误差说明 |
| Q4 结论 | 泥炭地观测能否直接支持净碳收益? | 从测量指标到目标结论的每一步依据 |
| 四区之间 | BiDEx 的图像指标与实际筛查怎样连接? | 数据来源、独立测试与后续流程的证据 |
如果一时答不上来,可以指出目前资料缺在哪里,以及需要看什么才能判断。不必急着用另一段背熟的话填满空白。能够发现一个尚未解决的问题,本身就是理解研究的表现。
练习时可让同学挑一张图,只围绕一个数据点连续追问:它怎样获得、单位是什么、分母是什么、误差来自哪里、支持哪一句结论。练完再修改图,把读者反复误解的部分画清楚。
5.22 把自己的四区摘要做成可以检查的研究说明
先写一句主要结论,再找出直接支持它的那张图。若找不到对应数据,就检查结论是否写得过大,或者研究是否还缺一个必要比较。这一步应发生在选颜色和字体之前。
随后补上能让读者理解结果的最少方法信息。实验项目要能看到比较条件与样本单位;模型项目要说明训练和测试关系;理论项目要写明适用条件与证明依据。删去的应是多余背景,不能是解释结果不可缺少的限定。
最后把标题和 Q1 再读一遍。是否承诺了图里没有验证的功能?是否把未来用途写成已经实现?是否让读者误以为图中数字来自现场或患者,而实际只是模拟?这些地方改准之后,整页通常也会更简洁。
书中的中文图用于学习。学生的正式参赛材料应由学生依据自己的研究完成,并按第三章说明遵守当年 AI 使用、语言、图源与提交要求。教材里的重绘案例不能改个姓名就变成自己的作品。
第六章 参赛支持与资源
6.1 现在是否适合开始
“我还不会做研究,现在开始是不是太早?”很多学生会有这个疑问。方法可以逐步学,先看看自己是否愿意为一个问题留出固定时间。读不懂时能不能继续查,结果奇怪时会不会想找原因,这些比起步时会多少技术更值得观察。
以下问题适合学生与家长、老师分别思考,再一起讨论。它们没有总分,也不用于预测获奖。
| 讨论内容 | 可以用什么事实回答 |
|---|---|
| 我对这个方向的兴趣有多具体? | 最近主动读过或做过什么,哪些问题仍让我困惑? |
| 我是否有连续时间? | 一周中哪些时段可以稳定投入,考试季如何调整? |
| 基础是否足以开始? | 能否解释题目中的主要概念,哪些知识需要补学? |
| 条件是否真实可得? | 数据、设备、场地和监督是否已经确认? |
| 我怎样面对失败? | 最近一次实验或作业不顺利时,我怎样查找原因? |
| 参赛路径是否明确? | 有哪份当届通知能说明资格和时间? |
如果大部分答案还只是设想,可以先安排一段小规模的方法训练。例如读懂一篇基础论文,复现一个公开方法,或在适用审批与监督条件满足后练习一种测量。训练的目的,是了解自己是否喜欢这类工作,并估计真正研究会遇到的困难。
复现练习不应自动作为原创参赛成果提交。它能帮你掌握方法,之后还需要形成自己的问题和贡献。若训练本身涉及受限制的研究活动,也同样要遵守相应规则。
6.2 怎样寻找合适的指导者
好的指导关系首先需要匹配问题。熟悉统计的老师可能非常适合帮助数据分析项目,却未必能承担细胞实验的安全监督;大学研究者的学术方向与学生题目相近,也不等于有时间持续指导。
第一次沟通时,可以带一页问题说明,介绍已读资料、目前条件和希望获得的具体帮助。比如请对方判断实验是否能够区分两种解释,或请教数据是否适合某种分析。笼统请求“带我做一个能获奖的项目”,很难建立清楚的合作。
开始前最好约定见面频率、反馈方式、设备使用与数据权限,以及哪些工作必须由学生完成。若进入实验室,还应确认未成年人准入、培训、安全与审批安排。能在实验室拍一张照片,与获得持续、合适的研究条件是两件事。
指导者可以教方法、指出错误、讨论文献和提出问题。学生则应逐渐承担自己能力范围内的设计、执行、分析与表达。遇到超出能力的环节,可以学习或调整范围,不必把别人完成的部分藏起来。
对付费服务,家庭应关注服务内容是否明确:教授什么、反馈什么、如何记录支持,以及学生最终能否独立解释成果。2027 支持披露表要求说明付费支持。承诺获奖、代做实验、代写材料或替学生答辩,都不应成为购买理由。2027 支持披露与诚信要求
6.3 家长怎样支持,又不接管研究
家长能够提供的帮助很具体:安排交通、协调时间、确认预算、支持购买必要材料,或者在学生焦虑时陪他把困难说清楚。这些事情对项目能否持续很有价值。
讨论进度时,可以少问“什么时候能得出好结果”,多问“这周弄清了什么”“哪一个问题还卡着”。如果所有谈话都围绕获奖,学生可能更不愿意报告失败,也更容易把不确定结果包装得过于肯定。
家长也可以请学生用日常语言讲一次研究。听不懂就说:“这个词是什么意思?”或者“你怎么知道是这个原因?”不熟悉专业内容并不妨碍提问。学生如果能把这些问题解释清楚,也会更清楚自己哪里还没想明白。
当项目影响睡眠、基础课程或情绪时,需要重新调整投入。缩小范围、推迟一届,甚至暂时停止,都可能是合理选择。已经投入的费用和时间,不应成为继续扩大压力的唯一理由。
6.4 给研究留下可持续的时间
科研时间不只是实验室里的几个小时。阅读、准备、等待、整理数据和思考失败,也会占用时间。排计划时,最好把这些工作分别写出来。
对于刚开始的学生,可以先试行一个月:每周保留固定的阅读与记录时间,再安排能够连续工作的较长时段。一个月后,依据实际进展调整。不同年级和项目差异很大,没有人人适用的固定周小时数。
每次与导师见面前,准备一页进度:完成了什么,数据说明什么,最想讨论哪一个问题。会后由学生写下自己理解的下一步。如果学生只能等导师分配任务,说明自主判断还需要练习。
可以在项目中设置几个自然的停下来检查的时点。关键数据始终拿不到,说明题目可能需要改变;方法反复失败且原因不明,应先解决测量问题;结果与假设相反,则需要判断是否值得转向解释这种差异。计划应允许这些变化。
6.5 怎样做预算
本书不提供一个统一的“ISEF 项目价格”。公开数据研究、桌面工程和专业实验室研究的条件差异很大,是否已有学校资源也会改变实际支出。家庭应按自己的项目逐项询价。
| 费用类别 | 预算时容易漏掉的内容 |
|---|---|
| 数据与计算 | 数据授权、存储、云计算持续计费与备份 |
| 材料与制作 | 失败批次、备用零件、运输和必要工具 |
| 实验与测量 | 仪器预约、培训、样品检测、废物处理 |
| 指导与场地 | 服务范围、持续时间及是否另外收费 |
| 参赛与展示 | 当地注册、打印、包装、运输与替换材料 |
| 出行 | 证件、交通、住宿、保险和带队安排 |
先估算“完成核心问题需要什么”,再决定是否增加额外实验。可以保留一笔应对失败与重测的余量,但应写出触发条件,避免每次遇到困难都通过继续花钱解决。
每一笔较大的支出,都值得对应到一个具体问题:它能帮助测量什么,少了它会缺哪项证据?如果只能回答“这样看起来更专业”,先缓一缓。
6.6 怎样使用文献、数据与软件资源
学习资源宜从少到多。先找一份能建立概念的教材或综述,再读与问题最接近的原研究,最后决定需要什么工具。先安装一大堆软件,通常不能减少问题本身的不确定性。
| 资源 | 适合怎样使用 | 使用时留意什么 |
|---|---|---|
| ISEF 规则与 Rules Wizard | 初步判断规则和所需材料 | 工具提示不能代替项目审批 |
| ISEF 官方项目数据库 | 查找相近研究的问题与摘要 | 摘要不能提供所有实验细节 |
| PubMed | 检索生物医学与生命科学文献 | 检索记录不一定带有可访问全文 |
| Zotero 入门指南 | 管理已读文献、笔记和引用 | 自动抓取的信息仍要检查 |
| scikit-learn 常见错误说明 | 学习数据泄漏与预处理中的问题 | 会调用函数之前,也要理解评价设计 |
| 官方评审标准 | 检查问题、方法与解释是否清楚 | 不把评分项目机械改成论文标题 |
读文献时,可以只做简短笔记:文章回答了什么,用了什么证据,哪一个限制与自己的题目有关。摘抄很多段落却没有形成判断,之后写综述仍会困难。
下载数据前,应读数据说明和许可。确认每一行、每一列是什么,是否包含个人信息,是否允许当前用途,是否需要申请。公开可下载,不代表可以忽略使用条件或随意再分发。
使用软件时,保存版本和关键参数。调用现成工具完全可以是研究的一部分,但学生应理解工具输入、输出及其限制。若只知道“程序运行成功”,还无法判断结果是否正确。
6.7 一个项目卡住时,如何判断下一步
困难大致可以分成几种。第一种是知识不足:看不懂方法、不会测量或不能解释指标。这时需要补学和练习。第二种是资源不足:关键设备、材料或权限无法取得。这时要调整问题或寻找合适条件。第三种是研究结果本身不支持设想,需要检查方法,再考虑是否改变解释。
不要把所有困难都理解成“学生不够努力”。如果缺的是合法数据访问,再多写代码也不会解决;如果测量系统没有稳定,增加样本可能只是积累更多噪声。
讨论下一步时,可以问:“哪一项最小的检查,能帮助我们分清原因?”例如先用已知样本检查仪器,先在小数据上手工核对程序,或先回到原文确认方法的适用条件。这些检查通常比同时更换许多参数更容易带来进展。
如果最终要缩小题目,保留修改理由。研究中合理改变方向,并不是需要遮掩的失败。它可以体现学生怎样根据证据调整判断。
6.8 常见问题
没有大学实验室,可以做 ISEF 项目吗?
可以考虑适合学校、家庭安全条件或公开数据的研究,但能否开展某项具体活动仍取决于规则、监督与审批。设备条件会限制可做的题目,不必因此认为只能做没有深度的研究。
初中生可以先准备吗?
可以学习基础、阅读和研究方法。参加 ISEF 总决赛需要满足相应年级与年龄条件,早期研究是否能计入未来参赛工作还受到时间规定限制。不要把多年累积的所有实验一次性当作某一届的新成果。
一个项目必须有 AI 吗?
不需要。是否使用 AI 应由研究问题决定。若简单方法已经能回答问题,引入复杂模型只会增加需要解释和验证的内容。数学证明、物理测量、生态观察和工程实验都可以形成研究。
公开数据已经被别人研究过,还能用吗?
先确认许可和使用条件,再判断自己的问题是否有新增价值。换一个模型跑同一套常见指标,未必足够;检查一个有意义的边界、提出新的解释或验证已有结论,可能形成更清楚的问题。
研究一定要发表论文或申请专利吗?
ISEF 国际总则没有把发表论文或取得专利作为所有学生的参赛门槛。准备过程中,应优先保证研究、记录和材料质量。若考虑公开、投稿或知识产权安排,应与指导者及相关权利人提前讨论。
负结果还能参赛吗?
研究没有支持最初假设,不等于没有结果。应检查方法是否足以回答问题,并说明数据支持什么。不能为了让结果更好看而修改记录、删去不利数据或事后把探索发现写成预设假设。
英语不够流利,会不会完全没有机会?
英文摘要和展板属于明确要求,面谈也需要认真准备沟通。练习时先保证意思准确,再提高表达速度。实际是否提供及如何申请翻译支持,应向当年赛事确认,不把可能的支持当作不准备表达的理由。
个人项目和团队项目,哪种更好?
看研究任务是否需要合作,以及成员是否愿意共同承担工作。团队并非自动占优势。每名成员都应有实质贡献,并理解项目整体;如果只是为了分担演讲而组队,通常需要重新考虑。
可以借用开源代码或商用设备吗?
可以在许可、规则和披露要求允许的范围内使用。应说明现成部分与自己的贡献,检查代码或设备是否适合研究条件。使用已有工具与声称自己发明工具,是不同的表达。
老师能不能帮忙改论文?
老师可以教写作、指出逻辑和表达问题;研究及其陈述应反映学生的工作与理解。应记录实际支持。若使用 AI 修改,还应单独遵守第三章说明的官方限制与披露要求。
已经开始实验,才发现可能缺少审批,怎么办?
暂停相关活动,把实际时间、内容与现有记录如实交给成人指导者和赛事审查机构,由他们判断后续处理。不要补签虚假日期,也不要把已经完成的研究写成尚未开始。
选拔落选后,这项研究还有价值吗?
可以整理成自己的学习档案,检查哪些问题仍值得继续。若下一年参赛,要按延续研究、时间与当年资格要求重新规划。先看学生还想不想理解这个问题,再决定是否继续投入。
6.9 开始前的一次家庭与导师会谈
正式投入之前,可以安排一次不长的讨论,让学生先说。请他用几分钟解释问题和兴趣来源,再一起确认时间、资源、审批和参赛路径。最后写下近期要完成的一小步,例如读懂一项方法、确认数据权限或修改研究计划。
这次讨论不必解决整个赛季。它的作用是让几个人对接下来的工作有相近理解:学生希望学什么,成人提供什么帮助,哪些条件尚未确认,遇到困难时如何调整。
项目结束后,把原始记录、数据和报告好好保存。几个月后再打开,你也许会发现当时的解释不够周全,或者想到一个值得继续的问题。那时,能看懂自己究竟做过什么,会比只留下最后一张展板更有用。
6.10 常用名词对照
| 名词 | 中文理解 | 容易混淆的地方 |
|---|---|---|
| Affiliated Fair | 附属赛事 | 并非所有科学展都具有 ISEF 选拔资格 |
| Finalist | 总决赛入围者 | 入围本身与取得某项大奖不同 |
| Grand Award | 学科大奖体系中的奖项 | 不等于所有获奖者都是全场最高奖 |
| Special Award | 专项奖 | 由相关组织按其标准设置 |
| SRC | 科学审查委员会 | 与现场学术评委的任务不同 |
| IRB | 人体参与者研究审查委员会 | 研究者不能自行代替审查决定 |
| D&S | 展示与安全检查 | 研究获批后,现场展示仍需符合要求 |
| Adult Sponsor | 成人指导者 | 负责帮助理解规则和支持适当研究 |
| Qualified Scientist | 合格科学家 | 是否需要由研究内容与规则决定 |
| Continuation Project | 延续研究 | 应说明本年度实质新增的工作 |
| Baseline | 基线方法或比较标准 | 应是公平、合理的对照,而非故意选弱方案 |
| Data Leakage | 数据泄漏 | 测试信息进入训练或方法选择,导致表现被高估 |
本书核查日期为 2026 年 9 月 22 日。之后准备报名、开始受审批约束的研究或提交材料时,请再查看当届官方文件及所在附属赛事通知。
第七章 从历届数据认识 ISEF
7.1 这批数据能回答什么
当学生问“哪个方向更容易做出好项目”时,历届作品很有帮助。它们告诉我们已经有人研究过什么,常用什么方法,以及同一个问题可以怎样被拆分。但若把问题换成“我报哪个类别最容易获奖”,同一批数据就很容易被误用。
本章依据我们整理的 Society for Science 官方摘要档案,共 17,565 个唯一项目记录,覆盖 2014—2026 年。其中 2022—2026 年有 6,755 个项目,适合观察近期学科与地区构成。数据快照来自 2026 年 8 月的档案整理,本书在 2026 年 9 月复核来源、分类和统计口径。官方摘要数据库
我们拿到的是公开项目档案,其中没有全部地方赛报名者和未晋级项目,也没有评委原始评分或完整研究日志。因此,这些记录能说明决赛项目的构成;至于一名普通学生怎样晋级、评委为何给出某个分数,需要另外的资料。
一个团队项目只算一个项目。学生人次是另一个单位:同一个人跨年参赛可能重复出现,一队也可能有多名成员。一个项目获得多个奖,仍然只在“获奖项目数”中计一次。阅读数据时,先弄清这些单位,比记住某个百分比更重要。
本章附有可下载的汇总表:年度数据、学科数据、国家地区数据。表中的数值由同一份规范化记录生成,不是从不同报告手工拼接。
7.2 十三年的记录,为什么不能连成一条简单的获奖率曲线
| 年份 | 项目档案 | 学科大奖项目 | 说明 |
|---|---|---|---|
| 2014 | 1394 | 335 | 公开档案中可识别的学科大奖 |
| 2015 | 1347 | 276 | 公开档案中可识别的学科大奖 |
| 2016 | 1371 | 293 | 公开档案中可识别的学科大奖 |
| 2017 | 1403 | 369 | 公开档案中可识别的学科大奖 |
| 2018 | 1390 | 341 | 公开档案中可识别的学科大奖 |
| 2019 | 1426 | 351 | 公开档案中可识别的学科大奖 |
| 2020 | 1027 | NA | 比赛取消;保留档案记录 |
| 2021 | 1452 | 373 | 公开档案中可识别的学科大奖 |
| 2022 | 1400 | 372 | 公开档案中可识别的学科大奖 |
| 2023 | 1316 | 364 | 公开档案中可识别的学科大奖 |
| 2024 | 1345 | 365 | 公开档案中可识别的学科大奖 |
| 2025 | 1328 | 367 | 大奖以官方名单补充;专项奖缺失 |
| 2026 | 1366 | 366 | 公开档案中可识别的学科大奖 |
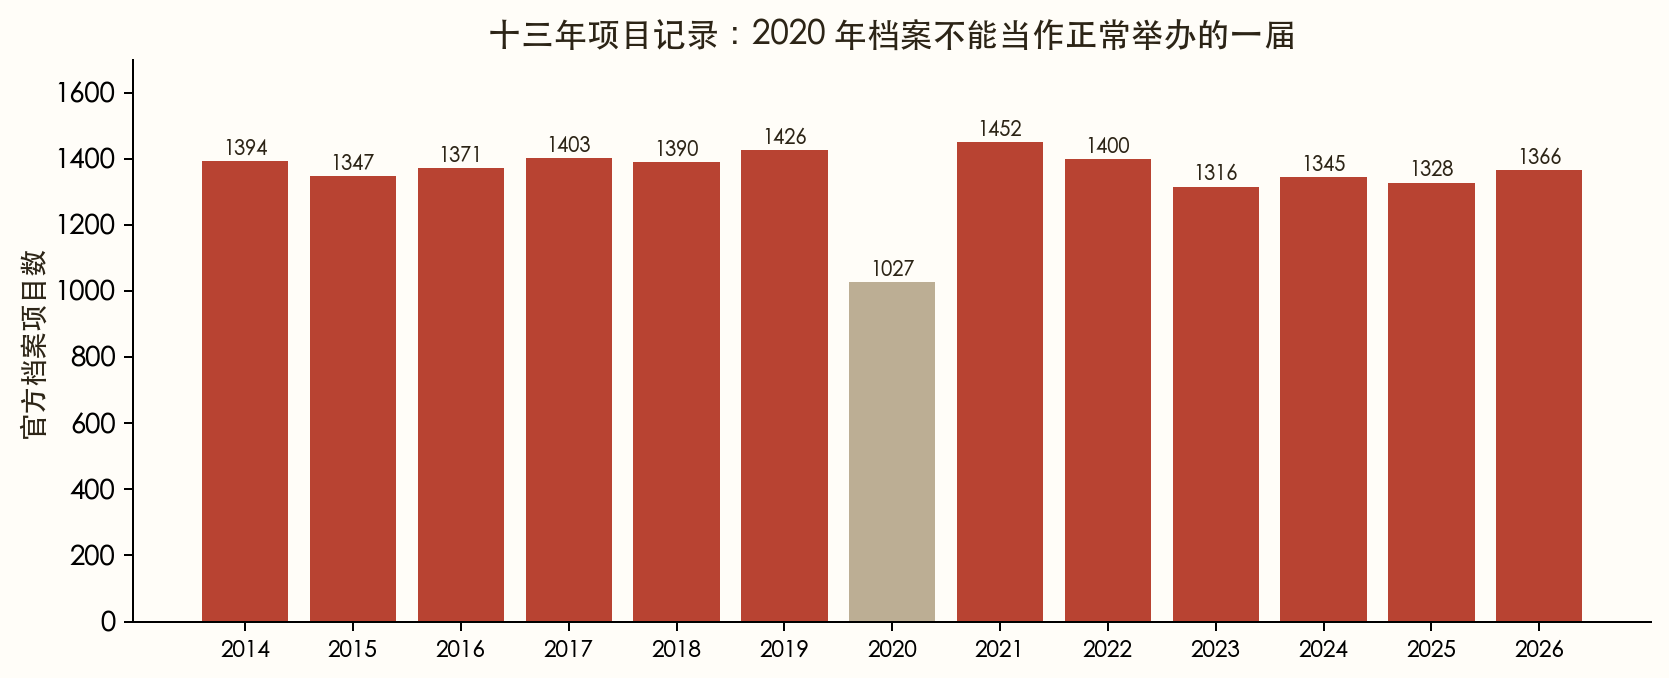
图中的数量是档案记录,不是每届新闻报道中的学生人数。2020 年比赛取消,但数据库仍保留相关项目记录,所以本书保留这一年的研究文本,同时将获奖分析标为不适用。把这一年写成“获奖率为零”,会错误地暗示项目经过正常评审却无人得奖。2020 年取消比赛的官方说明
2025 年是另一种情况。官方摘要库中的奖项字段不足以直接恢复当年完整结果,我们使用已匹配的官方公布名单补充学科大奖。专项奖的来源缺口仍在,因此不能把 2025 年专项奖空值写成确实没有获奖,也不宜用“任何奖项”的比例与其他年份直接比较。
早年专项奖记录较少,也可能部分反映来源覆盖差异。若看到某几年“任何奖项”突然增加,先检查采集与分类方式,再讨论比赛变化。本书因此把时间趋势主要放在项目规模和文本内容上,避免用一条混合奖项曲线讲述未经证实的竞争故事。
自己的数据表出现空白时,也应注明是没有发生、没有测量,还是测量失败。三个空白的含义不同,后续分析也不同。
7.3 先分清学科大奖与专项奖
学科大奖与机构颁发的专项奖承担不同的评价任务。本书统计“学科大奖项目”时,识别官方类别评审的一至四等奖及历史类别最佳奖记录,并使用 2025 年官方名单补充;同一项目不因获得多个层级的奖而重复计数。这个口径不把机构奖项中的 “First Award” 自动归为学科一等奖。
复核旧报告时,我们发现过一个会改变结论的分类错误。部分旧地区分析使用奖项名称中的词语搜索,误把类似“某机构:First Award”算入学科大奖。我们逐条对照后发现,2022—2026 年有 179 个项目在这种旧分类下被计入,却没有被规范化的学科大奖规则识别。因此,本章与那些旧报告的比例可能不同,不应继续混用。
另一个区别是 2025 年:旧地区报告为了回避奖项缺失,剔除了整年;本章的五年学科大奖表采用补充后的记录,将其纳入分母。分类规则与时间窗都改变了,只对比两个百分比的高低会让人误解为比赛结果发生变化。分类差异核对表
按这里的规则,2022—2026 年观察到 1,834 个学科大奖项目,占 6,755 个档案项目约 27.2%。这是这批决赛记录中的观察比例。这个分母不包含所有地方赛报名者,因此不能用来预测一名新学生从报名到获奖的机会。
7.4 22 个学科的规模与变化
| 代码 | 学科 | 2022 | 2023 | 2024 | 2025 | 2026 | 合计 |
|---|---|---|---|---|---|---|---|
| ANIM | 动物科学 | 75 | 55 | 51 | 53 | 54 | 288 |
| BCHM | 生物化学 | 41 | 37 | 38 | 37 | 44 | 197 |
| BEHA | 行为与社会科学 | 72 | 58 | 58 | 73 | 57 | 318 |
| BMED | 生物医学与健康科学 | 84 | 65 | 91 | 87 | 69 | 396 |
| CBIO | 计算生物学与生物信息学 | 75 | 67 | 57 | 77 | 92 | 368 |
| CELL | 细胞与分子生物学 | 41 | 57 | 47 | 50 | 43 | 238 |
| CHEM | 化学 | 73 | 65 | 70 | 46 | 67 | 321 |
| EAEV | 地球与环境科学 | 90 | 82 | 99 | 69 | 69 | 409 |
| EBED | 嵌入式系统 | 41 | 43 | 41 | 43 | 49 | 217 |
| EGSD | 能源:可持续材料与设计 | 52 | 60 | 50 | 48 | 51 | 261 |
| ENBM | 生物医学工程 | 81 | 83 | 82 | 82 | 98 | 426 |
| ENEV | 环境工程 | 98 | 86 | 81 | 78 | 88 | 431 |
| ETSD | 工程技术:静力学与动力学 | 82 | 69 | 75 | 56 | 55 | 337 |
| MATH | 数学 | 39 | 42 | 37 | 41 | 39 | 198 |
| MATS | 材料科学 | 55 | 56 | 54 | 67 | 82 | 314 |
| MCRO | 微生物学 | 63 | 65 | 41 | 58 | 44 | 271 |
| PHYS | 物理与天文学 | 74 | 66 | 69 | 75 | 81 | 365 |
| PLNT | 植物科学 | 54 | 57 | 66 | 55 | 50 | 282 |
| ROBO | 机器人与智能机器 | 85 | 76 | 82 | 69 | 61 | 373 |
| SFTD | 软件设计 | 59 | 47 | 54 | 58 | 61 | 279 |
| TECA | 技术增强艺术 | — | — | 21 | 20 | 20 | 61 |
| TMED | 转化医学 | 66 | 80 | 81 | 86 | 92 | 405 |
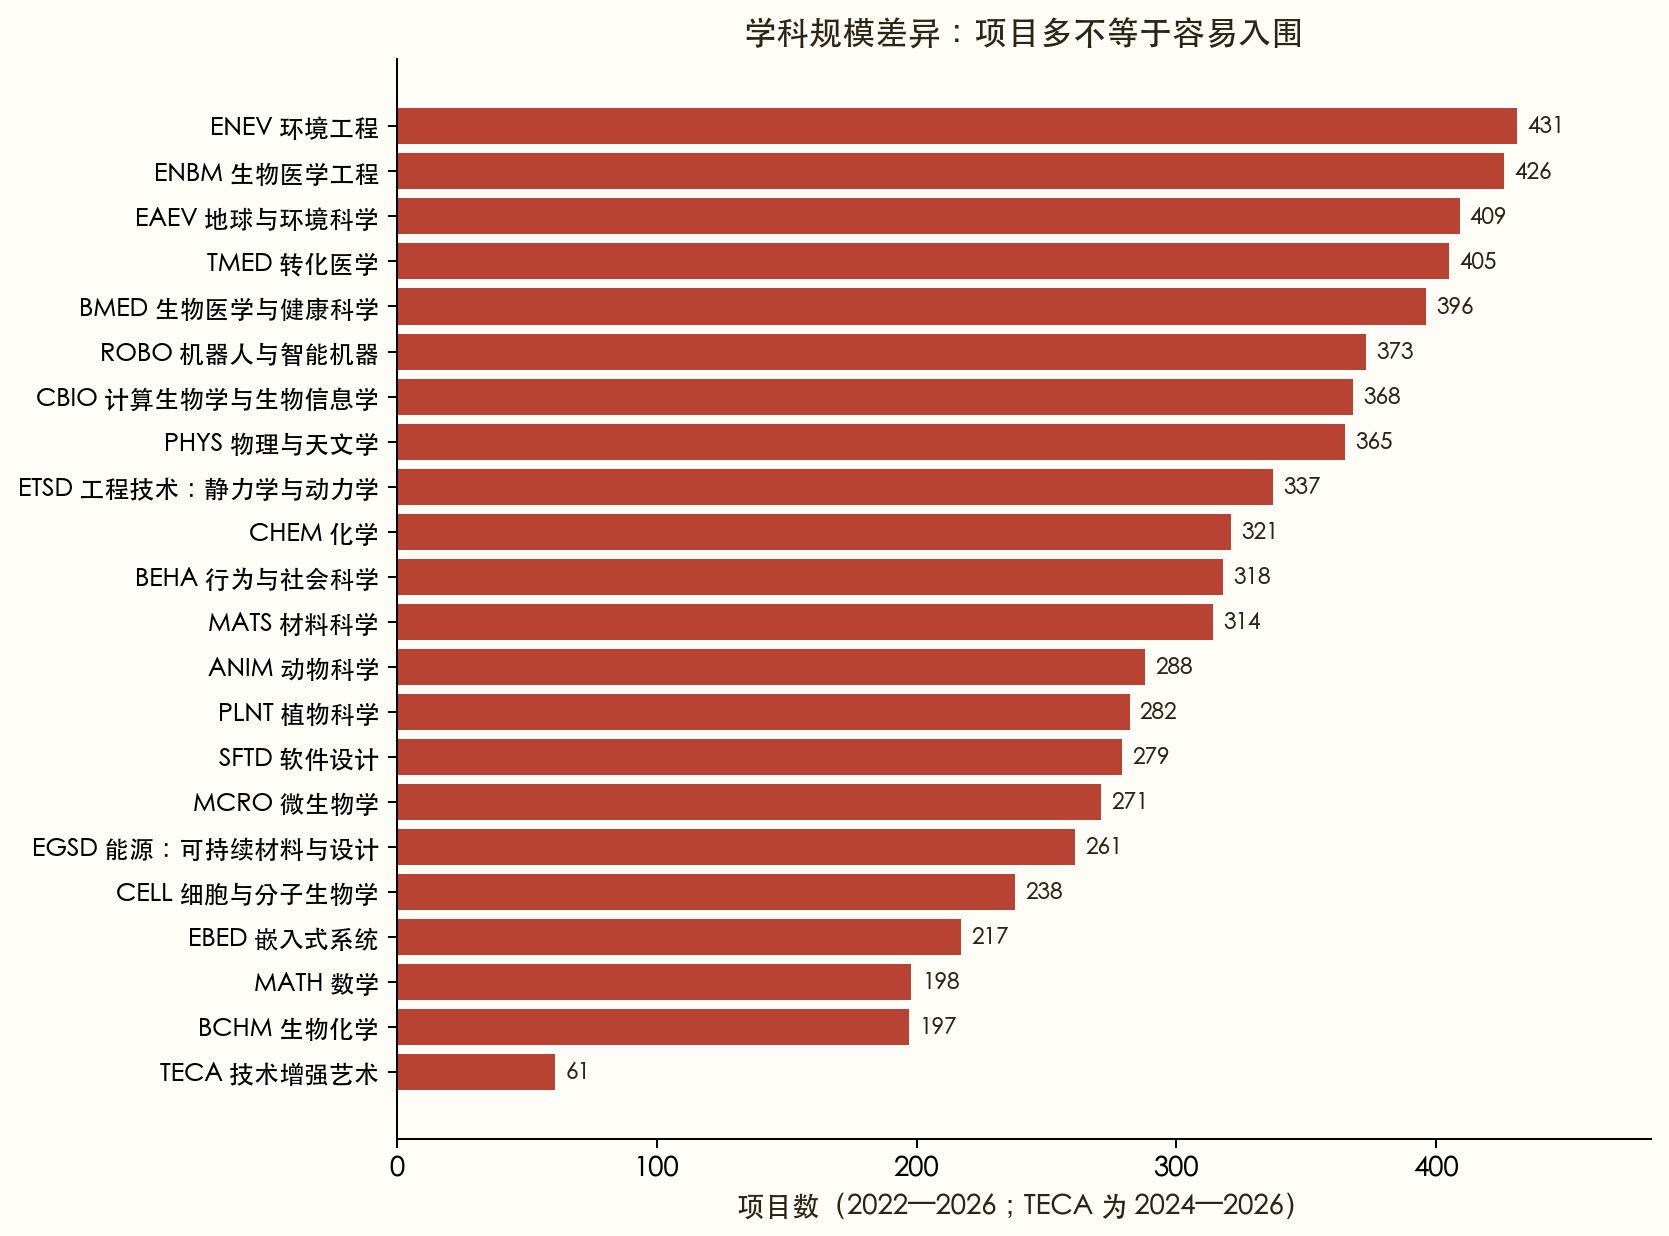
近五年中,环境工程有 431 个项目,生物医学工程有 426 个,地球与环境科学有 409 个,转化医学有 405 个。它们为读者提供了丰富的案例池,但项目多并不自动意味着更容易入围。地方选拔、学校资源、研究兴趣和类别设置都可能影响数量。
计算生物学与生物信息学从 2022 年的 75 个项目到 2026 年的 92 个,材料科学从 55 个到 82 个,生物医学工程从 81 个到 98 个。这些是首尾年份的观察,不代表每年持续增长。例如 CBIO 中间出现过下降,所以不宜把五个年份压缩成一句“赛道一路上升”。
TECA 自 2024 年作为独立类别出现,在本数据窗口中共 61 个项目。它不能与其他类别的完整五年总数直接竞争名次;前两年的横线表示当时没有这个独立类别,并非艺术与技术结合的研究不存在。
读者可能会注意到,规范分类后的近五年学科大奖比例大多接近。仅凭几个百分点的差异挑选类别,没有足够依据。更合理的用途是按研究问题寻找最近的作品,再判断哪些验证你有条件完成。第二章已将这些类别与具体子类别、真实案例对应起来。
同一研究还可能在不同年份、不同赛事中登记到不同的大类。旧代码 SOFT 与新代码 SFTD 在本章合并,2014—2016 年的历史标签则结合展位代码规范化。若研究跨度很长,应先做分类核对,不能直接把数据库今天显示的标签当成当年完整的分类制度。
7.5 方法变化:计算越来越常见,工程迭代并没有消失
我们此前对标题与摘要进行了方法关键词识别。下面比较 2014—2019 年的 8,331 个项目和 2024—2026 年的 4,039 个项目。每个项目可以命中多个方法,因此比例相加可能超过 100%;两个时间窗按各自项目数计算比例,没有把六年的数量直接与三年数量相比。
| 摘要文字信号 | 2014—2019 | 2024—2026 | 变化/百分点 |
|---|---|---|---|
| 原型与工程迭代 | 25.81% | 25.72% | -0.08 |
| 材料合成与表征 | 15.11% | 17.26% | +2.14 |
| 人体参与者研究 | 12.39% | 16.27% | +3.88 |
| 机器学习/人工智能 | 6.07% | 20.30% | +14.23 |
| 计算建模与仿真 | 6.04% | 11.93% | +5.90 |
| 湿实验与分子生物学 | 7.87% | 7.70% | -0.17 |
| 受控实验 | 4.73% | 5.20% | +0.47 |
| 数学理论与证明 | 4.43% | 4.53% | +0.10 |
| 观察性/历史数据研究 | 3.54% | 5.32% | +1.78 |
| 现场/环境采样 | 4.00% | 3.94% | -0.06 |
| 问卷与行为实验 | 3.49% | 3.69% | +0.20 |
| 公开数据/数据挖掘 | 0.40% | 0.89% | +0.50 |
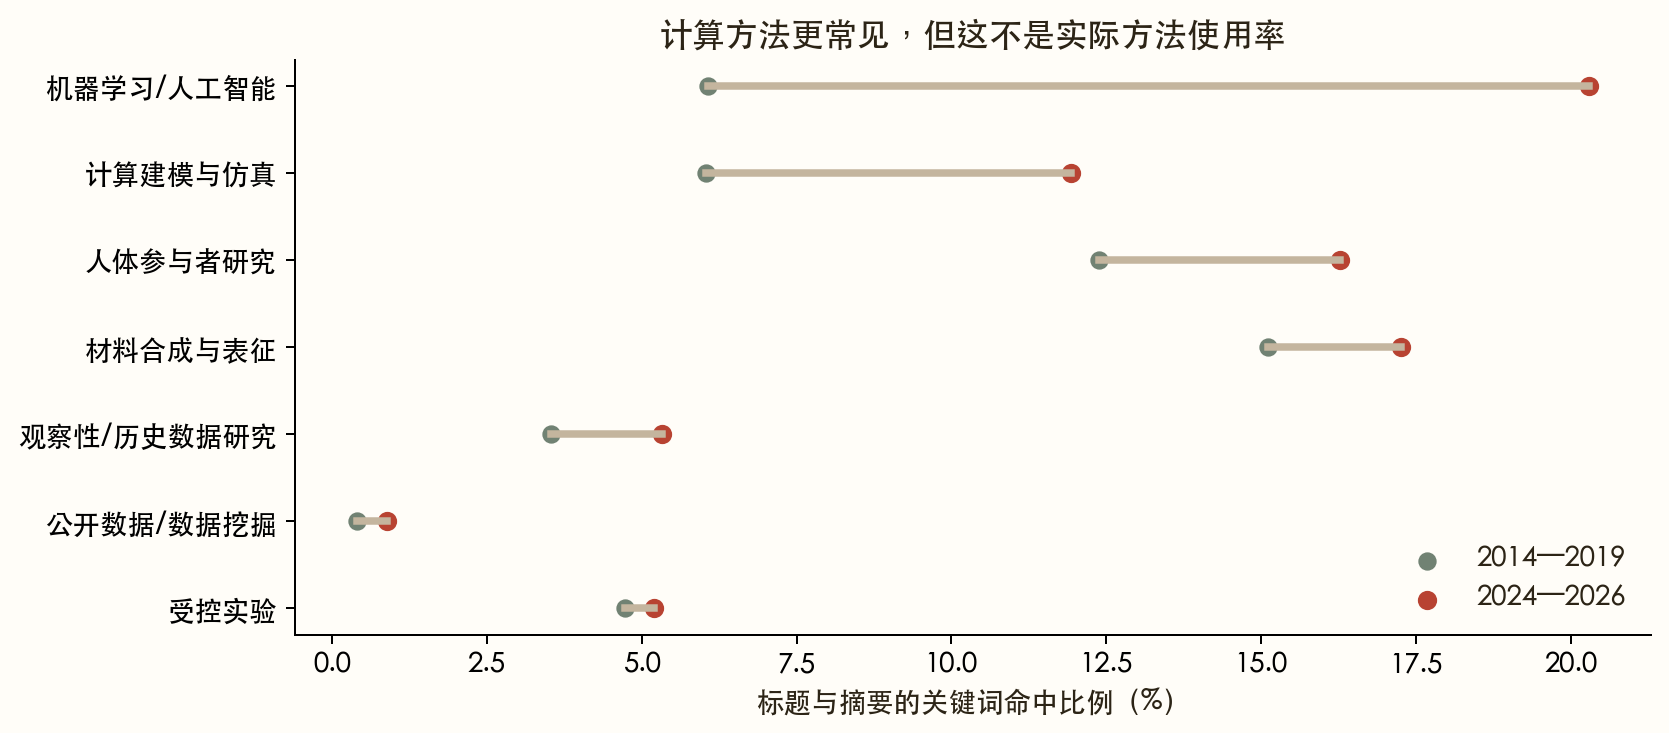
最明显的变化是机器学习/人工智能相关措辞,从约 6.1% 增至 20.3%;计算建模与仿真从约 6.0% 增至 11.9%。这说明相关方法在摘要中更常见,也意味着仅凭“采用 AI”很难解释一个题目的独特之处。
与此同时,原型与工程迭代的命中比例约为 25.8% 和 25.7%,基本接近。这些记录里既有更多计算工具,也仍有大量围绕实物测量和反复改进展开的工作。不能据此宣布所有传统实验都被替代。
这些数字是文本识别结果,不是逐篇专家审核后的真实方法使用率。比如使用公开数据的项目未必在摘要里写出“公开数据”,因此 0.89% 不能被解读为只有这么少的学生使用开放资源。相反,某个词可能只出现在背景介绍里,也可能被误识别成实际方法。
如果你的项目采用机器学习,先回答它解决了哪个已有方法处理不好的问题。若只是把一个小表格送进复杂模型,应先比较简单基线;若简单方法同样有效,承认它通常比继续堆模型更有价值。
如果你更擅长动手,可以从测量可靠性、性能取舍和失效条件入手。第二章的回收线材设备、模块机器人和再生吸水片材,都说明一个工程项目的研究内容可以来自具体、可重复的比较。
7.6 技术趋势告诉我们应该学什么,而不是应该买什么
技术识别中,计算机视觉相关文字在基准期约占 1.55%,近期约占 7.08%;测序与组学从约 1.12% 到 3.64%;遥感与 GIS 从约 0.38% 到 1.39%。于是,读生物或环境项目时,也常常需要理解图像、数据和模型。下载技术信号汇总表
对学生,这些数据最值得转化成学习任务。例如计算机视觉需要懂得标注、误差和测试划分;组学分析需要处理批次和样本来源;遥感分析需要理解空间分辨率、云和地面参照。学会使用工具并不等于掌握这些判断。
旧技术表里还有 Transformer/LLM 一项,但不能直接拿来画“大模型进入 ISEF”的历史曲线。早年 transformer 可能指电力变压器,宽泛关键词还可能产生其他误命中。未经逐项语义核查,本书不将这一项解释为大语言模型项目数量。
同样,某种昂贵技术与获奖出现关联,不能证明购买该设备就会增加获奖机会。决定是否使用一项技术之前,先写出你需要测的量。现有办法差在哪里,新技术能否解决,得到结果后自己是否解释得清楚?没有这些条件,设备越复杂,学生与研究之间的距离可能越大。
7.7 摘要越来越常写指标,但数字不等于验证充分
| 摘要文字信号 | 2014—2019 | 2024—2026 | 变化/百分点 |
|---|---|---|---|
| 对照/比较基线 | 17.39% | 22.23% | +4.84 |
| 显著性/p 值 | 7.93% | 12.82% | +4.89 |
| 分类性能指标 | 4.85% | 13.57% | +8.72 |
| 明确样本量 | 3.48% | 6.24% | +2.76 |
| 重复实验/多次试验 | 1.96% | 3.12% | +1.16 |
| 回归误差指标 | 0.29% | 1.39% | +1.10 |
| 随机化 | 0.54% | 0.67% | +0.13 |
| 留出集/交叉验证 | 0.28% | 1.04% | +0.76 |
| 置信区间/不确定性 | 0.40% | 0.52% | +0.12 |
| 盲法 | 0.10% | 0.17% | +0.08 |
| 外部/独立验证 | 0.00% | 0.30% | +0.30 |
分类指标、对照基线和样本量等措辞在近期摘要中更常见。这有助于读者找到结果的依据,也反映出计算和数据类项目在表达方式上的影响。但本表不能当作逐项研究质量评分。
例如,“外部/独立验证”近期命中约 0.30%,并不说明其他 99.70% 的项目都没有做过外部验证。摘要篇幅有限,表达方式多样,关键词检索也可能漏掉换一种说法的项目。同理,写了 p 值不保证设计合理,写了交叉验证也不保证没有数据泄漏。
对于自己的项目,可以把这些文字线索转成真正的检查问题:基线是否公平?样本到底是人、图像、细胞还是实验批次?测试数据是否在调参时被反复查看?多个指标中,哪一个在实验前就确定为主要终点?
一个常见例子是同一人的视频被切成许多片段。若随机将片段分到训练和测试中,模型可能在两边都见过这个人,结果很高却不代表能处理新参与者。需要按独立对象划分数据,而不是只在程序里调用一个“随机分割”函数。
另一个例子是材料实验。来自同一批制备的十块试样,可以反映该批次内部差异,却不能完整说明换一批原料后是否重复。研究记录应保留层级关系,避免把重复测量全部当成独立样本。
7.8 36 个主题簇:用来找邻居,不是新的官方分类
在此前的分析中,我们把标题和摘要转为词语特征,再用非负矩阵分解(NMF)整理成 36 个主题簇。可以把它理解成一种按词语共现习惯整理书架的方法:经常一起出现的词,形成一个便于查阅的区域。
它与官方类别不同。一个“蛋白、结合与药物”的簇可能同时包含 BCHM、CBIO 和 TMED;一个机器人相关簇也可能跨越 EBED、ROBO 和 ETSD。模型为每个项目选择权重最高的簇作为主要位置,并不表示项目只有一个研究主题。
| 主题簇的便于阅读的名称 | 2014—2019 | 2024—2026 |
|---|---|---|
| 检测、早期诊断与患者 | 2.65% | 5.60% |
| 机器学习与模型准确率 | 2.05% | 4.73% |
| 神经网络与图像 | 1.26% | 3.71% |
| 机器人与实时系统 | 2.17% | 4.46% |
| 蛋白、结合与药物 | 1.49% | 3.71% |
| 脑、脑电与认知 | 2.78% | 4.43% |
| 物种、种群与环境 | 4.14% | 5.32% |
| 阿尔茨海默病相关 | 1.25% | 2.15% |
| 塑料、废弃物与可降解材料 | 2.35% | 3.22% |
表中选取的是相对基准期增加较明显的主题,不是按研究质量或获奖前景排序。中文名称是对关键词的便于阅读的概括,也不是官方认可的新学科。例如“检测、早期诊断与患者”既可能包含影像算法,也可能包含实验检测方法,需要继续查看原始项目。
这一整理方式特别适合跨学科选题。你如果只在 ENBM 中查智能鞋垫,可能漏掉 BEHA 中的步态研究或 ROBO 中的运动识别。按主题先找一批相关作品,再按问题、方法和验证方式细分,比只按报名大类搜索更充分。
主题模型也会受词表和参数影响。我们使用 36 个成分、固定随机种子和最多 18,000 个词语特征生成已有分析;换成另一种设置,部分项目的位置可能改变。因此,不应将簇边界理解为研究领域的天然边界。
7.9 世界地图:先看到选拔系统,再看获奖比例
2022—2026 年的 6,755 个项目来自 77 个附属赛事所在国家或地区。美国记录为 4,558 个,约占 67.5%;中国大陆、香港、澳门与台湾合计 254 个,约占 3.8%。这里的地点字段是赛事所在地,不是学生国籍,也不必然等于长期居住地。
下面列出部分地区,统一使用五年窗口和修正后的学科大奖口径。区间采用 Wilson 方法,显示小样本比例的不稳定程度;它不是未来获奖概率的预测区间,也不能消除选拔与来源偏差。
| 赛事所在地 | 项目数 | 学科大奖项目 | 观察比例 | 95% 区间 |
|---|---|---|---|---|
| 中国大陆 | 142 | 50 | 35.2% | 27.8%—43.4% |
| 中国台湾 | 60 | 22 | 36.7% | 25.6%—49.3% |
| 中国香港 | 23 | 6 | 26.1% | 12.5%—46.5% |
| 中国澳门 | 29 | 7 | 24.1% | 12.2%—42.1% |
| 美国 | 4558 | 1275 | 28.0% | 26.7%—29.3% |
| 泰国 | 73 | 38 | 52.1% | 40.8%—63.1% |
| 加拿大 | 70 | 35 | 50.0% | 38.6%—61.4% |
| 沙特阿拉伯 | 185 | 82 | 44.3% | 37.4%—51.5% |
| 新加坡 | 30 | 20 | 66.7% | 48.8%—80.8% |
| 韩国 | 130 | 26 | 20.0% | 14.0%—27.7% |
| 日本 | 76 | 19 | 25.0% | 16.6%—35.8% |
| 印度 | 99 | 32 | 32.3% | 23.9%—42.0% |
| 巴西 | 89 | 15 | 16.9% | 10.5%—26.0% |
| 波多黎各 | 159 | 8 | 5.0% | 2.6%—9.6% |
| 埃及 | 74 | 17 | 23.0% | 14.9%—33.7% |
新加坡这批记录中有 20/30 个项目获学科大奖,观察比例约 66.7%,但区间很宽,约为 48.8%—80.8%。不能据此说当地普通学生有三分之二的机会在 ISEF 获奖。我们看到的是已经经过当地选拔的少量项目,不是所有有科研兴趣的学生。
美国记录的分母大得多,国家地区间的参赛结构也不同。项目构成、选拔层级、指导资源和年份组合都可能影响比例。没有申请者基础资料,无法分离这些因素,更不能把表格当成科研教育质量的排行榜。
专项奖还可能有独立的评价目标和资格条件,需要逐个奖项查官方说明。名称出现 University、NASA 或 Scholarship 等词语,不能据此断言国际学生没有资格。旧报告中的关键词标记只够支持进一步检查,本书不把它当成资格事实。
7.10 中国相关记录:年际变化比一个平均数更值得注意
| 赛事所在地 | 2022 | 2023 | 2024 | 2025 | 2026 | 合计 |
|---|---|---|---|---|---|---|
| 中国大陆 | 44 | 31 | 35 | 5 | 27 | 142 |
| 中国台湾 | 12 | 12 | 12 | 12 | 12 | 60 |
| 中国香港 | 5 | 5 | 4 | 4 | 5 | 23 |
| 中国澳门 | 6 | 6 | 6 | 5 | 6 | 29 |
中国大陆的档案数从 2022 年的 44 个,到 2025 年的 5 个,再到 2026 年的 27 个,变化很大。单靠档案不能确定原因是提名安排、参与渠道、政策、记录覆盖还是其他因素。我们只报告观察,不用“科研水平上升或下降”解释这些数字。
五年合计的大陆记录有 50/142 个被识别为学科大奖项目,约 35.2%。这个比例与过去某些地区报告不同,原因包括专项奖误分类的修正和 2025 年分母的处理。读者如果同时查阅网站旧图表,应优先确认口径,不应选择其中更好看的数字用于宣传。
对家庭更有帮助的是把地区记录转成具体行动:你的学籍与所在地对应哪一个选拔路径?学校是否掌握当年通知?项目需要何时完成预审?既有案例不能替代资格确认,往届某校有项目也不表示今年自动存在同样通道。
我们此前也整理过学校与城市分布,但不在此发布“学校培养能力排名”。学校名称可能存在不同写法,部分记录不完整,一所学校的少量获奖更不能证明每位学生能获得同样支持。若要了解一所学校的研究条件,应查看导师、设施、时间安排与学生实际分工。
7.11 美国各州和附属赛事:一张地图里有多个层级
此前的美国赛区研究从 2023 年官方项目资料中整理出 283 个美国附属赛事条目及合计 898 个历史名额,中位数为每个赛事两个。这个结果描述的是当年的目录与名额,不是 2027 年可直接使用的报名表。官方附属赛事目录是核对当前路径的起点。附属赛事说明
有的州有多个地区赛事,再与州级赛事形成衔接;有的地方路径不同。赛事代码中的数字曾被用于辅助判断层级,但代码推断不能代替官方赛事规则。不要看到某州项目多,就认为只要搬到那里便更容易参赛。
在既有五年项目统计中,佛罗里达、纽约、得克萨斯和加利福尼亚等州贡献了较多记录。它们同时拥有不同规模的学生群体和赛事网络。没有地方报名人数、晋级路线与名额制度的统一资料,不能把项目数量换算为当地学生的晋级优势。
对于在美国就读的学生,最有用的一张表应列出自己可参加的赛事、覆盖学校或区域、资格条件、截止日期,以及是否要求先通过另一级比赛。这张个人路线表,比一张各州获奖排名更能帮助安排本学年的工作。第四章介绍了核对路径的方法。
7.12 获奖关联为什么不能当作选题公式
此前分析计算过“按年份与学科调整后的获奖关联”。做法是先看一个方法相关的项目出现在什么年份和学科,再依据各组的基础比例估计一个预期获奖数,最后与实际观察数相比。这样可以减少不同年份、类别混在一起造成的一部分影响。
即使经过调整,这仍然不是实验。更成熟的项目可能既有条件使用某种技术,也更容易获奖;导师资源、研究时长和学生基础可能同时影响两者。没有这些资料,无法把技术本身的作用单独分出来。
因此,本书不列“使用某方法可提高多少获奖率”的操作指南。那些关联更适合用来提出后续阅读问题:为什么这类项目容易展示出清楚的比较?是否因为它们有更明确的基线或终点?继续读原始作品,往往比停在一个比值上有收获。
对自己的选题,可以换成三个实际问题:我能否得到足够可靠的数据?我是否理解主要方法?在已有条件下,能否完成一个别人可以检查的比较?这些问题没有历史获奖率那么醒目,却直接影响你能否完成研究。
7.13 题目相似、持续研究与创新性
在已有标题相似度分析中,16,171 个可比较项目里,若使用 0.62 的相似度阈值,会得到 918 个待检查记录;阈值提高到 0.90,剩 151 个。阈值改变,名单就明显变化。这说明相似度更适合做阅读索引,而不是直接贴上“重复”标签。
相似标题可能来自同一问题的新方法、持续研究的下一阶段,也可能只是共享常见术语。标题完全不同的两个项目反而可能采用相同方案。没有阅读全文、比较方法和验证内容,不应指控抄袭,也不能据低相似度宣布原创。
智能鞋垫方向的既有检索找到 16 个直接标题近邻,覆盖七届;更宽的步态、跌倒与相关健康主题有 234 个。ACL 方向有四个直接标题近邻,宽主题为五十个。直接近邻与宽主题不能相加,它们对应不同范围,且可能互相包含。
这些数字的用途是决定下一步阅读。鞋垫方向显然不能只靠“加上传感器”说明新意;ACL 近邻较少,也不代表相关学术论文或临床产品很少。第八章将用这两个方向展示如何比较先例并缩小题目。
7.14 把数据读成自己的下一步
如果你还没有题目,先从第二章找两个真正有兴趣的学科,读各自的案例,再用本章了解相关方法是否常见。常见不意味着不能做,它意味着需要更清楚地说明自己改变了什么条件、解决了哪个限制。
如果你已经有题目,检索时不要只搜题目里的中文名称。把研究对象、测量手段、应用场景分别换成英文近义词,再查看不同类别的作品。记录最相近的几项工作,用同一组问题比较它们:输入是什么,输出是什么,基线是什么,测试在哪里进行。
如果你已经得到结果,数据分析最重要的用途是帮助限定结论。你的测试人群、样本批次或环境能覆盖多大范围?当条件改变时,方法可能在哪里失效?能把这些问题讲清楚,比引用某个学科的历史获奖比例更能让读者信任你的工作。
第八章 把方向变成可以完成的研究
8.1 题目不必一开始就很大
“我想做医疗 AI。”“我想研究环保。”“我想做一个帮助老人的设备。”这些都是合理的兴趣,但还不是可以安排实验的研究问题。它们没有告诉我们要测什么、与什么比较、在什么条件下算成功。
我们之前整理过分学科题库、历届近邻项目和若干方向的深入分析。本章把其中适合学生理解的部分重新组织成选题推演。它们是研究设计示例,不是已经替你完成的原创性认证,也不是可以直接提交的研究计划。自己的问题、条件、预期分析和研究文本,仍应由学生理解并完成。
从方向走向问题,通常要经历一次收缩。比如“帮助老人”可以缩为“测量步态变化”,再缩为“换一双鞋后,传感器还能否给出可比较的步态参数”。每缩小一次,研究少承诺一点,却更接近能够验证的内容。
这并不意味着只能做简单题。一个表面很小的问题可能涉及困难的测量、模型或理论。读者需要看得清楚:你观察的对象是什么,哪些解释经过检验,结论到了哪里就应停下。
8.2 查近邻作品,要比较到哪一层
查新时只读标题,很容易出现两种误判:见到相同关键词就认定“别人已经做完了”;没有搜到相同句子就宣布“从来没人研究过”。更有用的办法,是把相关作品放进同一张比较表。
| 比较内容 | 要记录的具体信息 | 为什么重要 |
|---|---|---|
| 研究对象 | 什么人群、材料、设备、环境或数学对象 | 同一方法换对象可能有意义,也可能只是换数据 |
| 主要问题 | 想解释、预测、测量还是改进什么 | 防止把背景主题误当研究贡献 |
| 输入与来源 | 数据、样本、仪器和获得方式 | 判断自己有没有相应条件 |
| 比较基线 | 与原方法、简单模型还是空白处理比较 | 没有公平基线,很难判断改进 |
| 测试范围 | 新对象、新日期、新地点或独立批次 | 判断结论能否离开原始样本 |
| 已知限制 | 作者承认了什么,摘要没说明什么 | 寻找值得继续研究的问题 |
表格可以从三到五个最相关的项目开始,不必一口气收集上百条标题。随后再加入学术论文与现实中的产品或流程。ISEF 数据库说明其他学生做过什么,专业文献说明更广泛的研究进展,两者不能互相替代。
记录“摘要未说明”与“作者没有做”也要分开。短摘要常省略细节。如果某个判断决定题目是否值得继续,应该寻找全文、公开补充材料或其他可靠资料,不能凭空白替别人下结论。
8.3 智能鞋垫:把设备题改成测量题
此前的检索在十三年档案中找到 16 个直接标题近邻,涉及七届比赛。它们包括智能鞋、足底压力、步态分析及相关疾病场景。更宽的步态主题有 234 个项目。因此,“把压力传感器放进鞋垫,再做一个手机界面”很难单独说明贡献。
例如,2022 年的 Smart Sole 已以可获得的步态分析为目标,2025 年已有低成本、多传感或无标记的三维步态测量相关作品,2026 年还有新的智能鞋垫记录。它们提供的是需要继续比较的先例,而不是阻止学生研究的清单。2022 Smart Sole 摘要、2025 步态测量项目摘要、2026 智能鞋垫项目摘要
先问输出是否真的是你以为的物理量
传感器给出的原始电压或数字值,不会自动变成足底压力。接触面积、安装位置、鞋垫变形和传感器本身的响应,都可能影响读数。若这些条件变化,屏幕上的曲线仍可能十分平滑,却已经无法与前一天比较。
因此,一个具体问题可以是:同一套测量方法在换鞋、重新安装或不同日期后,误差怎样变化?研究的主要结果是可重复性与条件变化带来的误差,而不是疾病诊断。
起步时可以先在安全台架上验证传感器响应,再决定是否确实需要人的数据。台架只能回答台架问题,不能替代步态验证;但它可以先排除电路、安装和重复测量中的明显问题。若系统在静态条件下都不稳定,直接招募更多参与者并不会修复它。
比较压力、惯性与融合方法,保持其他条件一致
如果有条件开展获准的人体研究,可以比较压力传感、惯性传感,以及二者融合的方案。三个方案应使用相同参与者和相同测试划分,避免融合模型获得更多数据或更充分调参。
测试可以围绕一个具体变化,例如不同速度或不同鞋型。研究重点不是所有情况下都获得最高分,而是判断融合在哪些条件下有帮助,在哪些条件下没有帮助,或者反而变差。
需要注意,某位参与者的一千个步态窗口不等于一千名参与者。如果要讨论对新人的适用性,应将人作为划分单位;若讨论跨天稳定性,还需把日期结构保留在分析中。随机打散全部窗口通常无法回答这两个问题。
结论应停在实际测量的地方
如果研究只与实验室步态参数比较,可以报告测量误差和一致性。没有临床诊断或前瞻性结局,就不要声称检测了疾病或预测了未来跌倒。一个装置能分辨两种行走方式,不等于能识别真实病患。
ENBM 的生物力学或传感方向可能适合这类测量研究;若贡献主要在电路、实时采集与功耗,EBED 更值得考虑。类别由贡献决定,而不是看设备放在身体哪一处。
若结果显示换鞋后表现下降,仍然可以形成有价值的结论:下降有多大,哪些测量受影响,哪种校准有帮助。后来使用类似系统的人,可以据此知道换鞋或重新安装后要检查哪些变化。
8.4 ACL:动作风险指标不能代替真实损伤
ACL 指膝关节前交叉韧带。此前的标题检索找到四个直接近邻,宽泛的运动与相关生物力学主题为五十个。少量标题并不能证明这是无人研究的方向;体育医学、生物力学文献与已有测量产品中还有大量相关工作。
从学生研究的角度,最需要澄清的是终点。你究竟在测落地时的膝关节角度、评价动作模式,还是预测未来损伤?这三个问题需要不同的数据。没有真实损伤结局,不能用动作代理指标直接训练一个名为“ACL 撕裂检测”的模型。
一个边界清楚的版本:低成本测量的误差
假设有合适的指导、参照设备和事前批准,可以讨论消费级视频或惯性传感器对某个动作参数的测量能力。首先把任务写小,例如某一规定动作中某个角度或时间参数的误差,再与合适的参照测量比较。
研究需要说明参照本身的误差、坐标定义和同步方式。相关系数高不表示两种方法读数相同:一种方法可能始终比另一种高十度,却仍然高度相关。因此,应同时观察偏差、误差分布与不同量值下的一致性。
拍摄角度、衣物遮挡、体型和动作速度都可能影响视频结果。与其一开始采很多动作,不如先选一个主要任务,把这些影响条件分开检验。每增加一种条件,都要考虑独立参与者和重复测量是否足够。
不要为了题目制造更危险的任务
关于疲劳或高风险落地的研究,需要专业人员判断是否适宜、怎样控制风险以及何时停止。本书不提供诱发疲劳或损伤的操作方案。学生完全可以选择已有公开数据、适当的模型,或在批准范围内的低风险测量问题。
若没有可靠参照设备,项目可转为研究不同标注者或算法之间的一致性,但结论也应相应缩小。不能因为设备不足,就把某个软件输出当成绝对真值。
这个方向与 ENBM 生物力学相连,也可能涉及 BMED。选择类别前,先完成一句结论草稿:“本研究在什么条件下,对哪种测量达到了什么程度的一致性。”如果这句话已经清楚,就不必用更大的医学承诺包装题目。
8.5 环境传感器:同型号为什么不能直接互换
低成本空气质量或水质监测器很容易形成演示:有读数、有曲线、有远程界面。但研究可以从更不显眼的问题开始——同型号的两个单元,是否真的给出可比较的结果?在第一周建立的校正,数周后是否仍适用?
此前的方向审查没有在特定标题检索式下找到完全吻合的直接近邻,但这不能证明“无人做过”。专业文献已经研究低成本空气传感网络的校准与迁移;学生应在明确条件下研究具体限制,而不是宣称发明了传感器校准。低成本空气质量传感网络校准研究
先获得真正可比较的参考
共址比较指让待测传感器与参考仪器在同一地点、同一时间观察尽量一致的环境。附近站点的公开数据可以提供背景,却不能自动充当严格校准真值:相距数百米的道路、建筑和排放条件可能不同。美国 EPA 的共址说明与性能评价资料可作为阅读起点。EPA 共址说明、EPA 性能评价资料
如果只能得到附近监测站的数据,就应把问题写成“两个地点的观测关系”,并讨论空间差异。不能在结论里突然改称“测出了传感器绝对误差”。
参考设备也不是一个只在采购表上出现的名称。你需要知道它测什么、多久输出一次、是否经过维护,以及数据能否合法获得。参考条件没有落实之前,不宜先购买大量节点。
一个可以拆开的比较设计
可以把问题分成三个层次:同一单元重复测量是否稳定,不同单元是否一致,校准关系随时间或环境怎样变化。它们分别对应重复性、设备差异和迁移问题,不能只用一条总相关系数概括。
例如,在有真实参考的条件下,用一部分日期建立校正关系,把之后的日期留作测试;再把某些设备完全留在训练之外,观察模型能否迁移。若随机打散所有小时数据,模型很容易在训练和测试中看到近乎相同的环境,结果会过于乐观。
评价时可以报告平均偏差、误差分布,以及高湿、低浓度等条件下的表现。若某种改进降低了平均误差,却在少数条件下发生很大的偏差,仍需讨论使用风险。只画平均曲线会把这些信息藏起来。
没有观察到漂移,也能回答问题
项目开始时可以设想长期漂移,但实验不应以“一定要出现漂移”为目标。若观察期内没有明显变化,应报告测量精度、观察时长和能排除的变化范围。设备间差异或湿度影响可能仍然是有效结果。
这类题目可落在 EBED 的传感器与信号处理,也可根据主要贡献联系 EAEV 或 ENEV。购买现成传感器并不妨碍研究,前提是新增知识来自清楚的评价,而不是把厂家例程换个界面。
8.6 低成本光谱:从“能看见谱线”到“别人也能测出来”
我们之前的标题检索找到八个与低成本、手机或便携光谱相关的直接近邻。早在 2014 年的档案中便已有手机光谱装置。因此,搭出一台装置是学习成果,却不能单凭这一点主张研究新颖。
更具体的问题是复现性:同一设计做出几台装置,测到的结果是否一致?拆装之后是否改变?换一个相机或光源,原来的校准还能不能用?你自己的装置测得不错,别人照着做也能测出来吗?这正是复现性研究要回答的问题。
把误差分开,而不是都交给算法
低成本装置的误差可能来自光路、样品位置、相机曝光、背景光和标定。先固定可以控制的条件,再逐项改变某个因素,往往比一次收集大量杂乱数据更容易解释。
波长准确度、分辨能力和强度响应也不是同一个概念。能看到两个峰,不代表能准确比较它们的强度;某条峰的位置接近参考,不代表整个量程都已校准。报告里应分别说明测了哪些性能。
一个教学设计可以比较同一装置的重复测量、不同装置之间的差异,以及重新装配后的变化。每个层次保留自己的编号与日期。若把它们全部合并求平均,读者便无法知道主要误差来自哪里。
先明确可接受的用途
教学级装置可能适合比较某种颜色变化,却不适合识别极低浓度物质。研究不需要证明它能代替所有商用仪器,只需把适用范围说清。用安全、适宜的标准或参考样品验证,具体选择应由具有相关经验的指导者确认。
如果主要贡献是光学结构与测量能力,PHYS 或 EBED 可能合适;若核心是分析方法的选择性、检测能力和样品干扰,则更接近 CHEM 的分析化学。不要为了获得医学背景而把未经充分验证的装置直接用于疾病筛查。
一份好的结果可以是:某个改动降低了装配误差,却没有改善强度稳定性。下一步因此十分明确。相比笼统地宣布“低成本、高精度”,这样的结论更容易被别人理解和复现。
8.7 遥感:地图画得漂亮,模型就可靠了吗
遥感方向的已有检索找到三十九个直接标题近邻,其中十三个来自 2024—2026 年。它们涵盖土地覆盖、水体、火灾、空气质量与农业等问题。制作某个城市的地图,已经不足以自动说明研究贡献。
第二章的农业排放和泥炭地修复案例提示了一个更深入的问题:模型在原来的地点表现好,换城市、换季节、换地表条件后会怎样?这个问题称为泛化,也可以直白地理解为“离开原来的数据还能不能用”。
测试地点应该真的没有被模型见过
如果从同一幅影像随机抽像素,训练点与测试点可能紧挨着。它们共享光照、地物和处理误差,因此测试结果未必代表对新地区的能力。按空间区域或日期留出测试,通常更接近相应的实际问题。
不过,按地区划分也不是万能答案。两个地区的类别比例、影像质量和标签标准可能不同。研究需要说明到底想测试什么变化,并分别考察主要误差来源。不能只看到掉分,就归结为模型“不够先进”。
参考标签也可能错
把一个现成土地覆盖产品当作标签,是方便的起点,却不代表获得了绝对真值。模型与产品一致,只能先说明二者一致;如果产品本身把某类地物标错,模型可能只是学会复制错误。
可以从产品彼此判断不同的区域入手,设计独立核验。谁来判读、依据哪一天的影像、怎样处理看不清的地物,都应留下记录。有限样本如何代表整个区域,需要在抽样时考虑,不能只挑容易判断或最漂亮的样点。
对学生而言,可以从两类容易区分的地物或一个小区域开始。明确记录无法确定的标签,比强行给每一个像素贴上确定答案更诚实。不确定样本怎样影响结果,也可以成为分析内容。
用失败位置解释结果
地图之外,应提供按类别的误差、不同地区的表现和典型失败图。例如模型主要在阴影中混淆,还是在季节变化后失效?小面积类别是否被总体准确率掩盖?这些问题能把一个展示项目变成方法评价。
类别选择也随主问题变化:研究地表或环境过程可能属于 EAEV,服务于修复方案评价可能属于 ENEV,研究通用算法本身则需要考虑 SFTD。选择能准确表达贡献的类别,比跟随一个热门名称更有效。
8.8 另外三个已有方向,什么条件下值得继续
此前还整理过氢能电催化、电池健康与边缘辅助设备等方向。它们并不因为列入题库就适合所有学生。下表把需要先落实的条件写在题目前面。
| 方向 | 可以缩小的研究问题 | 最先确认的条件 | 容易过度宣称的地方 |
|---|---|---|---|
| 氢能电催化 | 同一测试体系中,某项材料改动对性能与稳定性的影响 | 合适实验室、指导者、可比较的测试与安全条件 | 把单个电化学指标写成整个制氢系统更廉价、更环保 |
| 电池健康 | 预测模型对未见过的电池或工况是否可靠 | 数据许可、循环记录完整性、按电池划分的独立测试 | 把同一电池相邻周期的高预测分数写成普遍寿命预测 |
| 边缘辅助设备 | 在资源受限、信息不足时怎样识别失败并提醒使用者 | 明确任务、可控测试环境、适用的人体参与审批 | 把演示成功写成可保障真实使用者安全 |
电池方向可以采用公开循环数据,但必须保留电池个体信息。若同一电池的早期与后期记录随机分布在训练和测试中,就不能据此声称模型适用于新电池。健康状态、剩余寿命和故障预警也不是同一个目标,应先选定其中一个。
边缘辅助设备很容易强调“实时识别”,却忽略识别失败时怎么办。研究可以聚焦系统何时应该拒绝给出答案、怎样提示不确定性。评价需要同时记录任务成功与误导使用者的情况,而不只平均准确率。未经适当验证,不应让真实使用者在高风险环境中依赖原型。
氢能方向对实验条件的依赖较强。若条件不足,继续查阅可比较的文献数据、研究评价口径,可能比仓促采购设备更合适。复杂的材料名称不会自动产生清楚的研究问题。
选这几个方向时,最先要落实的是证据从哪里来。先确认参照测量、独立测试或必要指导,再决定题目规模,能够减少做了几个月才发现无法验证的情况。
8.9 给自己的题目写一页说明
在正式研究计划之前,先写一页能讲给同学听的说明。第一段交代一个具体困难:谁在什么条件下遇到什么问题。不要从“随着科技飞速发展”开始,也不要急着写社会影响有多大。
第二段介绍最相关的已有方法,指出你理解的限制。引用两三个真正读过的来源,说明它们在哪些条件下有效,以及你的研究准备比较哪一点。若只是个人猜测,就明确写成待检验的判断。
第三段用一个可以回答的问题收住题目。例如“在未参与校准的设备上,加入湿度变量是否降低后续日期的测量误差?”比“打造智能环境监测平台”更接近研究。
第四段写比较对象与主要结果。你准备与什么比,哪个指标决定主张是否成立,什么结果会使你接受原来的想法没有得到支持?不需要提前猜出最终答案,但要知道怎样判断。
最后一段写条件:数据从哪里来,设备与场所是否落实,是否涉及事前审批,学生承担哪些工作,最可能在哪一步受阻。这个部分不必写得好看,设备尚未借到、标签还未核实,都应照实写。
把这一页交给导师讨论时,你们就能谈具体问题。导师可以帮助判断方法与范围;学生仍应理解并决定自己要回答什么。正式研究计划、摘要等材料的 AI 使用要求,见第三章。
8.10 研究开始前,怎样做一次小规模可行性检查
可行性检查的目的,是发现核心测量能否成立。它不应被混同为可以绕过审批的“先试试看”。凡需要事前审查的内容,必须先完成适用程序,再开始相关研究活动。
如果使用公开数据,可以先核对许可、字段和标签,尝试复现一个简单基线。若连样本单位和目标变量都解释不清,继续训练复杂模型只会把问题藏得更深。
如果自制仪器,可以先检查输出是否随已知输入合理变化,重复测量是否稳定,记录是否能完整保存。若仪器常常丢失时间戳,应先修复记录,而不是急着扩大实验。
如果开展理论研究,可以先复核关键定义、重做已知小例子,并尝试寻找猜想的反例。发现猜想不成立不等于浪费时间,它可能指出更准确的条件。
小规模检查后,题目可能会缩小。例如原来想做跨城市预测,后来发现独立标签不足,于是改为研究一个地区的标签不确定性;原来想评估临床风险,后来发现只能可靠测量动作参数,于是转为测量效度。这类改变应如实记录,不能在最终报告中假装一开始就知道结果。
8.11 结果不理想时,怎样继续写出有用的研究
研究结束时,没有预期中的改进很常见。先判断是测量或实现存在问题,还是结果本身不支持假设。两种情况需要不同处理:前者需要修复或缩小证据范围,后者可能构成清楚的否定结果。
软件冷却案例就提供了一个例子:过热减少,但冷却使用增加。若作者只保留温度曲线,读者会误以为所有目标都实现了。把两项结果同时报告,才让后来的人知道需要如何调整控制目标。
若样本太少、误差太大,不能把“没有显著差异”写成“两种方法完全一样”。更准确的说法是,在当前样本和测量精度下,没有得到足够证据支持所设想的差异,并说明还无法排除多大的变化。
失败案例也应有组织地保存。记录它发生在什么对象、什么条件下,是否重复出现,与成功案例有什么不同。若失败来自一个稳定的条件,就可能形成比总体平均数更有用的结论。
写作时不必让每一页都看起来成功。把判断怎样随证据改变写出来,读者才能跟上你的研究过程。最后那张图也会因此更容易理解。
8.12 从这八章走回自己的研究
选题时,用第二章判断研究范围,用第七章查找已有工作与趋势,再用本章把问题缩小。准备实施时,回到第三章核对设计、材料与适用的规则;安排参赛时,回到第四章确认实际路径。
第五章的获奖案例适合在中途再读一次。第一次阅读容易记住题目和奖项,自己经历过采样、比较和失败后,会更关心作者为什么选择某种验证。读者能够提出的问题会变得更具体,这就是进步。
家长和导师可以帮助学生落实时间、场所与指导,但应让学生保有解释研究的责任。一个题目真正适合学生,应该能让他逐渐说清每项选择的理由,并在遇到新证据时修改自己的判断。
最后写在展板上的研究问题,可能已经与最初的兴趣句子很不一样。只要这个变化来自认真阅读、测量和思考,题目变小并不是退步。你终于知道自己能够回答什么了。